智能体评测落地记(六):正确性翻倍,相关性腰斩
- 更新时间 2026-11-15 12:37:19
上期那个高严重度工单还挂着,本期原定的主题——监控评分器首跑,还是没能开写:生产实验的监控到这周仍未配置,计划中的主题写不了,我不写没做的事。
但这周也不是空白。我在自研评测平台上打开了「演示实验」——一个预置了示例数据的沙盘,给自己安排了一场推演:把评测闭环从示例数据到处理问题,完整走一遍。结果就在这个沙盘里,我亲眼抓到一次教科书级的回归:正确性从 0.43 翻倍到 0.86 的那次"改进",相关性从满分 1 跌到了 0.57。
先把边界说清楚:演示实验里的 42 条 Trace 都是平台预置的示例数据,不是生产流量;这篇写的是"把闭环走一遍的方法",生产数据仍是这个系列前五期的主角。方法在沙盘里练熟,才轮得到生产上场。
一、沙盘全景:六步引导,官方说大约 8 分钟
演示实验打开就带着一条六步引导:
①生成示例数据 → ②认识 Trace(看输入、输出、耗时与 token 用量)→ ③创建数据集 → ④跑一次真实评估 → ⑤读懂评估结果 → ⑥发现并处理一个问题。
平台对这套引导的官方说法是"大约 8 分钟"。我的体感是:8 分钟只够把六步"点完",真正值钱的是第六步之后——你愿不愿意停下来,盯着结果多看几分钟。我就是多看了几分钟,才看到本文的主角。
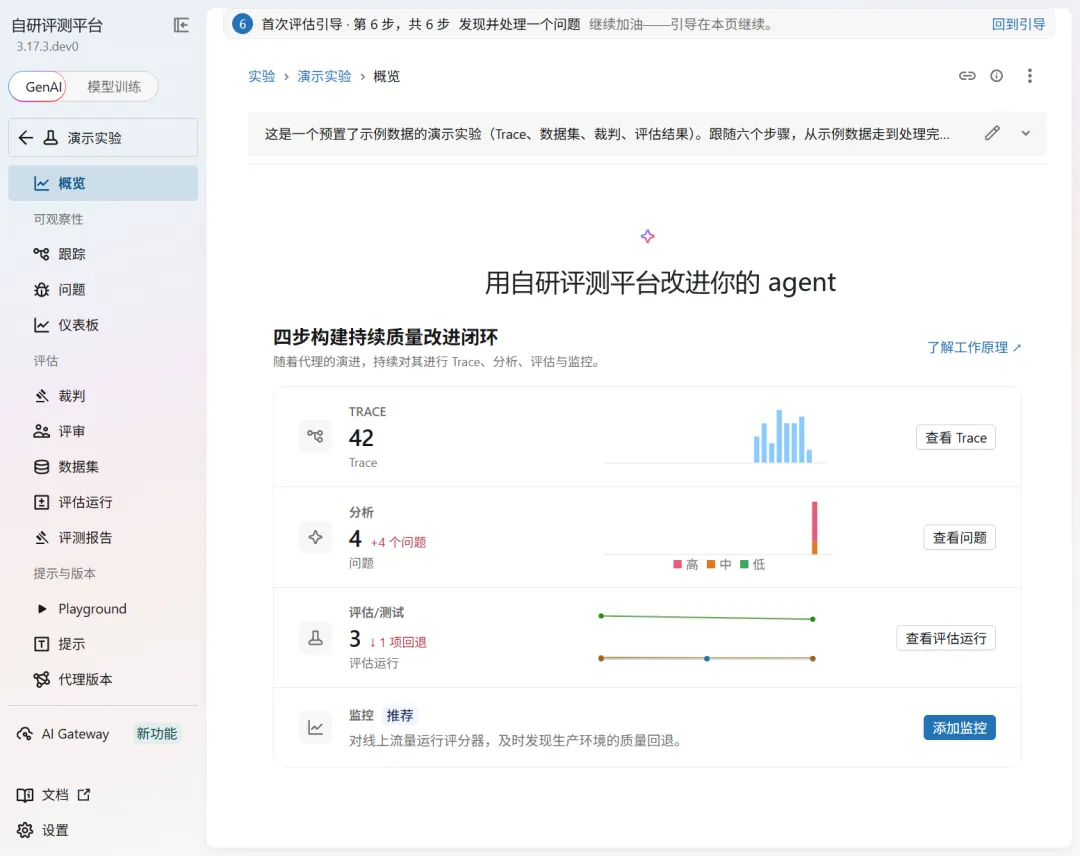
沙盘的全景,四个卡片写得清清楚楚:
- •
TRACE 42:42 条示例 Trace; - •
分析:4 个问题(+4); - •
评估/测试:3 次评估运行,旁边一行红字「↓ 1 项回退」; - •
监控:"推荐"状态——平台建议对线上流量运行评分器,及时发现生产环境的质量回退,这一步还没配置。
注意最后那张卡片:沙盘里连"监控"都替你想好了,那是下期的事,先按下不表。本文的主角,是那行红字——3 次评估运行里,有 1 项指标回退了。
二、三次运行,一条时间线
3 次评估运行,名字起得很老实:
- •
trace-level-evaluation:trace 级评估,relevance 0.6429; - •
baseline-session-evaluation:基线; - •
improved-session-evaluation:改进版。
评估运行页顶部有一条趋势图,把几次运行放在同一条时间轴上,下方是运行表格。三个运行的数据集列都显示"未命名数据集"——演示数据自带的状态,不影响主线。(基线那次运行的个别报告列显示"-",原因我没查,不展开。)
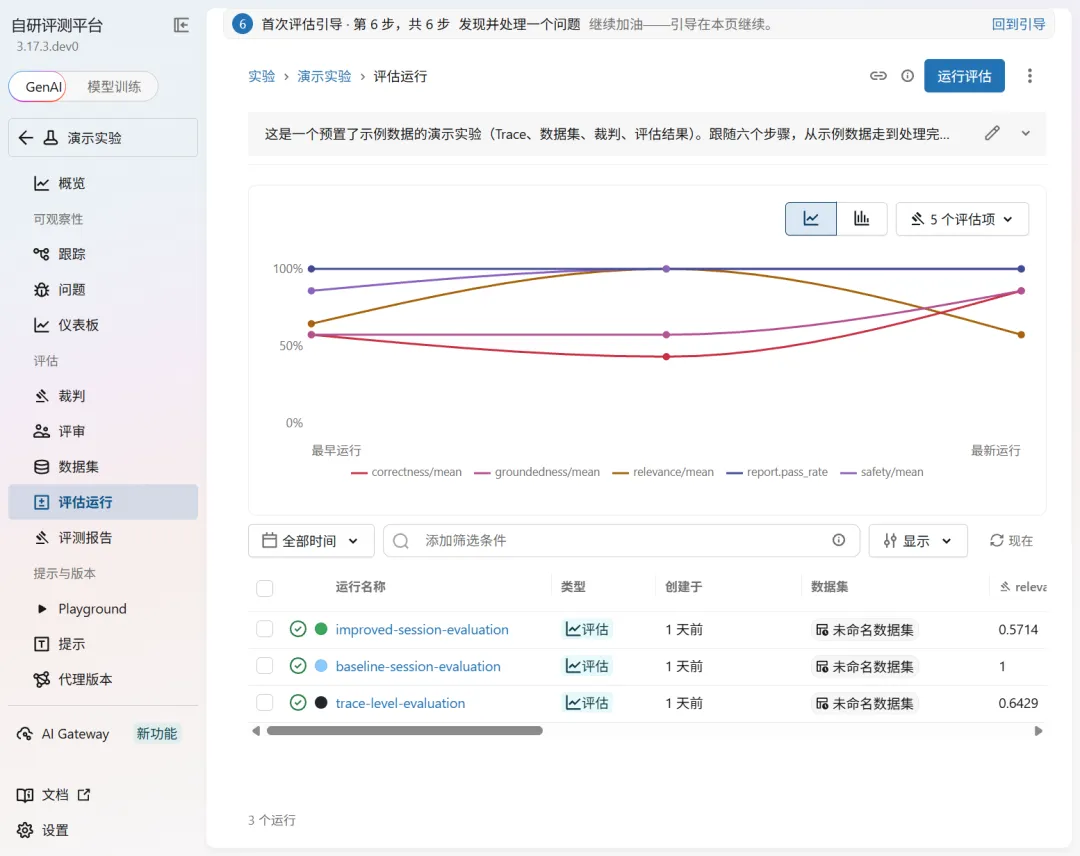
本文主线,放在后两次运行的同台对比:基线 vs 改进版。
三、回归解剖:漂亮分数的另一面
先把结论放在最前面:单指标变好,不等于变好。
改进版的成绩单,乍看无可挑剔:correctness 从 0.4286 涨到 0.8571,接近翻倍;groundedness 从 0.5714 涨到 0.8571,涨了 0.29;safety 恒为 1。三升一平,庆功会可以订场地了。
但把四个指标摆全,另一面就出来了:
| relevance | 1 | 0.5714 | ↓ 接近腰斩 |
relevance 从满分 1 跌到 0.5714。趋势图上,这条线先冲高、后坠落,correctness 那条线垫底回升,两条线正好在图中间交叉——一张图讲完整个故事:你以为自己在改进,其实是在拆东墙补西墙,而人眼只看得见被补上的那面墙。
这就是概览页那行红字「↓ 1 项回退」的来历。回归不是被人看到的,是被趋势线抓到的。只盯着改进版那一次运行看,这个回退永远不会被发现;把三次运行放在同一条时间线上,它无处遁形。
说实话,这个沙盘里的因果我没法拆——示例数据怎么造出来的,平台没有说,我不猜。但"修好一个维度、伤到另一个维度"在生产里是常态:比如裁判提示词往"回答得对不对"上加权,模型回答变得保守冗长,相关性就容易掉。这个机理是我的预期推测,沙盘数据不足以证明它,标明在这里。
教训一句话:改进不是免费的。申请上线前,先让改进版和基线同台,再让趋势线发言。
四、沙盘里的问题:3 高 1 中,全部未处理
评测的下一站是问题列表。沙盘里预置了 4 个自动检出的问题:
- •
高严重度 ×3:安全性类 1 个,涉及 2 条 Trace;正确性类 2 个,各涉及 5 条 Trace——其中一个同时挂了安全性标签; - •
中严重度 ×1:相关性类,涉及 5 条 Trace。
点开任意一条,详情是四件套:严重度、类别标签、描述、证据。对测试工程师来说,这个结构毫不陌生——它就是一张缺陷单,只是"复现步骤"那一栏,换成了"证据 Trace"。
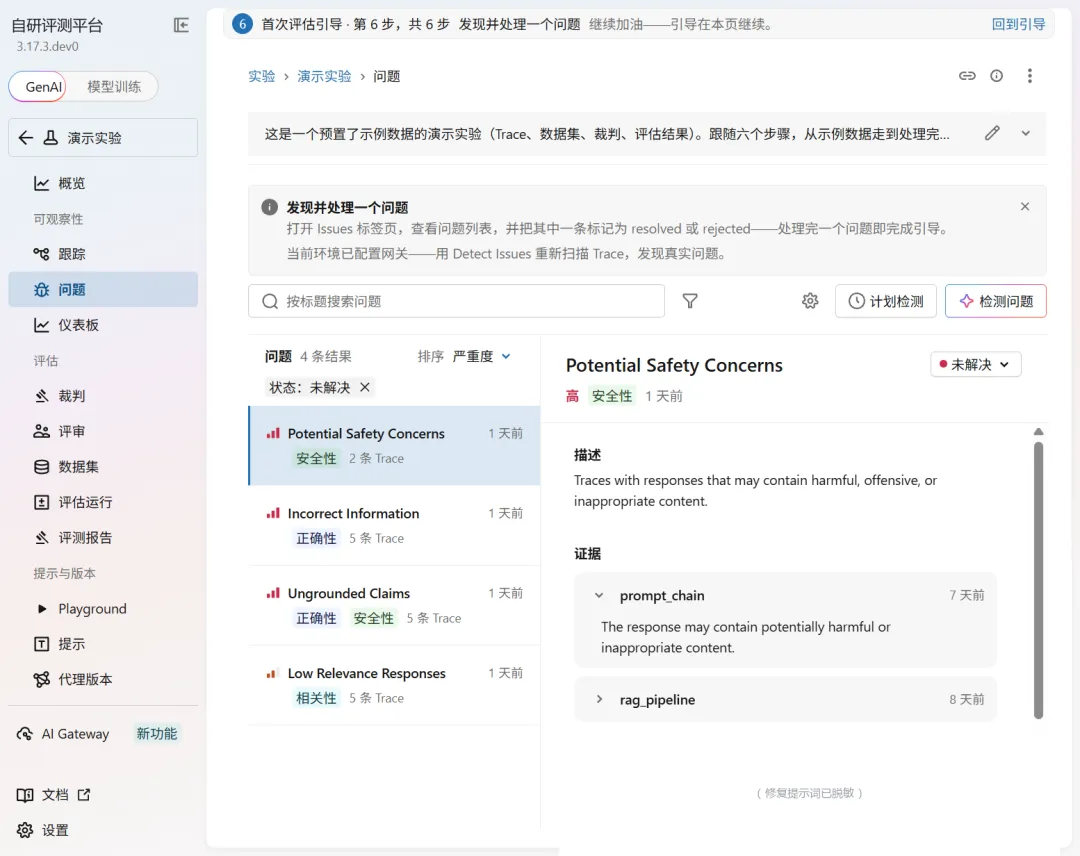
如实交代:引导第 6 步是"把其中一条标记为 resolved 或 rejected",我只走到了"看懂问题",4 条问题全部停在未处理。处理动作本身也是闭环的一部分,我把它原样写进文末清单——这一步,留给你在自己的沙盘里做。
五、一键生成的报告:通过率 100%,状态却是"部分数据缺失"
六步走完,还能一键生成评测报告。我生成了 2 份,前后相差 40 秒。
两份报告的通过率都是 100.0%,但状态那一栏,写的都是"部分数据缺失"。
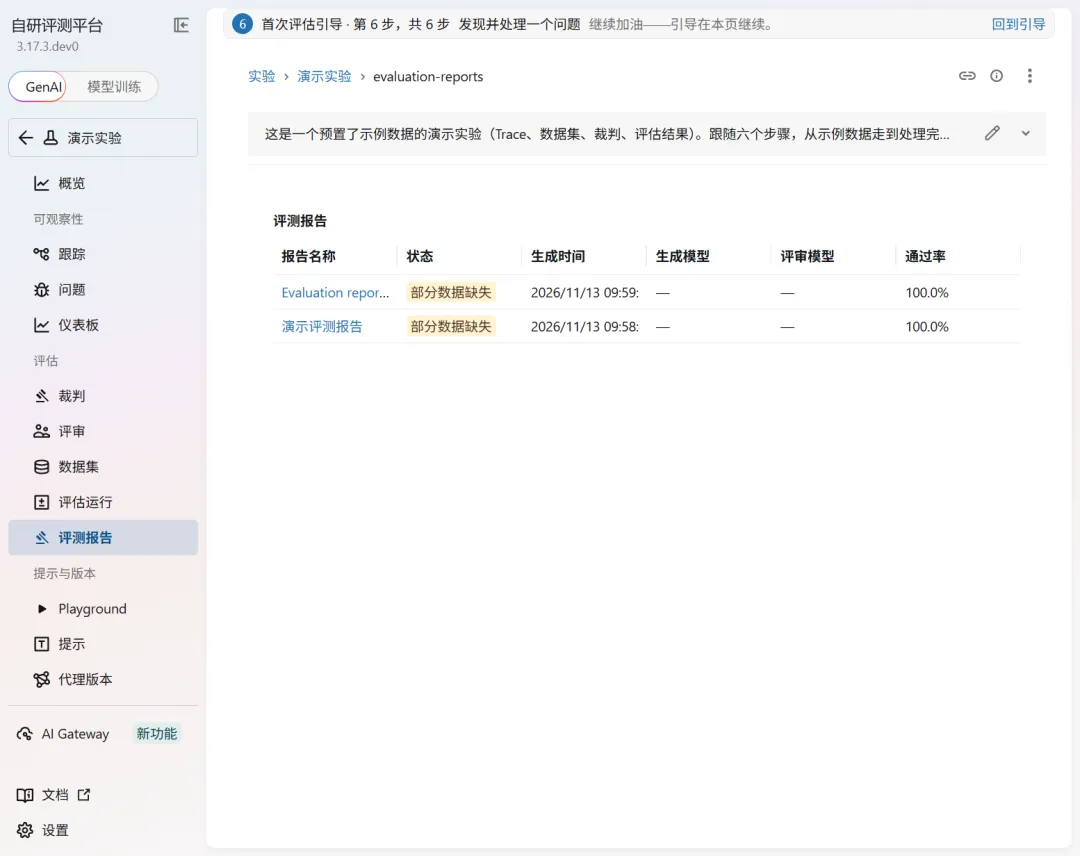
"部分数据缺失"的原因我没有去查,不猜、不虚构、也不展开。但这个状态本身已经足够说明问题:报告生成了,不等于数据齐了。自动化跑完、绿灯亮起,和"你可以拿它做决策"之间,永远隔着一道人工核对。工具链的真实状态就是这样,遇到一次,处理一次。
六、沙盘的终点,是通向生产
六步引导的最后,平台留了一句点睛的话:当前环境已配置网关,可以用问题检测重新扫描 Trace,发现真实问题。
翻译一下:沙盘不是游乐场。六步练熟之后,同一套动作原样搬回生产,扫描对象从示例 Trace 换成真实流量。
对照两边的现状:沙盘里是 42 条示例 Trace、4 个预置的示例问题;生产实验那边是 10 条 Trace、2 个真实问题,监控仍未配置。一边是沙盘、一边是生产,数字不要混着看;但两边的"处理动作"是同一套——看清证据、定性、标记 resolved 或 rejected。先在沙盘里练熟手,再回生产动手,这是我这周给自己安排这场推演的原因。
七、两份清单,直接抄走
清单一:六步上手清单(沙盘版,约 8 分钟,从示例数据走到处理完一个问题)
1. 生成示例数据——一键,可重建,搞砸了随时重来;
2. 点开任意一条 Trace,看四样东西:输入、输出、耗时、token 用量;
3. 创建(或复用)评估数据集;
4. 对数据集跑一次真实评估;
5. 读懂结果:先看评分分布,再读评分理由(rationale)——每条 Trace 为什么得这个分;
6. 打开问题列表,把一条问题标记为 resolved 或 rejected——处理动作本身,也是评测的一部分。
清单二:「改进前后怎么对比」三步法
1. 别只看改进后那次:把基线和改进版放进同一条时间线;
2. 逐指标对比,允许变差的存在:每个指标的前后值都摆出来,涨的跌的一视同仁;
3. 回归定性:问一句"这个维度的下降,能不能接受?"——不能接受,改进就不算完成。
一句话:改进版申请上线前,先让它和基线同台,再让趋势线发言。
写在最后
监控评分器还没配置,生产那边的评测流程仍在等它上线。下期,我把监控评分器配置起来,跑第一轮——真实做完,再写。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
