讲蒸馏那篇里我留过一句脚注:"前 120 题恰好偏难,所以基线看着低。"这句一直没验证。这次只把它当问题重切一遍——模型一个都没重跑,只改"从 400 题里取哪几题"。
摘要:只换评测集切法,"白盒比黑盒高 3.5 点"就变成"黑盒比白盒高 6 点";同一基座同批题跑两遍差 2.5 点;上一稿那句"前 120 题偏难"这次测出来不成立。附换考卷重切的做法、题量算法和一份考卷冻结清单。
太长不看版
- • 同一份结果文件,评测从 400 题切成前 50 题:未训基线 42.8%→42.0%(只差 0.8 点,看着很稳),但"白盒蒸馏减黑盒蒸馏"的差值从 +3.5 点翻成 −6.0 点——领先方换了边。
- • 两个符号都不显著(n=50 时 p=0.58,n=400 时 p=0.18)。所以不是"50 题测出了真相",而是小切片的符号本来就随机跑,拿哪个下结论都会翻车。
- • 切到 50 题,连"训练把模型弄坏了"都测不出来:黑盒少教材臂相对基线 −16.0 点、p=0.077(不显著);n=100 起才 p<0.05,n=400 到 p<0.00001。一个真实存在的负结果,被切片宽度吃掉了。
- • "前 120 题偏难"站不住:把 400 题随机无放回抽 120 题重算 2 万次,基线取前 120 题(40.0%)落在第 26.6 分位——正常抽样波动。但同一把刀在另一臂偏到第 2.8 分位(24.2% 对全卷 31.2%),偏不偏要逐臂量。
- • 同一个模型同一批题跑两遍也有 2.5 点抖动:基线两次分别 37.5% 与 40.0%,3 道题判分翻面、方向完全一致,配对 p=0.25。
- • 区间比小数点重要:n=50 时基线 95% 区间 29.4%–55.8%(宽 26 点),n=400 收到 38.0%–47.6%(宽 9.6 点)。这口径不只我在用——分数不带置信区间,等于没测。[1]
本文导读
一、我只改了一行切片 → 二、翻号那一刀 → 三、切掉显著性那一刀 → 四、"前 120 题偏难"我自己不认了 → 五、更狠的两刀:判分与重跑 → 六、到底要多少题 → 七、考卷冻结清单 → 八、要点回顾
一、我只改了一行切片
素材是我自己的蒸馏实验:7B 老师教 0.5B 学生,五组训练方式(未训基线、黑盒只学老师输出、白盒对齐老师的判断分布,后两类各再分少教材/多教材),最后统一在同一批 400 道题上逐题记下"对/错"。
逐题命中我原样存着(每臂一串 0/1、长 400),所以重切不用重跑模型:把前 N 题的命中重新平均,就是一个新分数。整个台架长这样——上面两格(模型、判分器)这轮一个字都没重跑,全部新增读数出自中间那层算术:
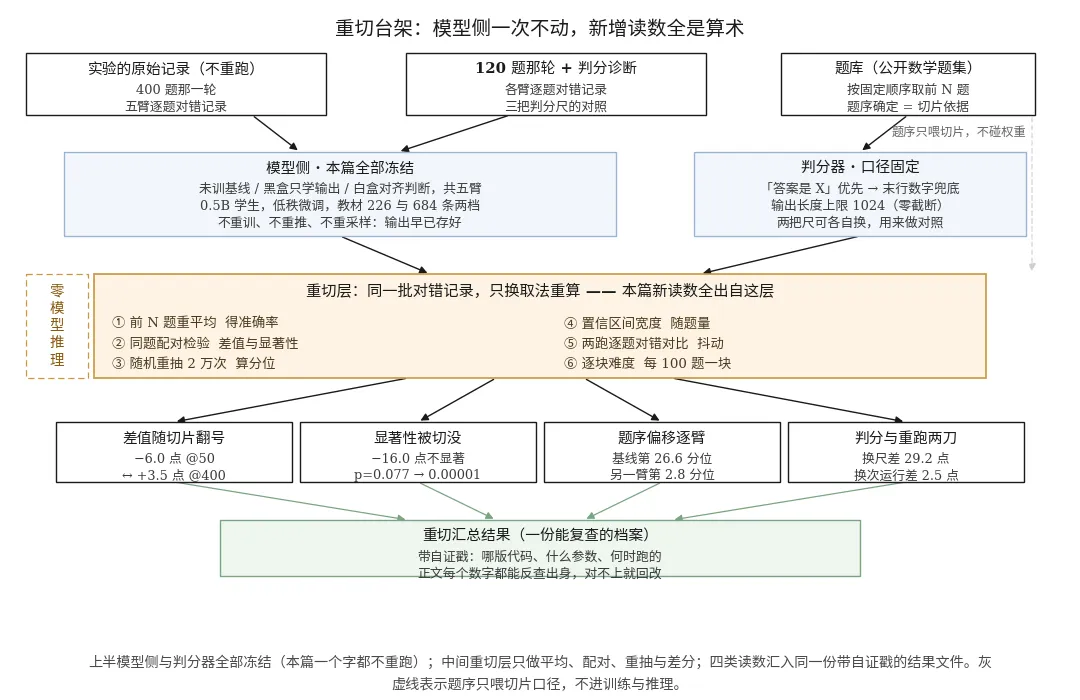
重切台架:模型侧冻结,只有"取前 N 题"这一步被改动
# 重切的核心只有三行:把存好的逐题命中按前 N 题取一段for n in (50, 100, 150, 200, 261, 320, 400): head = hits[:n] # hits 是存好的 "01001..." 串,零模型推理 print(n, round(100 * sum(head) / n, 1))
各臂准确率(%):
单看基线(42.0 对 42.8)会觉得"挺稳"。但平均值稳不代表差值稳——差值才是结论的载体,而它由翻转题决定,题数一少就没人撑着了。
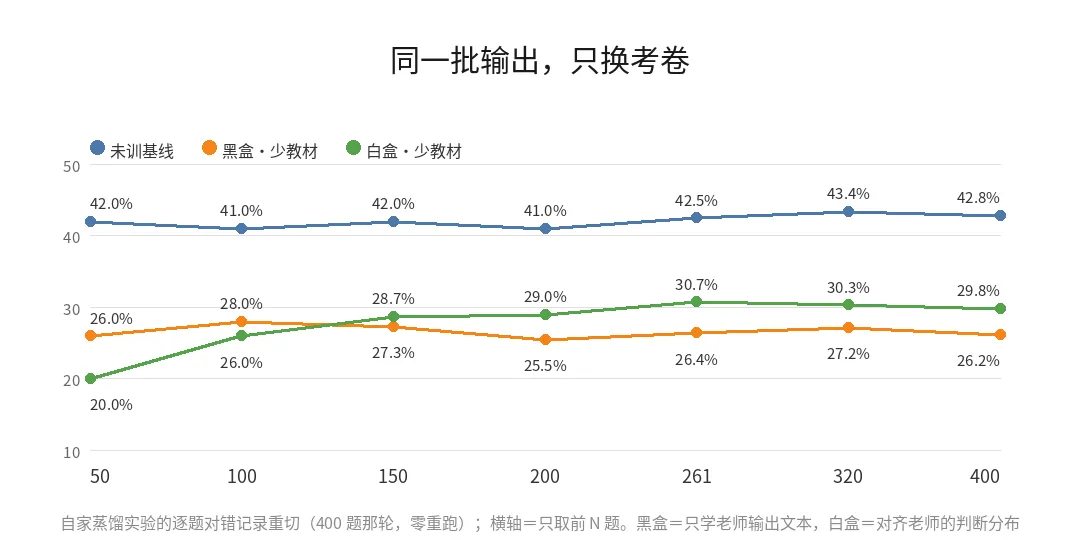
同一批输出,只换考卷
二、翻号那一刀
拿"白盒·少教材"减"黑盒·少教材"。这两臂教材条数、训练配置、评测题集全同,唯一区别是学老师的写法还是对齐老师的判断:
前 50 题说"黑盒赢 6 点",全 400 题说"白盒赢 3.5 点"。符号反了。
多教材那一对也演了一遍,只是幅度小:前 50 题黑盒领先 4.0 点、前 150 题黑盒领先 4.7 点,到全 400 题变成白盒领先 0.5 点(p=0.92)。
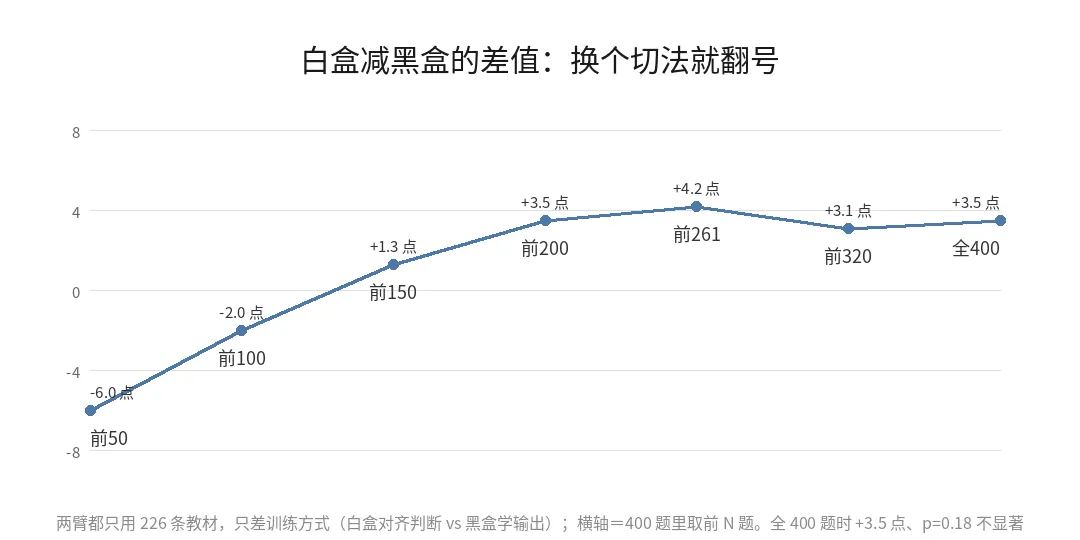
白盒减黑盒的差值,换个切法就翻号
注意两栏的 p 都远大于 0.05,所以没有哪一种切法测到了真相。诚实的读法是"这个差值测不出显著",于是它在任何切片上的符号都不该被写进结论。
这也是我要自纠的地方,而且不止一处。蒸馏那篇我写的是"白盒 KL(拿老师内部判断分布做对齐)相对黑盒 SFT(只拿老师输出的文本做监督微调)+3.6 点"。那个 3.6 是 29.8 减 26.2 得来的——两个已经四舍五入到一位小数的百分数相减。用逐题命中直接算:29.75% − 26.25% = 3.5 点。数字不大,但方向是我这篇正在批评的那类毛病:先丢精度、再做比较。同一篇里它还留了个带正号的数在表上,足够被谁截出去引用三十天。
三、切掉显著性那一刀
上一节是"没差异被切成有差异"。反过来更贵:真实存在的差异,被小切片切成没差异。
学生蒸完比不蒸还差,这件事在我这组实验里一直是负的。把它相对未训基线做同题配对,随切片宽度的读数是:
两个黑盒臂在 50 题上都是"看不出差异"。负结果被切片宽度藏起来了——和我在蒸馏篇里写过的那句"怎么判分本身就能把负结果藏起来"是同一类事,只不过这次的凶手不是正则,是 n。
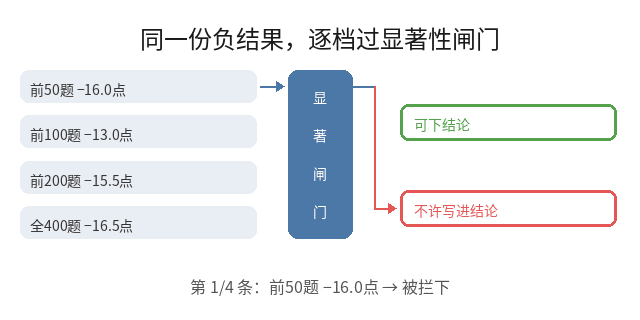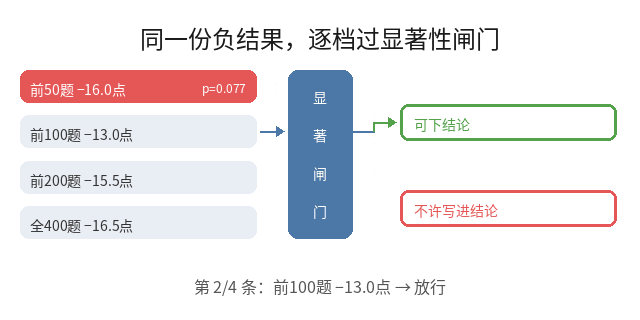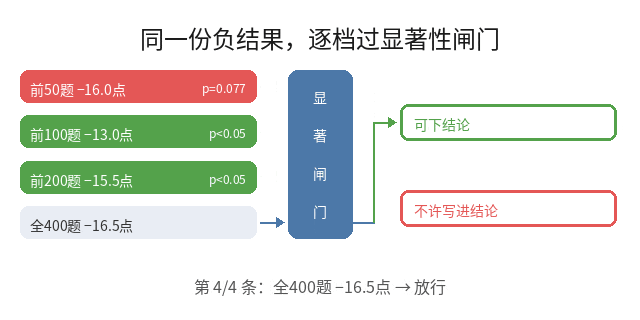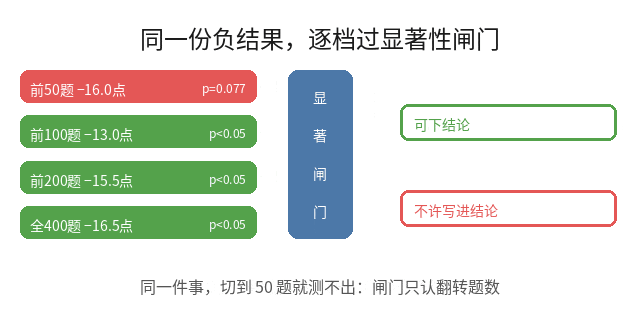
同一份负结果逐档过显著性闸门:只有前 50 题那档被拦下
差异的来源很朴素:配对检验只数翻转题。n=50 时黑盒少教材臂只剩 16 对(12 道基线对学生错、4 道反向),n=400 变成 132 对。信息量差 8 倍。这张检验器本身就是一张网络——切片变小,是传上去的翻转题变稀疏,不是数据变干净:
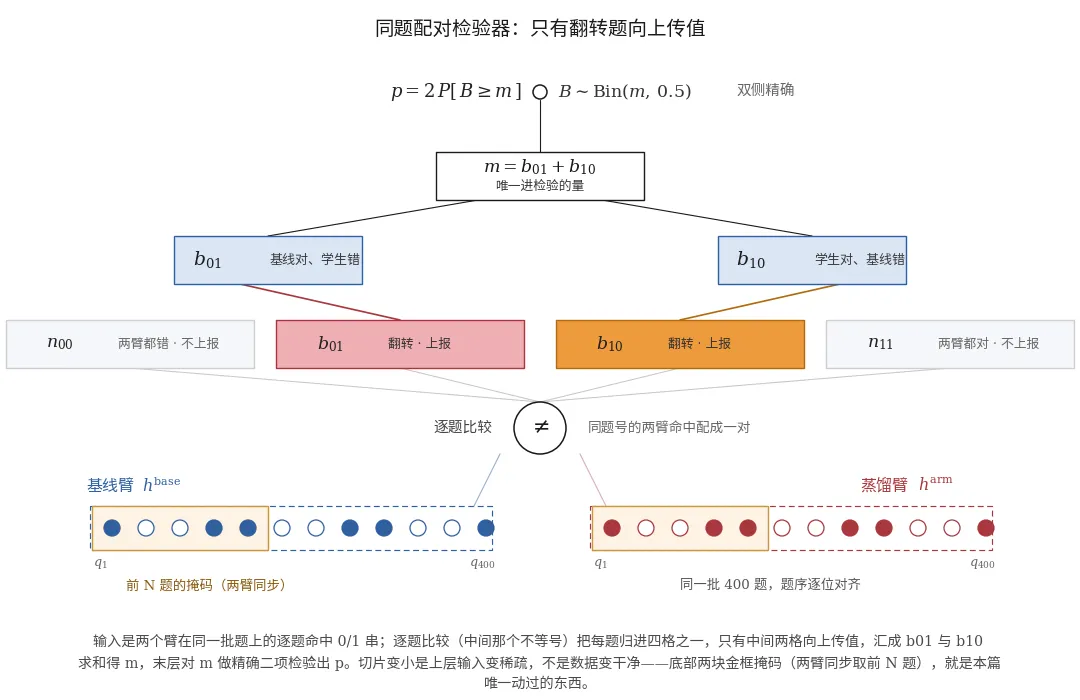
同题配对检验器:命中向量过比较门,只有翻转格向上传值
四、"前 120 题偏难"我自己不认了
蒸馏篇里,基线从 42.8%(400 题)掉到 37.5%(120 题),我当时写的是"前 120 题恰好偏难"。这次把它当假设来检验:如果题序真的偏难,"取前 120 题"就该明显落在随机抽样的尾部。
做法:每个臂把 400 题随机无放回抽 120 题、重算 2 万次,看"前 120 题"那个分数排在哪个分位。
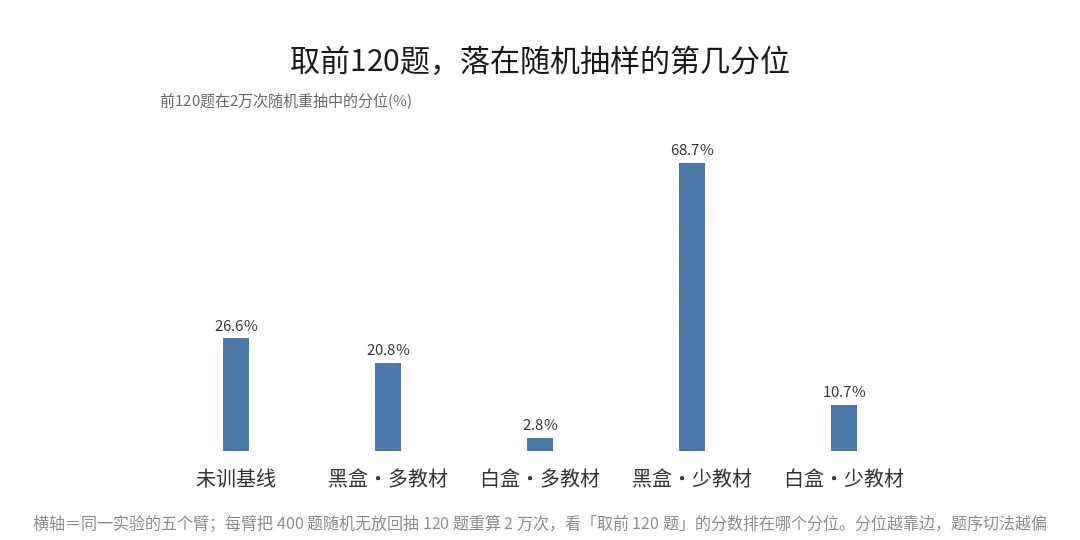
取前120题落在随机抽样的第几分位
基线那次偏移(42.8→40.0,2.8 点)落在第 26.6 分位,距中位只差 0.7 个标准差(这批量下超几何标准差 3.8 点)——就是正常抽样波动,不是题序变难。我上一稿那个解释,被自己重切翻了。而逐块看基线也支持这一点:第 0–99 题 41.0%、100–199 题 41.0%、200–299 题 49.0%、300–399 题 40.0%,中间那块高 8 点,前段根本不难。
但同一把刀下别的地方很偏:白盒多教材臂的前 120 题在第 2.8 分位(偏 7.0 点),黑盒少教材臂反而在第 68.7 分位。"偏难"连方向都不统一,它是逐臂的属性,不是这张卷子的属性。
能留下的结论只有一句:取前 N 题不是随机抽样,它自带一个你不知道方向的偏移;偏多少,只能在有全卷命中时逐臂量出来。
五、更狠的两刀:判分与重跑
判分口径。 还是那批 120 题、同一份输出,只改"怎么从文本里读出答案":
只认中文标记,基线被判成 5.8%,于是"学生 24.2% 远胜基线 5.8%"——一个完全反向的结论,零成本生成。原因不神秘:基座答对时用的是英文格式(Therefore, the answer is \(1260\).),被我自己写的正则判成了无效作答。
重跑抖动。 同一个未训基座、同一批 120 题、greedy 解码(不做采样),两次独立跑分给出 37.5% 和 40.0%。逐题比:3 道题翻面,而且方向完全一致——都是后一次对、前一次错,反向一道没有,配对 p=0.25。批内 padding 和浮点累加顺序就足够造出这个量级。
所以"比上次涨了 0.8 点"这种句子,在 120 题的卷子上没有任何分量。
切片、判分、重跑这三刀指向同一件事:分数不是模型的属性,是"模型 × 题集 × 判分 × 这一次运行"四者的属性。
六、到底要多少题
给一个能自己算的判断,别靠感觉。
第一步,先算你的误差条。 n 题里对 k 题,95% 区间的宽度大约:
按 p≈0.42 代:n=50 宽 26 点,n=120 宽 17 点,n=400 宽 9.6 点。想稳定分辨 3 点以内的差,单组区间得比它窄一半以上——这时 400 题都还勉强。
第二步,比差值一律同题配对。 别看"两个区间重不重叠"。同一批题上两臂绝大多数结果相同,只有翻转题携带信息,用精确二项(McNemar)只对翻转题检验。我这次 n=50 剩 13–17 对翻转、n=400 有 120–132 对,显著性从 0.077 走到 p<0.00001,全部差别就在这儿。
第三步,把切法当变量测一次。 这一步免费:只要有逐题命中,跑一遍第四节那张分位表,就知道"取前 N 题"偏了几个点。偏超过 1 个标准差,这份评测得重做。
这套做法不是我自创的口径。给评测分数配误差条、按题聚类估方差、先算样本量再跑评测,外部已经有相当明确的操作指南。[1]
七、考卷冻结清单
写差值之前逐项打勾,缺一项就别下结论:
前三行是我反复栽的坑(长度上限把基线压低过、正则把基线打成 5.8% 过)。最后两行是这次新增的——切片偏移和重跑抖动,我以前完全没管。
八、要点回顾
- • 只改"从 400 题里取前几题",白盒和黑盒谁领先就换了边(+3.5 点 ↔ −6.0 点);两边都不显著,所以哪边都不许写进结论。
- • 切到 50 题,能把一个 p<0.00001 的真实负结果读成"看不出差异"。汇报里最贵的一刀是切片宽度。
- • "前 120 题偏难"这句我上一稿用了,这次量出来不成立(第 26.6 分位);但同一切法在另一臂偏到第 2.8 分位——偏移逐臂,不是题目的固有属性。
- • 判分正则能把"学生比基线差 10.8 点"读成"学生比基线好 18.4 点",换次运行能造出 2.5 点。分数属于"模型 × 题集 × 判分 × 这次运行"。
- • 三步自证:算误差条、同题配对、把切法当变量重测一遍。最后一趟不用重跑模型,只要你把逐题命中存下来。
你上次汇报的那个提升,用的是同一批题还是新抽的一批? 报个大概就行:多少题、差几点、有没有做配对。留言里出现最多的那一类,我挑一种单独扒一次——不承诺篇名,得先看有没有共同缺口。
