上周陪一家制造企业开验收会。系统是他们自己搭的,跑了两个多月。业务负责人第一个发言:挺好用的,就是不知道该算不算通过。技术负责人说功能清单都实现了;业务负责人说有三个场景还得人工兜底。会开到第二个小时,问题还是那一句——什么叫合格。
这不是技术问题。项目做出来了,尺子没做出来。而尺子这件事,等到验收会上才想起来,基本已经晚了:能改的都改完了,剩下能争的只有形容词。真正的尺子是一套提前出好的题——工程圈管它叫评测集。
先把判断放这里:验收单上写不出可测的三句话,这个项目就还没有真正上线。
一、验收单上最常见的几个词,一个都不可验收
功能可用、响应及时、效果良好、体验流畅、基本满足、后续优化——这几个词我在验收单上见过太多次。它们不是谎话,问题是不好测:谁来测、拿什么测、测到什么程度算过,全靠现场商量。商量出来的结论,通常取决于谁嗓门大、谁更急着结项。
评测集,英文叫 Evals。说白了就是一套提前写好的题,每道题配一个标准答案,跑一遍就知道这套东西到底行不行。做模型的人早就这么干了,做业务系统的人还没养成这个习惯。
央媒也在讲这件事。光明日报 11 月 6 日的评论说得很直接:模型投入使用后,往往与行业数据、业务规则、工具系统共同构成一个完整系统,所以评价的对象应当是整个系统而不是单个模型,评价过程应当贯穿采购、验证和运行全过程,而不是一次测试或一场演示;产品选择和项目验收要建立在真实效果上,而不是榜单排名、厂商演示和纸面指标(来源:光明日报,2026 年 11 月 6 日)。
行业里已经有人这么干。电力系统的做法是从历史工单、缺陷记录、调度日志里抽真实问题,配上专家标注的参考答案,用这批题去检验输出能不能用;同时对答案加了一条硬要求:必须说得出出处、追得到条款,追不到的一律转人工(来源:中国能源产业发展网,2026 年 11 月)。这条要求牺牲了一部分自动化率,换来的是可用。
二、验收会吵起来,多半是三个错位
第一个错位,验错了对象。多数验收单验的是「这个模型答得好不好」,可上线之后真正跑的是「这条流程走不走得通」。举个常见的:跨系统对账,先取数、再比对口径、最后把结果写回。单看每一步都对,跑到第九步抓了上一版汇率,回滚时才发现中间没人设检查点。单步越稳,越容易让人以为整条链也稳——串起来是会打折的,步数越多,链路级成功率掉得越快。
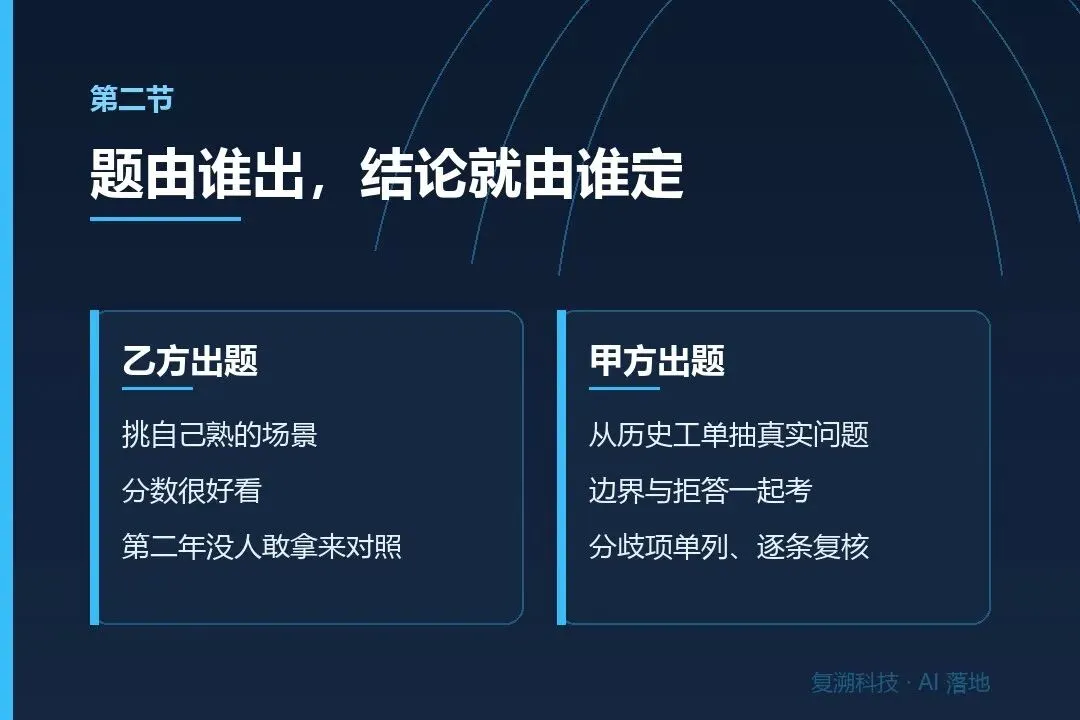
第二个错位,出题权错了。题由乙方出,等于让自己判自己的卷子。乙方不会故意放水,但出题的人天然会挑自己熟的场景、自己调过的样本。所以题得甲方出,或者双方各出一半,分歧项单列、逐条复核。单方打分的验收报告,到第二年想拿来做对照时,没人认。
第三个错位,把验收当终点。验收那天通过,只说明这套东西在那批题上通过。业务口径会变、政策会改、接口会换,三个月后同一批题再跑,分数未必还在。所以验收单上还得多一行:多久复测一次、每次换多少题、换模型或改流程要不要全量回归。
顺带说一句标准。大模型是有国家标准的,GB/T 45288.2-2025《人工智能 大模型 第2部分:评测指标与方法》2025 年 2 月就已实施(来源:全国标准信息公共服务平台)。但它给的是通用模型的评测指标和方法,能告诉你该怎么测,替不了你出「你们公司怎么算合格」的那些题。这套题,最后还得企业自己动手出。
三、三条路,三张验收单
不管走哪条路,有一件事共通:题由甲方出。这一条定下来,后面三张单子才谈得上。
自己搭,验的是养得起。断网跑一遍——拔了网线,主流程还能不能走完;只把工具放本地、推理还挂在外部接口上,不算数。换个人试一遍——不同岗位的账号问同一个问题、下同一条指令,结果该不一样。日志自己还原一次——不问供应商,让审计的人从后台自己查出「某天某人让它做了什么」。最后写清谁值班:漏洞处置、权限复核、模型升级,各由谁接。
买现成,验的是换得掉。一批题换一家跑——同一套题给第二家答,分数差多少;差得离谱,说明你现在的好成绩是场景挑出来的。要一份导出清单——配置、知识条目、题目、日志能不能带走,带不走的东西等于押在对方手里。再问一句升级怎么回归:版本更新后旧题重跑谁做、跑不过怎么办。
找人一起做,验的是接得住。交付物里必须有题——不只是代码和文档,还要那套题和每题的标准答案。规则要写成文档——为什么这么判、例外怎么处理,写在纸上而不是在谁脑子里。最后做一次交接演练:乙方不在场,客户自己的人独立加一道题、改一条规则、跑一遍。
这三张单子背后还是那句老话:先拆流程,再选模型。这次往前再推一步——先拆流程,再定合格。流程拆不到动作级,「合格」就只能写成形容词;拆到了动作级,合格自然变成一句可测的话。
政策方向也在这儿。工信部 2026 年 9 月印发的《「人工智能+软件」专项行动实施方案》提出,软件服务要从「产品交付」转向「价值交付」,产品环节要「行为可控、全程可溯」(来源:工业和信息化部,2026 年 9 月)。价值交付没法靠一场演示证明,只能靠一套题反复证明。
四、边界:这几件事我们不代劳
不替客户定合格。什么叫合格是业务口径,只有客户内部说得清——哪些错可以容忍、哪些错一次都不能出,这是业务负责人的判断,不是我们的。
不承诺分数。题一起出,分是系统跑出来的。我们能保证题出得公平、判得一致,不能保证跑出来是多少。任何写死分数的承诺,最后都会变成验收会上的争吵。
评估只看题面和流程,不看数据内容。客户的具体数据不出域,也不进我们的系统;我们关心这道题该考什么,不关心答案里有什么。
AI 不能碰什么:谁有权按停、出了事谁签字,这两件事必须在动手前就写进验收单,由人定、由人担。人工闸口不事先约定,等于把风险留给当天值班的那个人。
一句话收口:验收不是给项目打分,是给这件事定一把以后还能用的尺子。
周六接着说下一步:验收单签完就锁进抽屉,是这类项目最常见的第二次失败。一次性验收和周期复测,差在哪。
想聊聊你的场景,扫码找我们
不确定 AI 该从哪个环节切入、值不值得做,加微信把现状说清楚,我们先帮你把问题拆开看一遍。