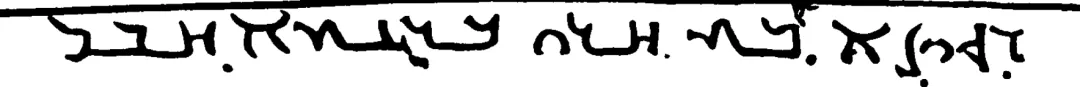大家好,我是 Sunday。
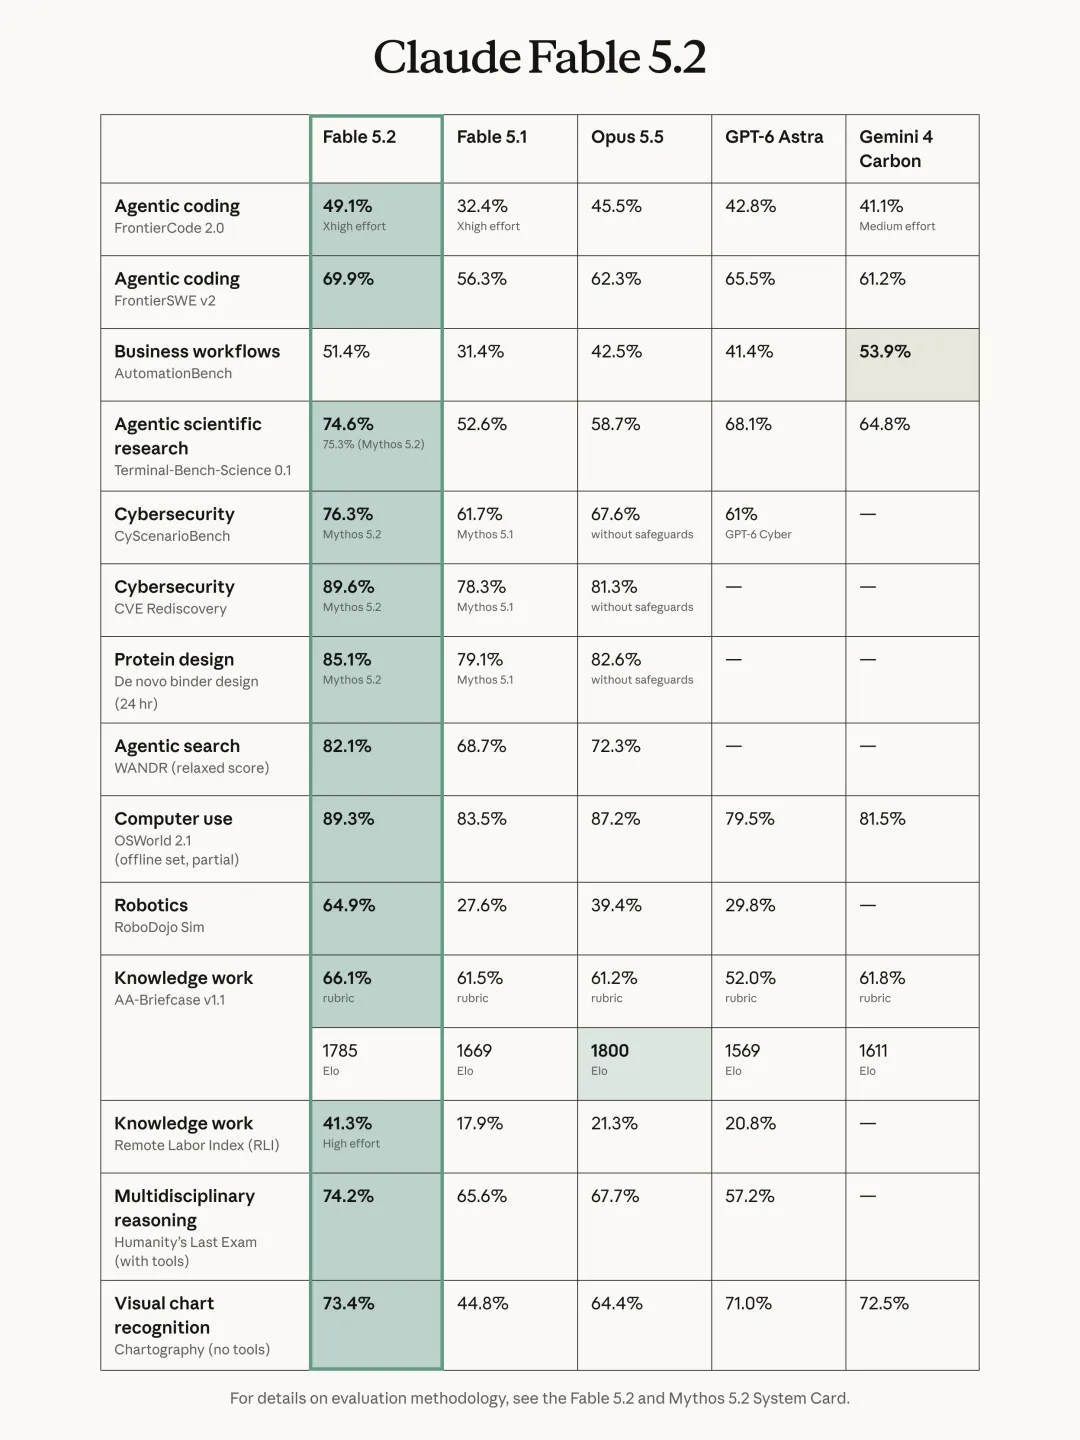
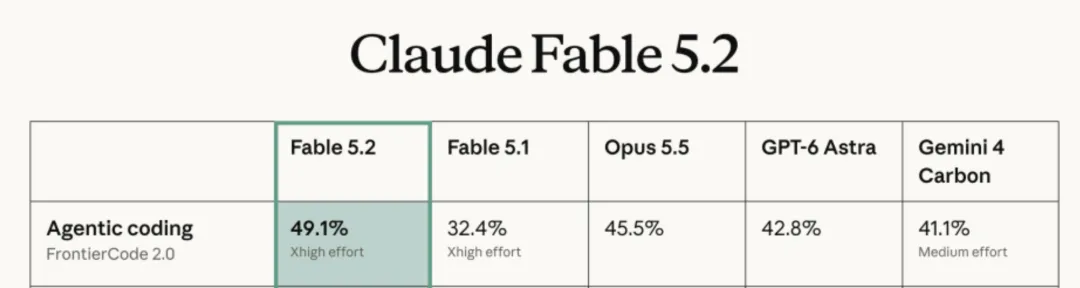
最近 Claude Fable 5.2 发布了,跟以前一样,官方又放出来一张特别长的跑分表
这种表大家应该见过不少次了。但很多同学每次看到它,感觉都差不多:每个数字都认识,放在一起却看不懂。
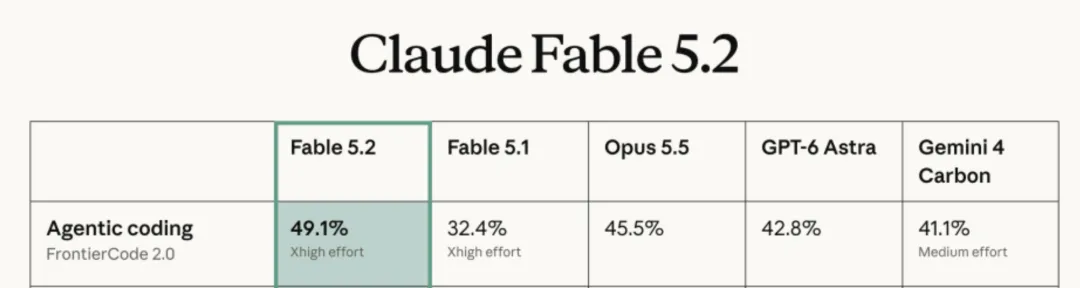
举个最直观的例子。第一行是 Agentic coding,Fable 5.2 排第一,成绩是 49.1%。
第一名,还不到 50%。
上学的时候考 49 分回家,估计少不了一顿揍。可在这张表里,49 分已经是全场最高了。
所以是 AI 还不够强,还是题目太难?这些分数到底该怎么看?为什么每家模型一发布,都要先晒出这样一张表?
咱们就一起来看看~
一、评测基准
大家可以先想一下,假设现在你开了一个饭店,有好几个厨师前来应聘,你也不知道哪个厨师做的饭好吃,那怎么办呢?
是不是得先给他们做一个 “考试”?
但是考试也不能让他们随便发挥,毕竟不同的人口味都有所不同,如果每个厨师只做自己最拿手的菜,那么是很难分辨出来谁好谁差的。
所以最好的方式就是,给让他们出题,让他们做同一个菜,然后看谁做的最好吃。
而所谓的 AI 模型的评测也是这个意思,想知道哪个 AI 更强,最直接的办法就是 让它们做同一件事,看谁做得好。
但只靠这一道题,说明不了太多问题。就像考试只出一道题:做对了可能是运气好。
所以比较靠谱的做法是:准备一大批任务,尽量覆盖各种情况。提前定好规则,怎样算完成,怎么给分。然后让所有模型在同样的条件下做同一套题,最后比较成绩。
这一整套 “任务 + 评分规则”,就叫 Benchmark,也就是:评测基准。
你可以把它理解成一套专门考 AI 的试卷。只不过这些试卷形式五花八门:有的让它答题,有的让它操作软件,还有的直接丢给它一个项目,让它自己想办法做完。
回到图里的第一行:
左边的两行字,一个是方向,一个是试卷名。
- 上面的 Agentic coding 是考察方向:让 AI 自己动手写代码
- 下面的 FrontierCode 2.0 是 具体的测试名称,2.0 是版本号
这里多解释一下 Agentic 这个词,因为后面它还会反复出现。
你可以把它理解成:给 AI 一个目标,让它自己把事做完。 它要自己找资料、调用工具、决定下一步做什么,出了问题自己调整。
右边的几列,是各个模型的成绩。
看表的基本方法就这些。
那么接下来咱们就来看看这些测试分别考的是什么。
二、这些测试,分别在考什么?
Humanity’s Last Exam(HLE):人类最后的考试
这个名字听起来有点吓人。一句话解释,那就是:把多个学科的高难度专业问题放在一起,看 AI 能答对多少。
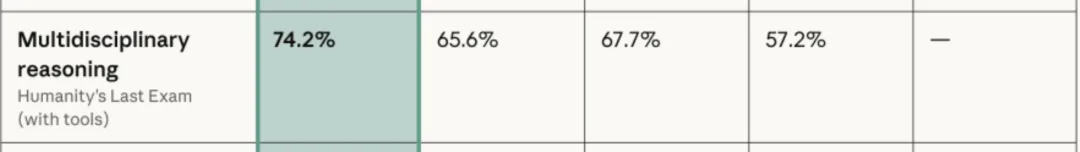
图里 Fable 5.2 的 74.2%,这次就是大家比较熟悉的答题准确率了。可以粗略理解成,在这套题和本次配置下,平均每 100 道题答对约 74 道。
而这些题目则是一套由各领域专家出题、审核的测试,共有 2500 道题,涉及数学、科学、人文等不同学科。
里面的题有多专业呢?
举个例子哈,它里面有一道题是这样的:
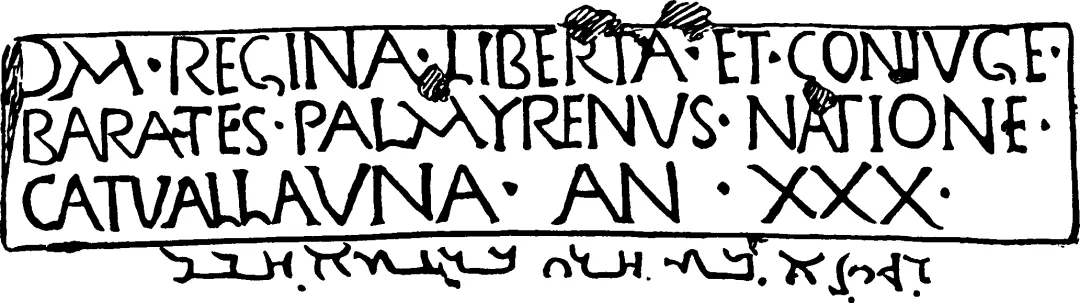
给出古代墓碑铭文的图像和文字转写,要求翻译其中的帕尔米拉文字。
而这个铭文,它是长成这个样子的。。。
HLE 官方题目配图:罗马墓碑铭文好像看着也不是很难的样子,但是,如果我告诉你他真正要翻译的是最底下的那块文字呢?
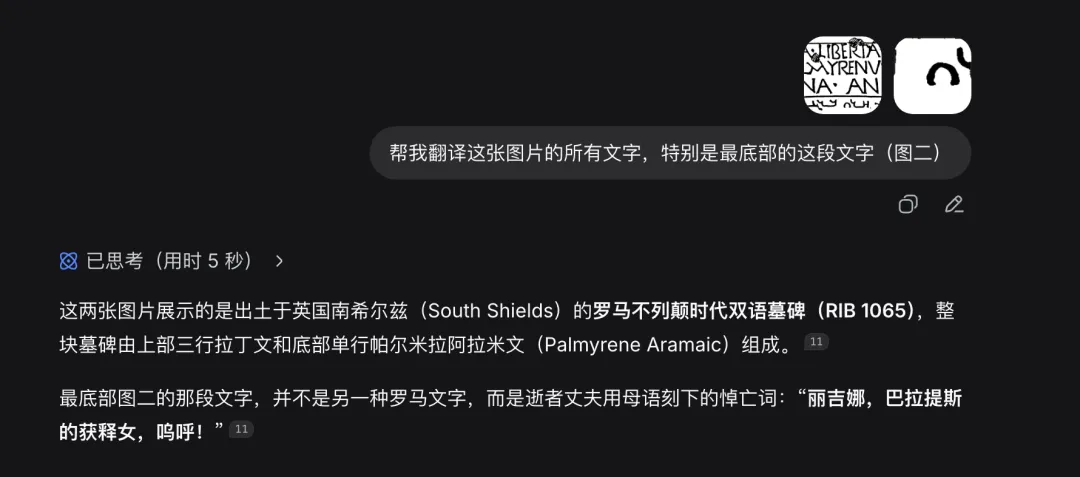
我尝试使用 DeepSeek 对这段文字进行了翻译
而这张图的标准答案应该是:
Regina, the freedwoman of Barates, alas.
蕾吉娜,巴拉特斯的获释女奴,哀哉。
这样看好像 DeepSeek 的表现也非常好~
但是我们需要注意,在评测中会有一个前置条件,那就是:with tools,允许使用工具。
没错,这次 AI 可以搜索网页、读取网页内容,也可以运行代码辅助解题。像考试时允许查资料、用计算工具,和只能直接作答,是两种不同的考试条件。
当然,允许搜索不等于可以直接抄答案。官方测试会屏蔽已知讨论 HLE 题目和答案的来源,并检查相关情况。
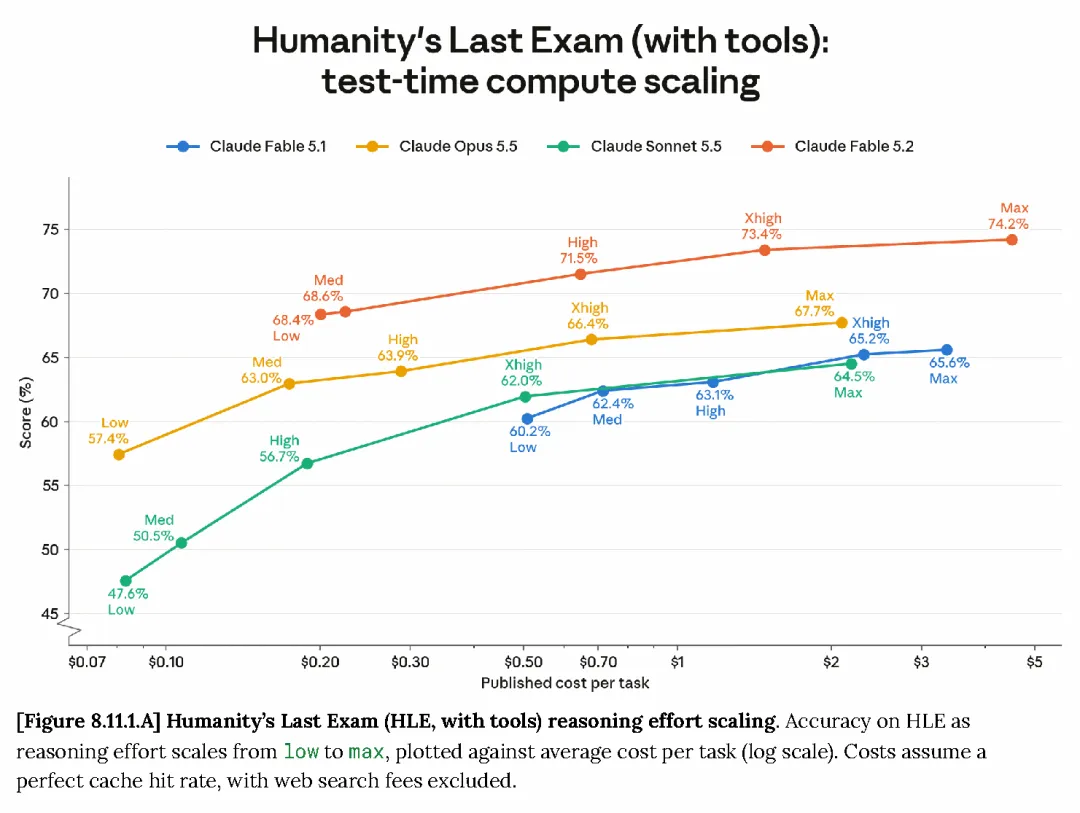
下面这张图展示的,就是允许使用工具时的成绩:
HLE:允许使用工具时,不同模型及推理档位的得分右侧 Max 档位下,Fable 5.2 是 74.2%,Opus 5.5 是 67.7%,上一代 Fable 5.1 是 65.6%。
橙色线上还有几个更低的分数,它们不是其他模型,而是 Fable 5.2 在不同推理档位下的成绩。同一个模型,给的思考预算不同,结果也会不同~
FrontierCode 2.0:前沿代码测试
一句话解释:给 AI 一个真实的软件项目和一条修改需求,看它交上来的代码,能不能达到项目维护者愿意直接合并的标准
这句话可能看着有点绕,不过没关系,咱们来解释一下。
假设公司来了个新同事,你让他给记账软件加一个“导出表格”的功能。
他很快交了活,导出也没问题。可你一试才发现,原来的记账功能打不开了。
这活你收吗?肯定不收。
FrontierCode 考的就是这件事:AI 改完的代码,项目负责人愿不愿意直接收下。
题目来自真实的开源项目,由维护这些项目的开发者亲自出题、定标准。难的地方在于,需求一般只写一半,剩下的要 AI 自己想。比如:别乱动无关的文件,沿用项目原来的写法 等等的。
打分方式也很像老员工审代码:
- 犯了大错,比如把原来的功能弄坏了:这道题直接 0 分
而 49.1% 的意思,指的是:按 FrontierCode 的评分规则,把满分折算成 100 分,模型在这批任务的多次测试中,平均拿到了 49.1 分。
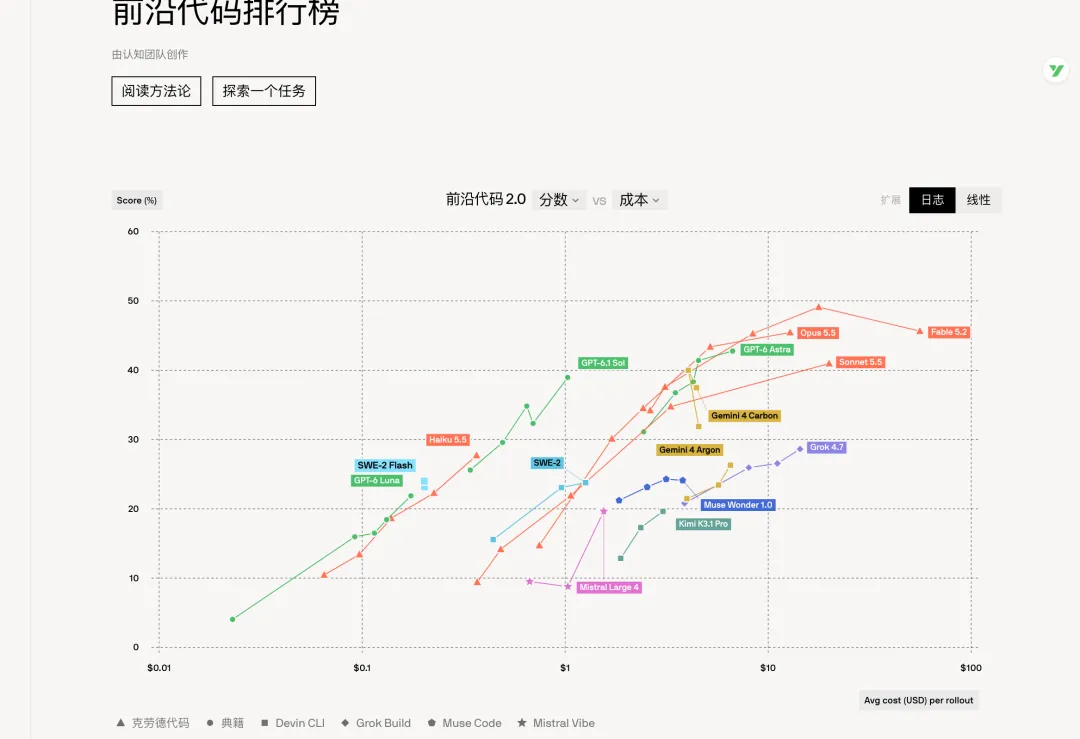
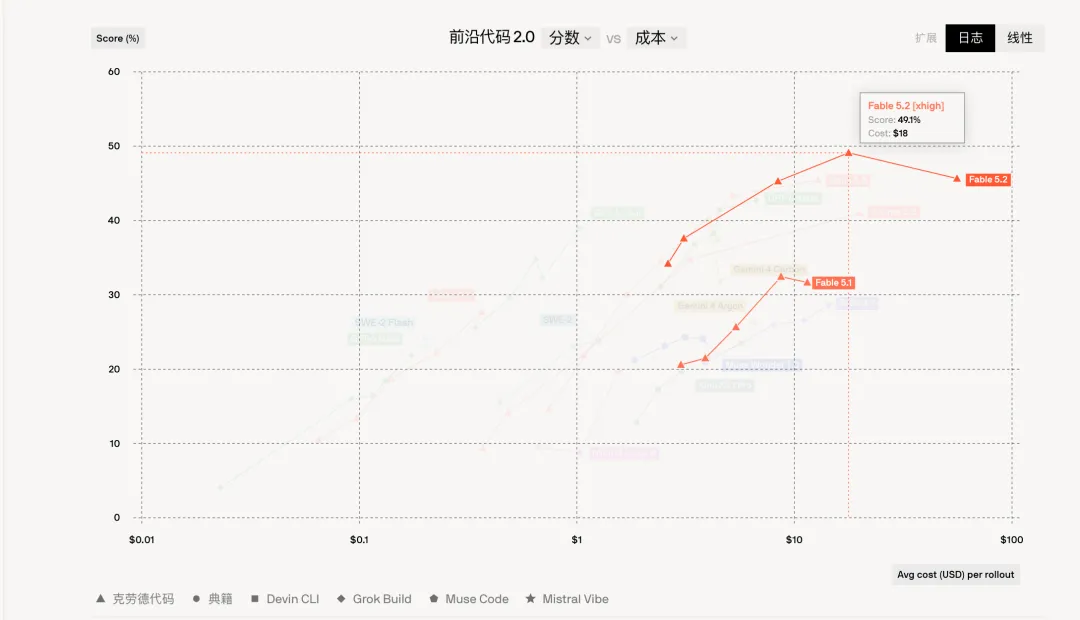
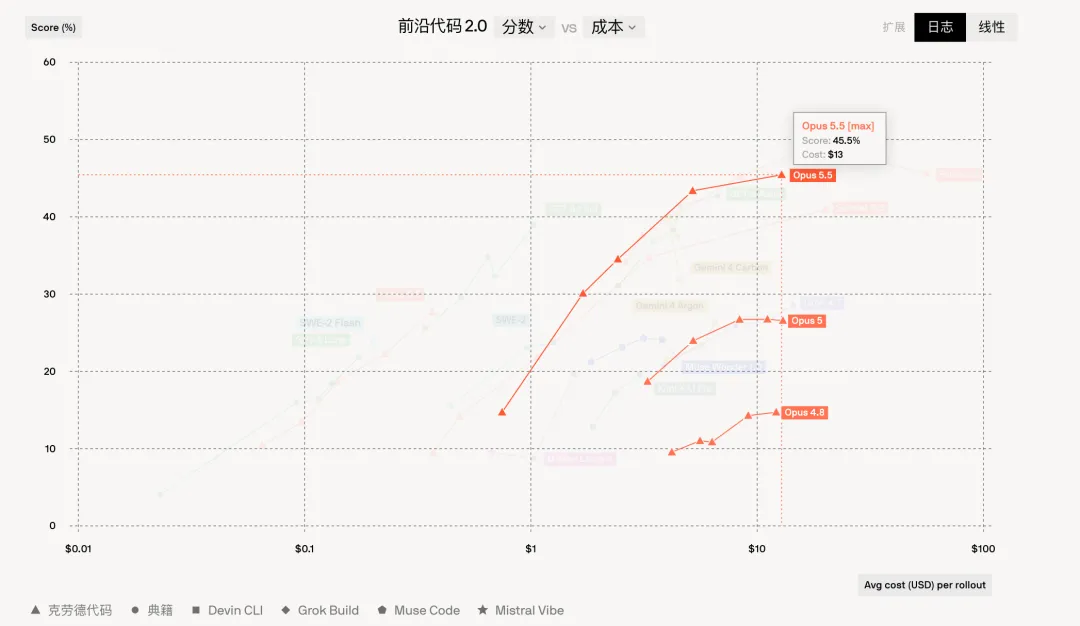
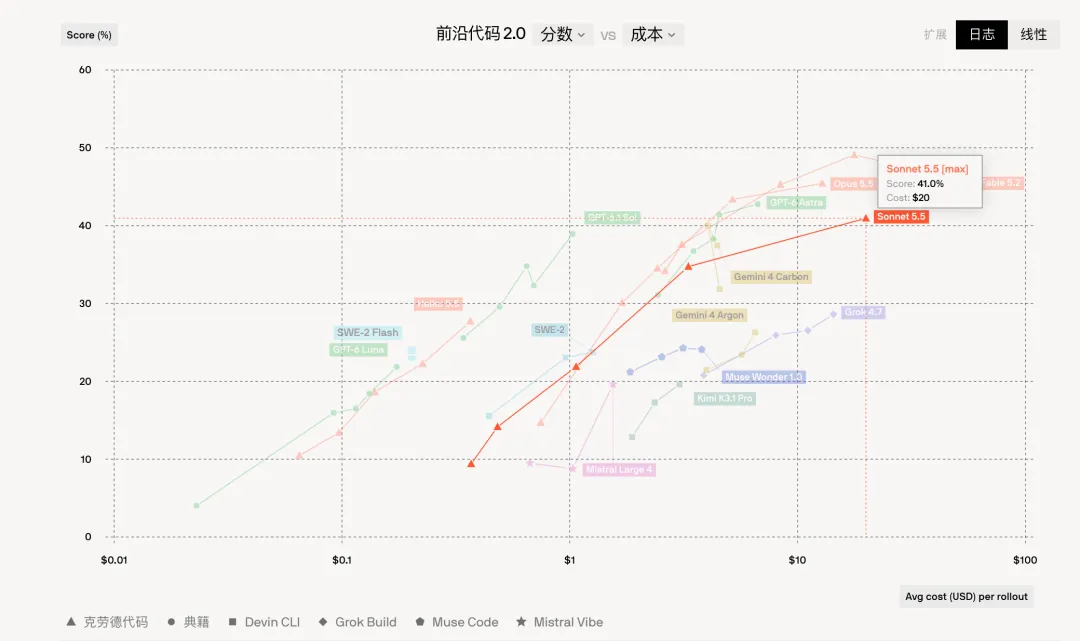
我们可以直接来看下目前所有模型的 FrontierCode 评分榜
从这个评分榜里我们就可以看出来排名第一的就是 Fable 5.2,使用 xhigh(最高推理) 下,Cost(花了)18 刀的情况下, 最高分可以到 49.1%
其次就是 Opus 5.5,最高可以到 45.5%
而 GPT 目前的最强模型 GPT-6 Astra 只能排到第三,甚至和 Sonnet 5.5(41.0%) 几乎没有拉开分数,GPT 确实得加油了啊
OSWorld 2.1:电脑操作测试
一句话解释:给 AI 一台电脑,让它自己看屏幕、点鼠标、敲键盘,把交代的事情做完。
这一项应该是很多同学最关心的。毕竟电脑里总有一堆杂活,自己做嫌烦,交给 AI 又怕它弄错。
比如这样一个任务:“把表格里的日期格式统一一下,做一张统计图,最后导出成 PDF,放进指定文件夹”。 就是 OSWorld 测试,而对应的得分就是整个任务的完成度。
举个例子:
你让 AI 把表格里的日期格式统一一下,做一张统计图,最后导出成 PDF,放进指定文件夹
AI 把这些都做出来了,但是最后没有放入到指定的文件夹里。
这就是完成了一部分,即:拿到部分分数。
这时候,有两种打分办法。
第一种,看它做了多少。虽然最后没导出 PDF,但日期改好了,图也做好了,这些都可以得分。假设三项要求各占一分,它就能拿到两分。
第二种,看它有没有把整件事做完。你要的 PDF 没交出来,这次就算没完成。
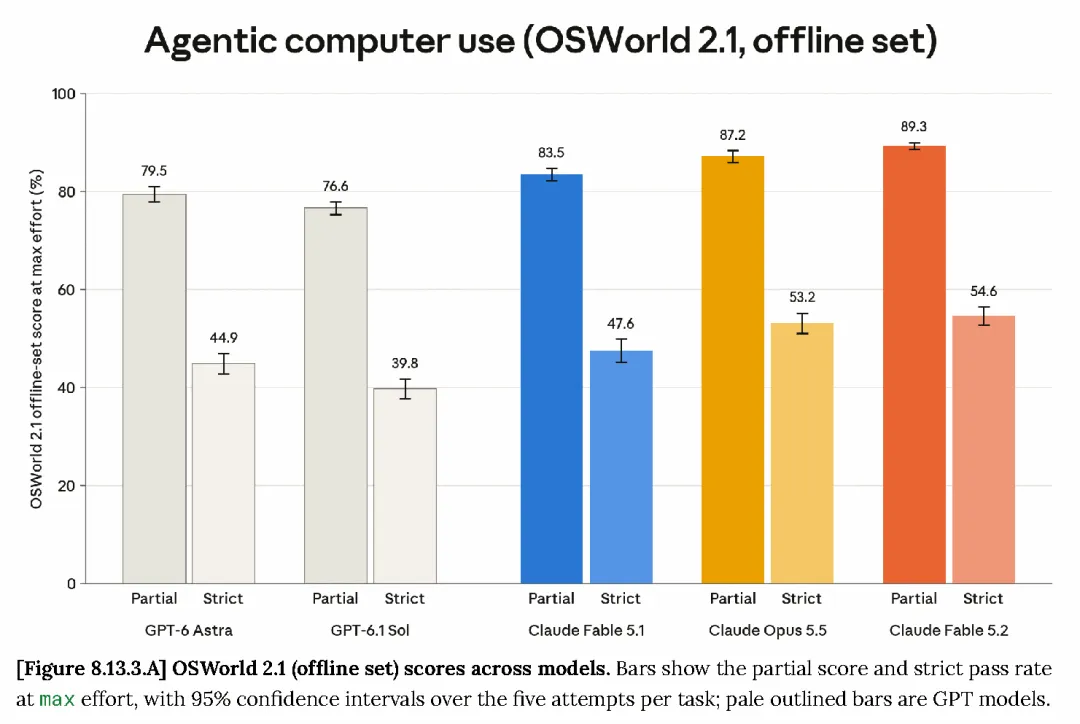
咱们直接看官方报告里的这张图:
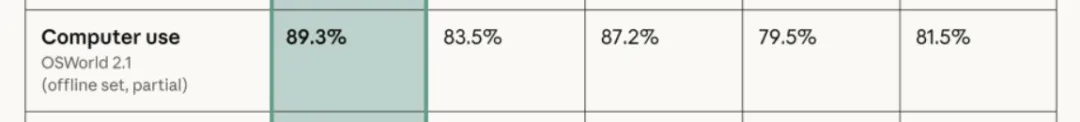
深色柱为部分得分,浅色柱为完整通过率最右边是 Fable 5.2。同一个模型、同一批任务,深色柱是 **89.3%**,浅色柱是 **54.6%**,中间差了将近 35 个百分点。
这两个分数差对应的就是咱们上面所说的两种打分方式:
- 89.3%:按任务完成的程度打分,满分换算成 100 分,AI 平均拿到了 89.3 分。
- 54.6%:只有全部要求都做到才算成功。按这个标准,大约每 100 次尝试,有 55 次能把整件事做完。
再看旁边的 Opus 5.5,分别是 87.2 和 53.2。而 GPT-6 Astra 则是 79.5 和 44.9 ,依然落后于 Opus 5.5
WANDR:搜索与资料整理测试
一句话解释:让 AI 找出一大批符合要求的资料,既要找得全,也要查得对。
平时问 AI“某家公司是哪年成立的”,查到一个可靠来源,基本就够了。但如果你要做一份行业调研,事情就没这么简单了。
比如,你想找 50 家做 AI 编程工具的公司,把每家的产品、成立年份和资料来源整理成表格。
AI 给了你一张看起来很完整的表。
可点开链接才发现,有的公司根本不做编程工具,有的年份也对不上。
反过来,如果它只找到了 10 家,信息全对,也没有完成你要的 50 家。
WANDR 就是在考这种需要反复搜索、核实和整理的任务。
它有 500 项测试,会同时检查提交的资料有多少能被来源证实,以及要求收集的内容完成了多少。
这两方面会合成一个叫 F1 的分数。它有个特点是:其中一项很差,另一项再好,也很难拿高分。
举个例子:
你要求 AI 找到 50 家符合条件的公司,它只找到了 10 家,但这 10 家的信息全部正确。
如果只看准确程度,它是 100%;但看任务完成了多少,它只做了 20%。
把这两个数字直接平均,会得到 60 分。而按 F1 的算法,最终只有 33.3 分,满分 100 分。
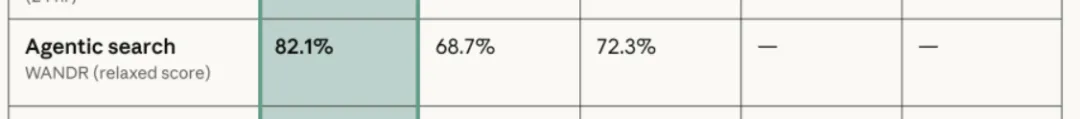
所以 82.1% 的意思是,在这批任务中,这种综合评分的平均成绩是 82.1 分,满分 100 分。
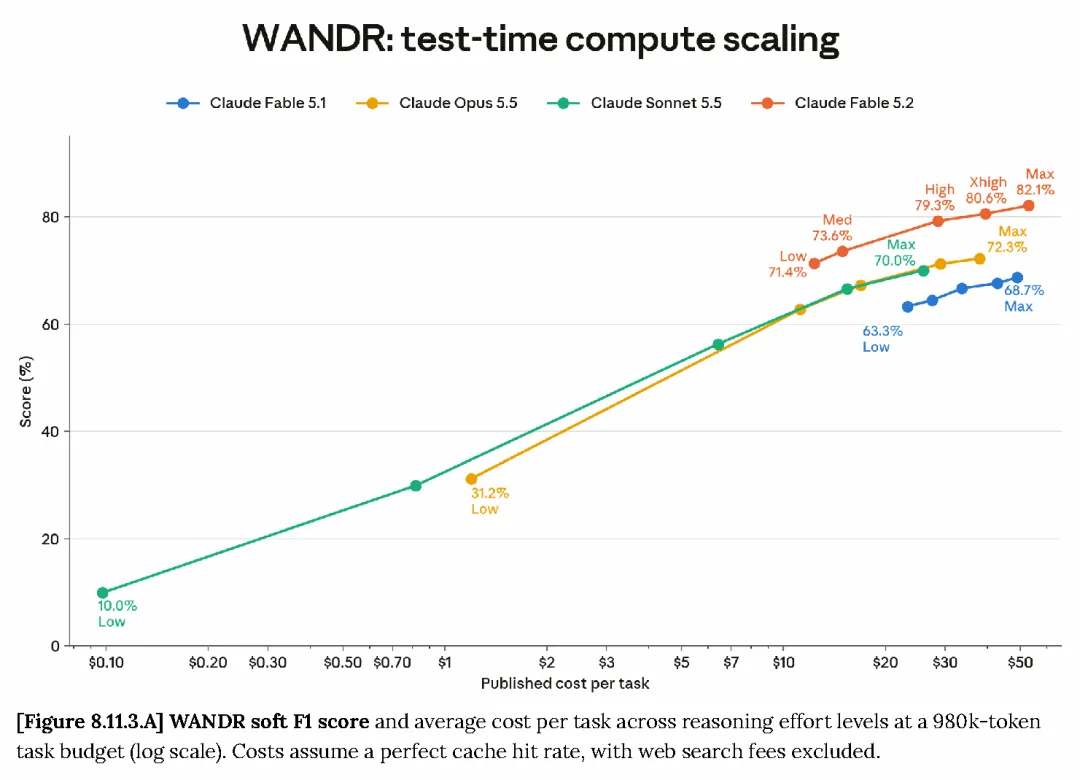
再来看官方的成绩图:
WANDR:不同模型及推理档位的得分先看每条线右边标着 Max 的点。橙色的 Fable 5.2 是 82.1%,上一代 Fable 5.1 是 68.7%,Opus 5.5 是 72.3%。
Fable 5.2 比上一代高了 13.4 个百分点,在这套测试里的进步相当明显。
AA-Briefcase v1.1:知识工作测试
一句话解释:给 AI 一堆工作资料,让它完成分析,交出可以检查的报告、表格或演示文稿。
比如你要分析某个产品为什么卖得不好,手上有销售表、用户反馈,还有几份会议记录。
把这些文件交给 AI,它很快写出了一份报告,说问题是“价格太高”。
可销售表里明明显示,降价之后销量也没起来;用户反馈里反复提到的,反而是某个功能不好用。
AA-Briefcase 考的就是这类工作。
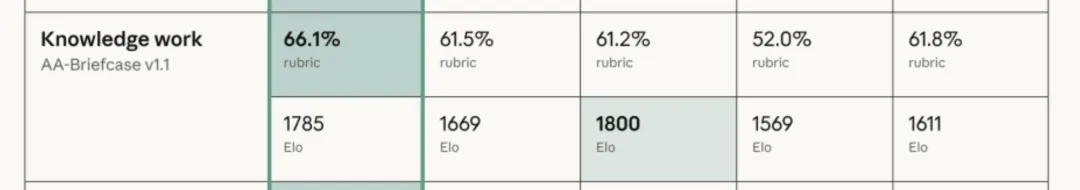
这一项最特别的地方,是它给出了两个成绩:66.1% 和 1785 Elo。
先说比较好懂的 66.1%。下面的 rubric,可以理解成一张验收清单。
比如:这份报告要求引用某个时间段的销售数据,评审就检查它有没有用对。每一个检查项,只有 通过 或 不通过 两种结果。
66.1% 表示就是这些评分项汇总后的通过率
那下面的 1785 又是什么?满分是 2000 吗?
不是。
Elo 没有固定满分,它是把模型的表现放在一起比较后,算出来的相对评级。在同一套评测里,通常越高越好。
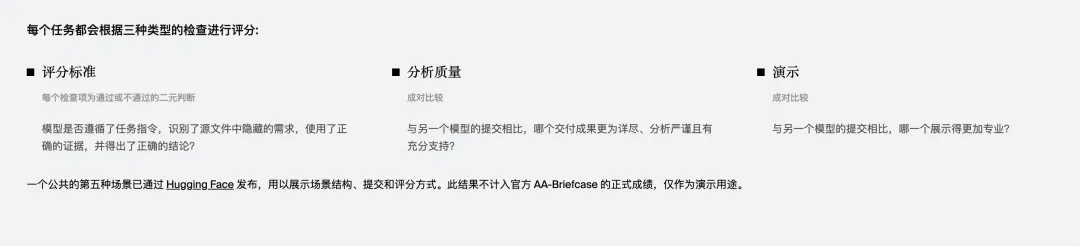
官方把评分分成了下面三个方面:
AA-Briefcase 官方说明:验收清单、分析质量与呈现质量从左到右,分别是评分项是否通过、分析质量、呈现质量。后两项会把不同模型交出的作品放在一起,由评审模型比较,最后综合这些结果得到 Elo。
举个例子,有两份报告都写到了要求的内容。
- 另一份把销量下滑的原因解释清楚,还给出了有依据的建议
在逐项验收和作品比较中,它们就可能得到不同的评价。
回头看发布表,正好有这么一个值得注意的现象:
Fable 5.2 的评分项通过率更高,但综合 Elo 是 Opus 5.5 更高。
这就表示,把分析质量和呈现效果也考虑进去后,Opus 5.5 交出的报告、表格等工作成果,综合评价反而略高于 Fable 5.2。
比如,一份报告把要求的内容都写到了,另一份虽然漏了某个细节,但把问题分析得更透彻,也更方便阅读。
那么再去做逐项检查的时候,前者可能得分更高,但是在评价整份作品时,后者反而会更好~
写在最后
到这里,5 个比较关键的评测基准就都看完了。
不过还有一点要说清楚:跑分和真实体验,完全是两回事。
跑分能测出“做没做对”,却很难测出“做得好不好”。
说到 Claude,我觉得它最厉害的地方,就是它懂得什么叫“好”。
这个说法听起来有点玄。它不像跑分那样能用一个数字表示,更接近一个人对事物的理解:什么样算好看,什么样算好玩,什么样的东西会让人想多用一会儿。
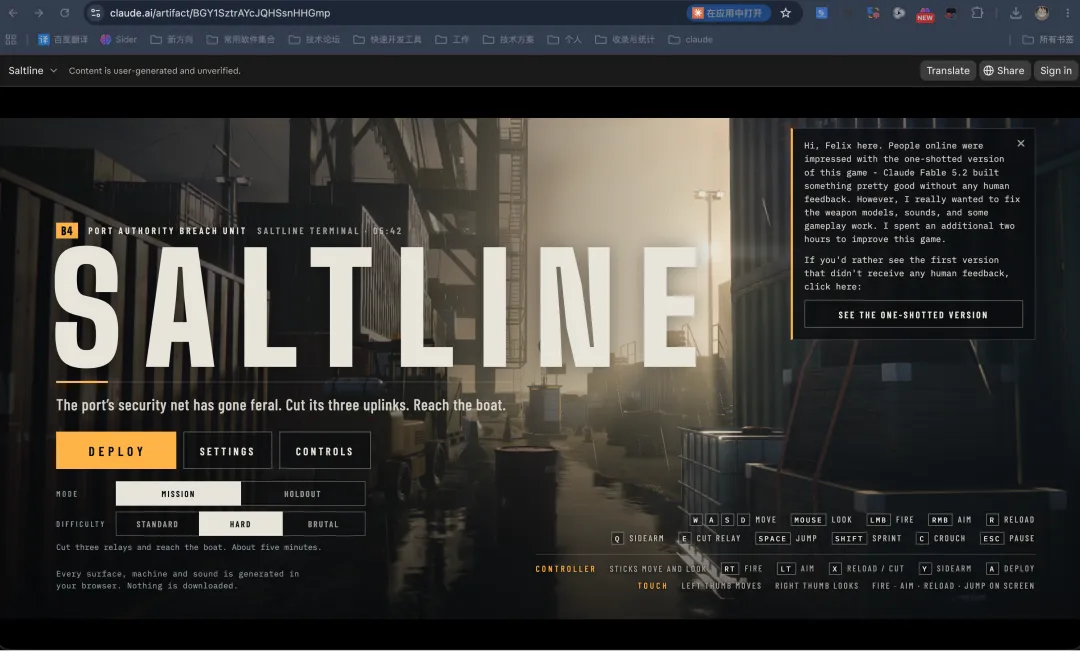
举个例子。最近网上很多人在转一款网页游戏,它是用纯 HTML 写的,整个开发过程全部用 Fable 5.2 完成。
感兴趣的话,可以点这里亲自玩一下: https://claude.ai/artifact/BGY1SztrAYcJQHSsnHHGmp
没人告诉它什么叫好玩,但它做出来的东西,就是能让人一直玩下去。
这种感觉,任何一张跑分表都给不了。
虽然有点不想承认,但在对“好”的理解上,Claude 目前依然是独一档的。这可能也是为什么 A\ 再怎么不当人,还是有那么多人想方设法也要用 Claude。
最后,也真心希望咱们的国产模型,有一天能追上,甚至超过这个水平。
等到那一天,我们想用最好的 AI,不用再折腾 IP、不用再被地区卡住,拿起手机就能直接付款开用。
或许那时候,AI 才算真正走到了每个人身边。
我在做的事