Multi-Agent 评测:怎么知道是分工错了还是执行错了
- 更新时间 2026-11-12 20:31:17
很多工程团队在把多 Agent 接入业务时,往往面临着一种极其尴尬的“玄学困境”:架构师画了一张极具设计美感的分工拓扑图,拉起了 5 个 Agent,写了一大堆交接契约。刚上线时好像效果还不错,但只要业务稍微变复杂,或者把其中某个模型换成了更新一代版本,系统的整体表现就会开始剧烈抖动。
更可怕的是:当整个系统给出一个荒谬的错误结论时,团队里面没有人能说清楚,这口黑锅到底该扣在谁头上。
是分工切得不合理?是拓扑编排选型失误?是交接包漏掉了关键约束?还是某个 Agent 自己调用工具时智商掉线?
面对连环事故,如果缺乏一套科学的评测与归因手段,团队唯一的应对方式就是“瞎抓药”——到处改改 Prompt、再加两个所谓的校验 Agent。结果系统越改越臃肿,账单越滚越大,问题却依然随机爆发。
开篇故障:一次断崖式暴跌的架构重构
某生鲜电商的数字化经营分析团队,原先拥有一套基于中心调度(Supervisor)的多 Agent 报表生成系统。
随着业务发展,中心调度大脑频繁出现注意力稀释与单点过热。于是架构团队决定进行大刀阔斧的重构,将整个系统重构成单向串联的流水线(Pipeline)拓扑:
业务负责人当场发飙:“花了两周重构,为什么系统的准确率反而掉了 25 个百分点?到底是哪一步出了问题?”
开发团队打开监控面板,面对几百条交错的日志陷入了彻底的茫然:
输入是一个复杂的经营提问,输出是一串错漏百出的分析摘要。面对五跳漫长的链路,没有人能断定——到底是在第 1 跳指标解析时范围拆错了,第 2 跳 SQL 查漏了数据,第 3 跳核算口径产生了偏差,还是第 5 跳合成报告时大模型脑补抹杀了关键异常?
“端到端准确率”就像医院的死亡证明:它只冷冰冰地告诉你“病人死了”,却无法告诉你他到底死于中毒、失血还是窒息。
范围限定:本篇只谈多 Agent 特有的评测
在展开技术细节前,我们先划定一道清晰的边界:
像“如何用大模型当裁判(LLM-as-a-Judge)”、“如何给问答文本打幻觉分”、“如何标注 Golden Dataset”这些属于通用 LLM 应用评测范畴的内容,我们放在后续的《LLM 应用评测系列》中系统深拆。
本篇我们死死聚焦在多 Agent 架构独有的核心命题:
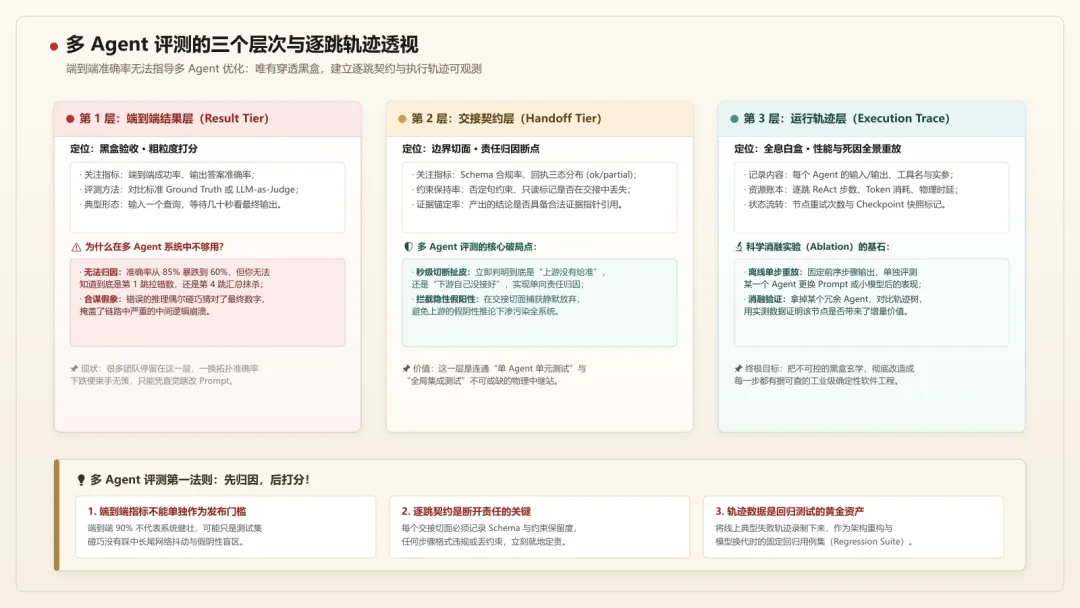
多 Agent 评测的三个层次
要终结抓瞎调试,多 Agent 系统的评测必须从黑盒走向全景白盒。工业级实践通常将其拆解为三个不可割裂的层次:
1. 结果层(Result Tier · 宏观验收)
这是最外层的黑盒验收,关注系统的最终交付物。包括任务完成率(Pass Rate)、最终输出指标准确率、以及用户满意度。
结果层的作用是给业务方一个直观的“大盘体检分数”,但它对指导架构优化几乎毫无意义。
2. 交接契约层(Handoff Tier · 责任切面)
这是多 Agent 评测最重要的“破局点”!
我们在第四篇确立了交接契约(Handoff Payload)与三态回执。在评测中,每一个交接切面都是一座天然的责任裁判所:
只要在契约层打下探针,团队就能秒级切断扯皮:如果是上游回执里的字段错了,上游负全责;如果是上游回执完全合规,下游自己解析崩了,下游负全责。
3. 运行轨迹层(Execution Trace Tier · 白盒全息)
这是最底层的硬核支撑。轨迹评测必须完整记录一个 Agent 在单跳生命周期内的所有动作:
{ "node_id": "sql_generator_02", "input_payload": { ... }, // 上游给的原始输入 "tool_calls": [ ... ], // 调用了哪些工具、实参、耗时 "intermediate_steps": 3, // ReAct 循环了几轮 "tokens_consumed": 4210, // 这一跳烧了多少 Token "duration_ms": 1820, // 这一跳耗时几秒 "output_payload": { ... } // 最终交出的结构化回执}有了完整的 Trace 树,我们就能像排查微服务链路追踪(Distributed Tracing)一样,随时对任何一次故障进行单步离线重放(Offline Replay)。
五维失败归因矩阵:全系列大对齐
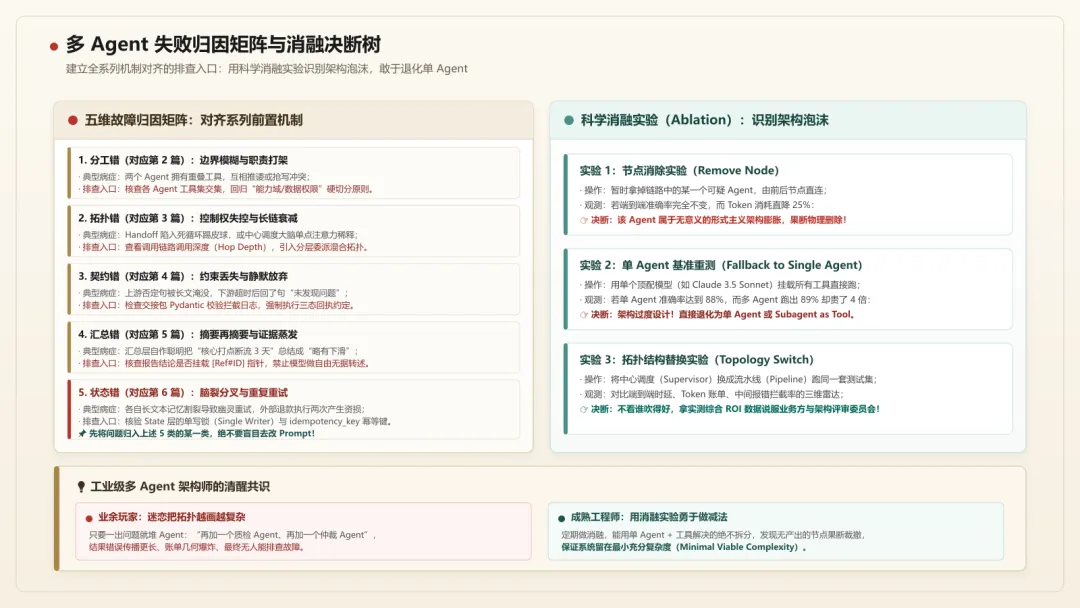
当系统在测试集上报错时,千万不要病急乱投医去瞎改 System Prompt。可以拿出这张五维归因矩阵,顺着前面各篇的工程机制对号入座:
| 分工错 | |||
| 拓扑错 | |||
| 契约错 | |||
| 汇总错 | |||
| 状态错 |
只有当上述五维架构机制全部确认无误时,最后的报错才真正归为执行错(单个 Agent 自身的 Prompt 缺陷或模型基座智商局限)。在此之前改 Prompt,全是在南辕北辙。
消融实验(Ablation):用科学实验干掉多余的 Agent
在多 Agent 工程中,最容易滋生的恶疾就是架构膨胀与形式主义:很多系统拉了七八个 Agent,其实里面一半都是纯属凑数的“吉祥物”。
证明一个多 Agent 系统是否合格的唯一科学手段,就是消融实验(Ablation Study)。在评测流程中,必须定期跑三组对照:
1. 节点消除实验(Remove Node)
在测试集上,尝试拔掉链路中某一个看似可有可无的 Agent(比如去掉某个独立的“格式化 Agent”或“初级校验 Agent”),由前后节点直接对接。
2. 单 Agent 基准重测(Fallback Baseline)
永远保留一份单 Agent + 完整工具库的评测对照线。
如果当前任务跑在顶配单 Agent 下准确率是 88%,而精心编排的多 Agent 系统费尽心机跑出来是 89%,但多花了 4 倍的 Token、多了 3 倍的时延:
3. 拓扑替换实验(Topology Switch)
将同一批测试集,分别灌入 Supervisor 集中拓扑与 Pipeline 流水线拓扑。用综合雷达图对比准确率、Token 账单与 P99 时延,拿客观数字说服业务方与架构委员会。
人工接管埋点:评测与生产的公共底座
我们在第七篇提到过“人机回退(Human Fallback)”:当置信度不足或涉及高危操作时,系统必须挂起等待人工裁决。
很多开发者只把这个机制当成线上的“应急兜底”。但实际上,人工接管点是构建高质量评测集和回归集的最核心源泉!
线上每一次触发人工接管,都意味着大模型遇到了边界模糊的 Corner Case。系统把人工介入前后的完整 Trace 轨迹捕获下来,人工修改后的结果天然就是最精准的 Golden Ground Truth!
源源不断的人工接管案例,自动转化为离线回归测试用例。这套机制将线上运维与离线评测打通为了一个自我进化的飞轮。
最后算笔账:买到了什么,多出了哪些坑?
建立细粒度评测与消融体系,是一项硬核的基础设施投入:
| 逐跳契约切面评测 | |||
| 全息 Trace 轨迹重放 | |||
| 定期消融实验(Ablation) | |||
| 人工接管轨迹回放 |
写在最后
多 Agent 系统的成熟标志,不是看它的架构图画得多么花哨,而是看它在被现实暴击时,能不能在几秒钟之内说清是哪一跳出了问题。
当你建立了逐跳契约的责任防线、学会了用 Trace 轨迹透视黑盒、并敢于用消融实验删掉多余的 Agent 时,你手中的系统才算真正褪去了盲目跟风的浮躁,成为了一套拥有科学度量衡的工程系统。
到这里,我们从单个 Agent 的天花板出发,走过了分工、拓扑、契约、隔离、状态、失败传播、成本账,直到今天的科学评测。
多 Agent 所有的核心机制拼图,已经全部就位。
当这一切机制真正要走出开发环境的象牙塔,面对企业内部错综复杂的微服务权限、真实黑客的 Prompt 注入、全链路的可观测性监控、以及随着模型智商升级后的架构双向演进(何时该拆分、何时该坚决退回单 Agent)——我们究竟该如何让多 Agent 在生产环境中长期可运维、安全稳定地活着?
下一篇,多 Agent 工程系列收官大结局:生产落地:从 demo 到可运维的多 Agent。
