为什么中国人做心理测评总觉得"还差点意思"
- 更新时间 2026-11-10 09:05:07
为什么中国人做心理测评总觉得"还差点意思"这个问题我问过不少人,回答都差不多。 不是"不准",也不是"很准"。是还差点意思"。 这五个字很有意思。它说明测评抓到了什么,但没抓到全部;它不假,但也谈不上真。 一、"还差点意思"到底差在哪 我拆过这个感觉,大概是三种。 差在"太像说明书"。 测出来一段描述,说得挺对,但读完你不知道该干什么。它像一份体检报告告诉你脂肪偏高,却不告诉你晚饭该怎么吃。 差在"不像我"。 有的描述你觉得对,有的觉得完全不是。可它不给你选,一整段一起打包给你。你只能整体点头或者整体摇头。 差在"太客气"。 有些测评的描述明显偏正面,几乎没人会得到难看的结果。这不是测出来的,这是设计的——得罪人的报告没人愿意分享。 这三种"差一点"叠加起来,就形成了那个共同感觉:看完了,也认可了,但心里没落下一个东西。 
二、为什么偏偏是中国人的感受更强 这里要小心,我不想把话说成民族性。 但有个东西是真实存在的:我们答题时的习惯,和很多量表设计时的假设,本来就不一样。 西方人格测评有个默认前提:人格是稳定的、跨情境一致的。所以题目敢问"你通常是……"。 可我们从小习惯的自我理解方式不太一样。 "见什么人说什么话","到哪山唱哪歌","在家靠父母出门靠朋友"——这些话教的是你在什么关系里、什么场合下,该是哪个样子。 所以当题目问"你通常是",很多人脑子里冒出的头一个念头是:看什么场合。 这不是滑头,这是一种更复杂的自我认知。它承认自己是分场合的。 而量表不给这个选项。 单次事件被当成规律,也是同一个问题的另一面。有人测完看到"你不善于表达",回想起上周开会没接上话,就觉得对。可上周那场会可能本来就不是他的场,换了场合他表达得好得很。 学界对这类现象有对应的研究,属于应答风格范畴——比如受访者倾向对陈述表示同意(默许偏差),或者为了显得得体而不充分表达不满(礼貌偏差,研究明确指出这在亚洲文化中更常见)。 这些概念不是给中国人贴标签。它们说的是一件很中性的事:同一份问卷,不同文化背景的人,答题方式本身就不一样。 所以"还差点意思"很可能不是你的问题,也不完全是测评的问题,是问卷的假设和你实际的自我结构,没对上。 还有一层结果值得说:这种错位会让本来准确的描述也显得不准。 举个例子。一个人其实很擅长表达,但只在他熟悉的领域、面对信任的人时。测评问"你通常善于表达吗",他答"一般"。结果报告写"你不善于表达"。 他知道自己不是这样,可他又不能否定这道题——他确实在多数场合话不多。 于是他和这份报告之间隔了一层说不清的东西。不是对抗,是不敢全信。 被问错的人,往往不是完全反驳,而是保留。保留久了,这份报告对他的影响就等于零。 三、那个"差点意思"会带来什么后果 如果只是觉得差一点,也没什么。 麻烦的是接下来这一步:人会把这个"差一点"解释成自己的问题。 我对自己不够了解。我不够诚实。我连自己想什么都说不清。 这个归因很伤人。因为它把一次工具的不适配,变成了对自己的否定。 更实际的损失是:很多人从此不太相信任何自我认知的工具了。 他们试过几次,每次都是"还行吧",然后就放弃了。放弃之后,就靠直觉活着——而直觉恰恰是最容易被环境塑造的东西。你在一个只奖励某种性格的公司待十年,你的直觉会以为那种性格就是你。 所以"还差点意思"的代价,不是少知道一点自己。 是你在最该看清自己的那几年,用了一把不称手的尺子,然后误以为自己看不清。 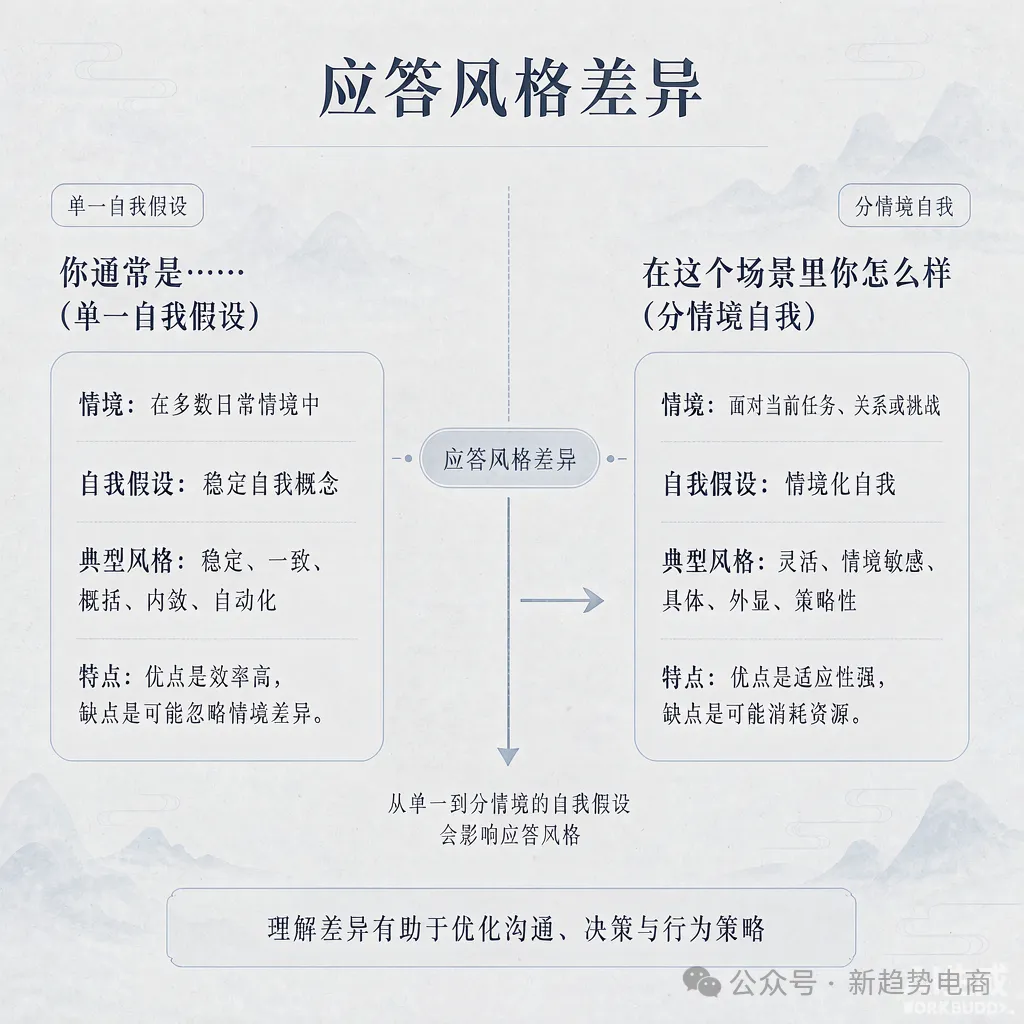
四、如果换个做法,会长什么样 我想过这个问题很久。 如果让我重新设计,我会做三件事。 不问"你通常是",改问"在这个场景里你怎么样"。 给出具体场景,让答题的人有画面可依。这比抽象的"通常"好答得多。 不给人一个结论,给人一组坐标。 结论是"你是X",坐标是"你在A轴上偏这边,在B轴上偏那边"。后者不封闭,你可以自己看、自己判断、下次再来看有没有移动。 允许中间态存在。 不是"外向还是内向",而是给一个真实的中间档。中间不是"没想好",中间本身是一种状态。 这三件事听着简单,做起来有三个难处,值得说清楚。 难处在写场景。 抽象题好出,场景题难写。你得想出一个具体到能让人立刻对号入座的场面,还得保证这个场面在不同行业、不同年龄的人身上都成立。写不好就变成"你参加聚会时",那又回到了抽象。 难处在定坐标。 坐标比结论难用。用户习惯了"我是X",突然给他一张图,第一反应是"所以呢"。所以必须配一套读法,否则精度提高了,可读性反而下降。 难处在守中间。 三档比两档多一个选项,但中间档最容易被滥用——什么都选中间,结果就没信息量了。所以得配合一致性检查,看这个人是不是真的在中间,还是只是懒得想。 这三个难处,我当时想了很久,也没有一次想对。 五、我把这个做出来了 这几年我一直在想这件事,后来干脆自己动手。 我不懂代码,产品是 AI 敲出来的,我负责提需求、挑毛病、反复否定它做错的地方。前后十个月。 我把这套东西叫作易我测评成长系统。里面有六十多项测评,其中我最在意的是易我经纬人格罗盘——它就是按上面那三条来的:给场景、给坐标、留中间档。 它不是什么科学突破。它就是我想回答一个憋了很多年的问题: 为什么那么多人做测评,做完总觉得差点意思。 六、最后 所以下次你再觉得"还差点意思",别先怪自己。 你可以问一句:是我不够了解自己,还是这份问卷压根没给我答题的位置? 这个区别挺重要的。前者只能认,后者可以换。 你记不记得,哪次测评,印象里特别不准?当时你归因给谁了? #来微信做个小程序
注:近期系统上线公测不久,因为接口逻辑众多,还有一些bug。如果你在使用中发现问题,欢迎在小程序首页意见反馈板块或者到本公众号文章评论区使劲吐槽。
关于作者:梁涛,易我测评成长系统(EvolveMe)创始人(个人微信公众号:船长汤米)。致力于在 30 万行代码的实战中,为人类构建一套傻瓜化、具象化的思考力训练闭环。他深信:思考力,是人类在 AI 时代生存的唯一根基。
点击下方创始人个人公众号名片,了解易我测评成长系统的创始心路历程。
本文来自网友投稿或网络内容,
如有侵犯您的权益请联系我们删除,
联系邮箱:wyl860211@qq.com 。
