机器人模型的真实作业能力,仅靠定向演示无法完整验证,必须置于真实环境中反复执行,才能得出客观结论。机甲观察获悉,近日RoboColosseum 开放式机器人评测计划 正式启动,宇树科技 G1 人形机器人已纳入其评测体系。
对于首轮测试中 5 款模型在 G1 上 “零完整成功率” 的记录,机甲观察认为,这既不足以支撑 “全盘否定当前模型” 的结论,也不意味着演示视频毫无价值;它更多反映的是行业从 “单点动作执行” 迈向 “长程复杂任务闭环” 过程中普遍面临的工程挑战。该计划对外公开统一测试标准,用意并非 “公开处刑”,而是为全行业搭建共建底座、明确下一步技术迭代坐标的客观标尺。
宇树G1加入全球开放式评测平台
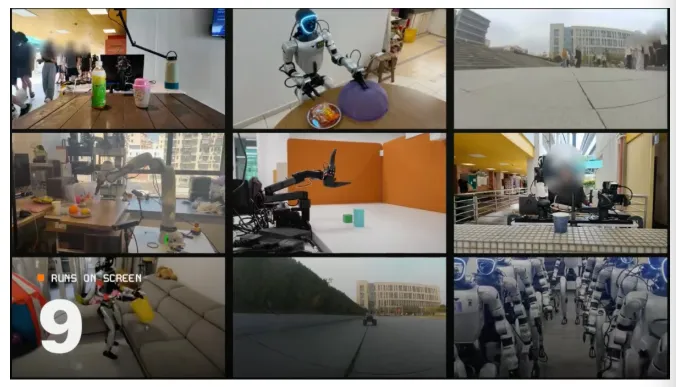
近日,一个名为RoboColosseum的开放式机器人评测计划正式启动。该项目由新加坡国立大学MAGIC实验室、BitRobot Foundation、新加坡具身智能中心及Hugging Face共同发起,计划向全球学术研究人员开放机器人测试资源,包括超过100台机器人、140多个真实场景,以及1万小时免费评测资源。
宇树科技公开支持该项目,其G1人形机器人作为四种标准化形态之一,被纳入平台的人形机器人评测体系。
RoboColosseum:构建可复用的实体评测基础设施
RoboColosseum并非简单的设备租赁,而是试图建立一套持续运转、标准统一的实体机器人评测基础设施。
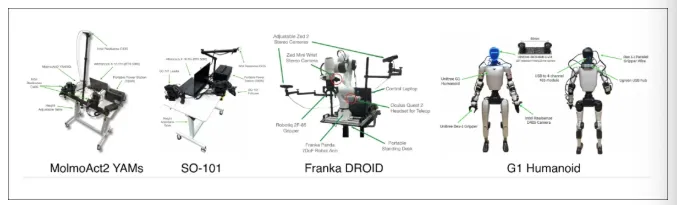
平台覆盖四种标准化机器人形态:宇树G1人形机器人、SO-101单臂平台、YAM双臂系统,以及基于DROID配置的Franka机械臂。为保障不同场地测试结果的可比性,平台针对每种形态制定了标准化硬件配置与统一流程,并配备约30人的专职团队采用轮班制负责部署、调试与日常评测。测试场景超140个,任务涵盖教室整理、食堂分类、家庭家务等真实生活环节。
视源|RoboColosseum
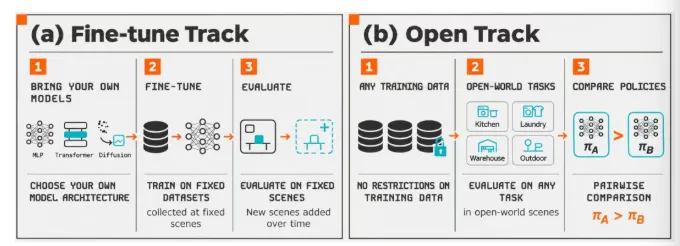
评测机制分为两条路线。一是微调测试考察模型通过少量示范数据学习新任务的能力,每项任务提供100条示范数据,微调后在指定场地进行25次测试,并在物体摆放、光照条件上做变量调整;二是开放测试采用盲测两两比较,考察模型不经特定微调直接应用陌生场景的能力。评价标准上,结合完整任务成功率、进度得分,以及Elo评分与难度校准Rasch(DCR)统计方法,将模型能力与任务难度分别估算。
两条研究路线:在固定场景的共享数据集上进行微调,以及在开放世界任务上进行成对比较。
宇树G1产品的首轮测试与结果
产品与过程:RoboColosseum公布的首轮研究结果,已经覆盖4种机器人形态,包括SO-101、YAM、Franka和宇树G1,累计进行了约1.5万次真实世界评测。
每种具身形态的标准化设置
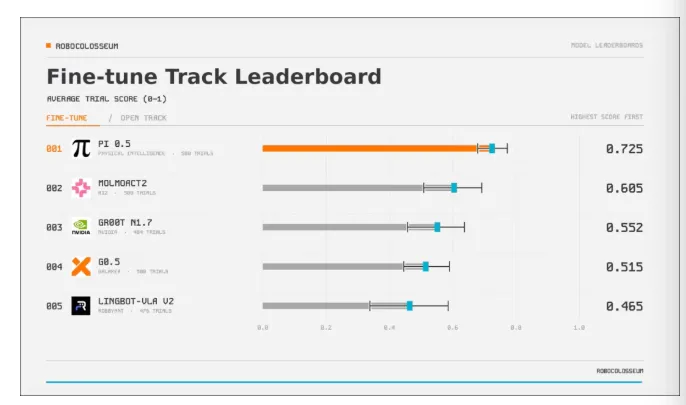
其中,首轮微调测试覆盖5款通用机器人模型,其中包含π0.5、MolmoAct2、LingBot-VLA v2、G0.5、GR00T N1.7。
这部分测试持续了41天,在124个真实场地累计完成11398次评测。但在测试平台上的人形机器人G1的测试结果值得关注,参评模型面对搬运箱子、折叠毛巾、将衣物放入洗衣机等5项典型家庭操作,累计进行625次试验。所有模型均取得了一定的任务进度,平均部分完成度在13.3%至23.2% 之间,未出现完整任务成功。
机器人编队成员:宇树G1人形机器人
这次项目研究人员Duan Jiafei表示,目前开源模型尚不具备在G1开放测试中实现零样本操作的能力,在提供示范数据训练后,面对人形机器人长程任务依然面临较大挑战。
虽然宇树2026年8月登陆科创板,发行市值约609.93亿元;前三季度营收18.17亿元,归母净利润3.87亿元。其本体运动控制能力、量产规模与全球市场影响力也处于行业前列。但此次作为硬件平台承接全球各家模型的适配测试,客观上使其处于“标准载体”的位置,本体能力与模型适配之间的工程边界,在标准化测试条件下得到了量化呈现。
从单点执行向长程闭环跨越
从这次事件中可以观察到具身智能行业当前的几个客观事实与趋势:
第一,能力验证正从“定向演示”转向“长程闭环”。 首轮测试显示,模型在单点动作(如伸手、抓取)上具备一定进度,但将多个动作串联成完整任务(如抓取、搬运、翻转、装载)时,闭环成功率仍待提升。这反映出行业在空间记忆、长程规划与实时纠错方面的工程积累仍在深化过程中。
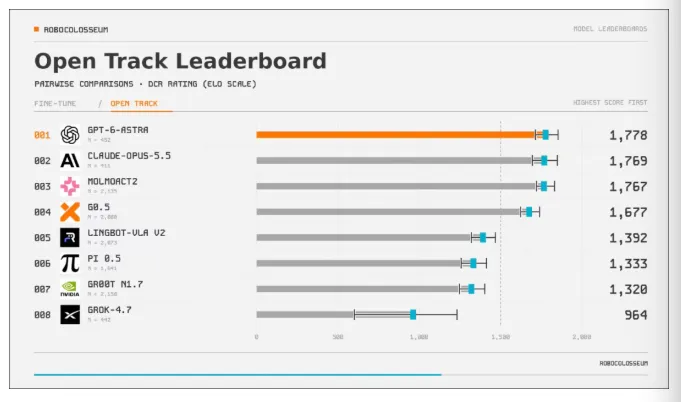 第二,通用智能体与专业模型呈现融合探索趋势。开放测试则在SO-101、YAM和Franka平台上进行,除了上述5款机器人模型,还加入了3款前沿AI智能体:xAI的Grok 4.7、Claude Opus 5.5和GPT-6 Astra。同时,还与专业VLA模型进行了901组匹配比较。AI智能体在其中394次测试中取得更大任务进度,VLA模型为265次,但没有任何一款模型在所有任务和平台上保持领先,表明不同技术路线在真实物理任务中各有侧重,互为补充。
第三,行业评价体系趋向公开、客观与标准化。 项目团队计划通过Hugging Face公开记录成功与失败的全部视频评测,并引入主动匹配机制(优先测试实力差距不明的模型),据披露该策略可使排名在约400至500次评测后达到与完整数据排行榜约90%的一致程度。目前正招募愿公开成绩的学术团队,提供1万小时免费评测资源,申请者无需开放模型权重或源代码。
小结:共建行业底座,明晰迭代坐标
通过公开测试RoboColosseum项目用1.5万次真实评测与公开的失败记录,为具身智能行业提供了一个观察技术现状的客观切面。对于研究机构与产业客户而言,认清长程任务闭环中的共性难点,是推动技术从实验室走向真实场景的必要过程。
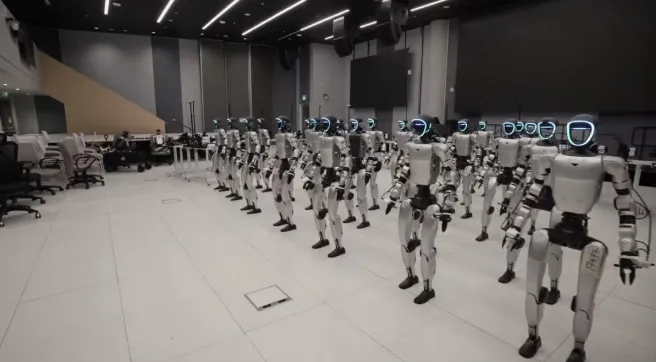
宇树G1作为标准载体参与其中,其本体能力与模型适配的边界被量化,为后续的软硬件协同优化提供了重要参考。随着公开评测网络的扩展与标准化机制的完善,具身智能有望在公开、共建的标尺下,期待能稳步推进从“单点演示”向“稳定作业”的工程化跨越。