Vals联创:别按金融AI的评测排行榜来选模型
- 更新时间 2026-11-06 15:14:13
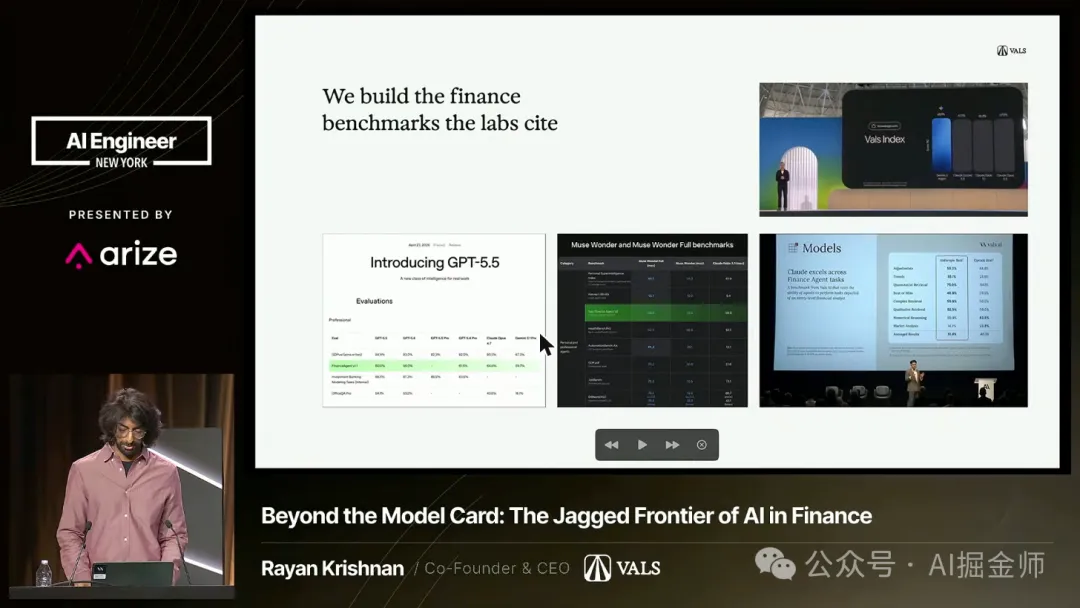
▲ 2026 年 10 月 13 日,AI Engineer New York 主舞台,Vals AI 联合创始人兼 CEO Rayan Krishnan 的开场页「We build the finance benchmarks the labs cite」。来源:AI Engineer New York 直播回放截图
Vals AI 的联合创始人兼 CEO 在 AI Engineer New York 的台上,抖出了自家一个不太体面的数字:工程团队有一个月被放开了 token 额度,账单 150 万美元。幻灯片上的问题是「What do you do when your engineers spend $1.5M in a month?」,他口头又补了两个数字:团队 10 到 12 个人,这笔账大约是那个月工资开支的 10 倍。他的评语很直接:「that was pretty insane. But we saw great output.」疯狂,但产出确实漂亮。
这是 10 月 13 日主舞台上一场十来分钟的演讲,题目《Beyond the Model Card: The Jagged Frontier of AI in Finance》(模型卡之外:金融 AI 的参差前沿)。屏幕字幕条标注讲者为 Rayan Krishnan,Co-Founder & CEO,VALS。Vals 做模型评测,开场页的标题就是「We build the finance benchmarks the labs cite」,我们做实验室引用的金融基准。这场演讲前半是评测方法论,后半是他们怎么用评测把自家的 token 账单砍下来,里面有一个和直觉相反的对比:在他们的内部评测里,被当作省钱方案的自托管开源模型,反而又贵又慢。
先说结论
|
同一份金融榜单,第一名也在换人
模型发布页上的成绩单,Krishnan 比大多数人熟。开场页并排放了四张图:GPT-5.5 发布页的评测表里,「FinanceAgent v1.1」一行高亮;一款名为 Muse Wonder 的模型的基准表里,Vals 的 Finance Agent 一行高亮;Claude 一页介绍 Finance Agent 任务的发布幻灯片;还有一场发布会大屏上的 Vals Index 柱图,具体分数画面上看不清。口述里他说,上周有人在台上展示了 Vals Index(字幕作「Sundar」,台上人物身份画面无法确认,待核),前一天又有一款新模型(字幕作「muse models」,对应画面里的 Muse Wonder)引用了他们的金融 Agent 基准。他拿这个自嘲:每出一个新模型,幻灯片就得重改一遍,数字还得再核一遍,「it keeps our lives interesting」。
题目里的「参差前沿」(jagged frontier)是业内的常用说法,指模型在有些任务上强,在另一些任务上弱,能力边界参差不齐。他说成绩单能让你感觉到一个模型干有价值的活有多强,这类评测也确实在给不少公司创造价值;评测就是用来量这条参差边界的工具,金融是他特意点出的重点。
接下来这页是全场信息量最大的一页:「Even inside finance, the leader changes」,哪怕只看金融,领先者也在变。表里是四个模型在 Vals 四套私有金融基准上的名次。
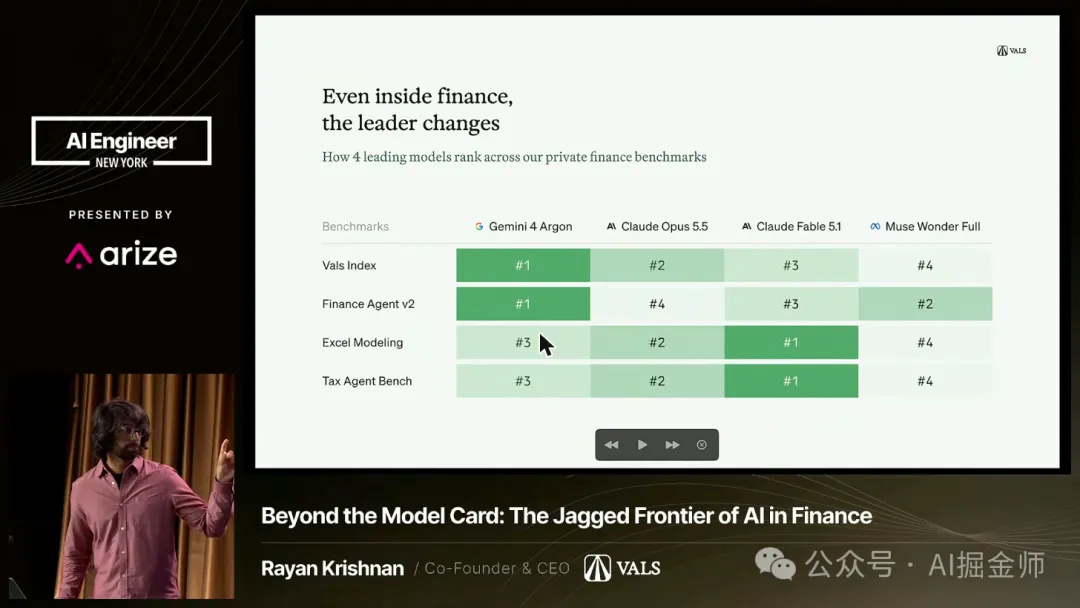
▲ Vals 的名次热力表:Gemini 4 Argon、Claude Opus 5.5、Claude Fable 5.1、Muse Wonder Full 在四套私有金融基准上的排名。来源:AI Engineer New York 直播回放截图
读表可以这样读:Gemini 4 Argon 在 Vals Index 和 Finance Agent v2 上都是第一,在 Excel Modeling 和 Tax Agent Bench 上掉到第三;Claude Fable 5.1 正好反过来,在 Excel Modeling 和 Tax Agent Bench 上第一,在 Vals Index 和 Finance Agent v2 上是第三;Muse Wonder Full 在 Finance Agent v2 上排第二,其余三项排第四。没有哪个模型包揽四项。他口述的意思也一样:谁排第一并不显然,第二第三也不会一直不变。
再往下钻一层,同一个基准里的任务也各不相同。
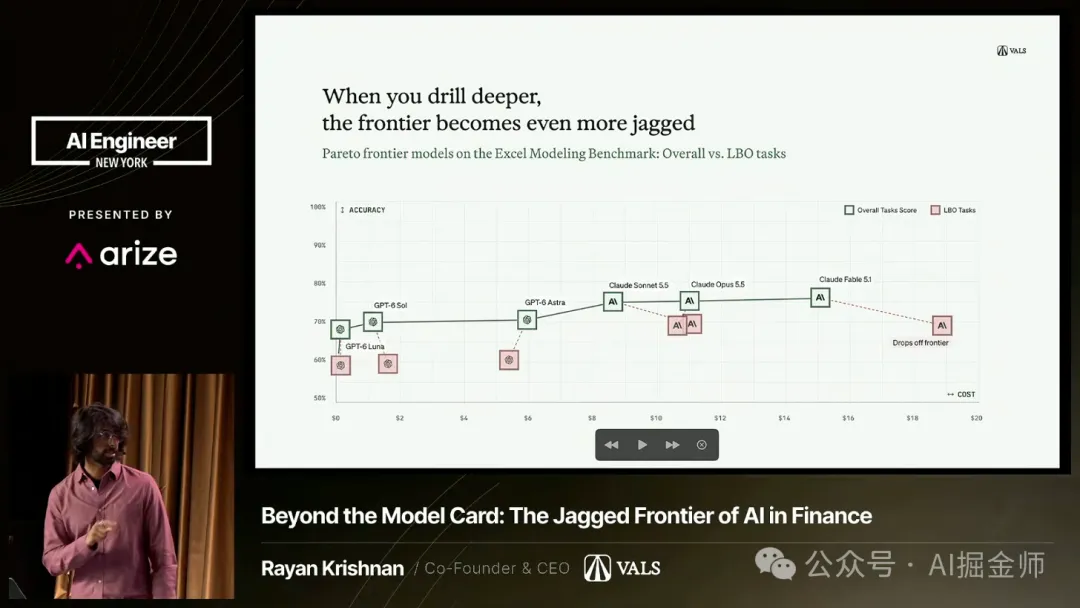
▲ 「When you drill deeper, the frontier becomes even more jagged」:Excel Modeling 基准上的帕累托前沿,整体任务与 LBO 任务对比;Claude Fable 5.1 的 LBO 点标注「Drops off frontier」。来源:AI Engineer New York 直播回放截图
这张散点图横轴是成本(0 到 20 美元),纵轴是准确率(50% 到 100%)。讲者口述里特意强调,横轴是每个任务的成本(cost per task),不只是 token 的价格;字幕对这一页的口述有残缺,以下据画面。整体任务得分构成的前沿,从接近零成本的 GPT-6 Luna,经 GPT-6 Sol、GPT-6 Astra、Claude Sonnet 5.5、Claude Opus 5.5,一路到 Claude Fable 5.1,准确率大致落在 70% 到 76% 之间(读数为目测)。换成 LBO 任务(LBO 一般指杠杆收购,这里指 Excel 里的相关建模任务)之后,粉色的点整体更低,Claude Fable 5.1 的 LBO 点落在约 19 美元的位置,画面标注「Drops off frontier」,掉出了前沿。整体榜单上最贵的模型,到具体任务上未必还是最划算。
他开场还提到两条统计,其中一条大意是能追踪 AI 成本与开支的团队更容易做出成绩,但字幕残缺、画面上也没有对应页,原句还原不了,只当线索,不当结论。
同一个模型,两个指标:77.6% 对 49.2%
真正的重点在下一页:同一个模型,换一个指标,故事就换了。很多基准给「部分得分」,回答的问题是:给模型一个任务,按期望算,它的产出能拿到多大比例的分数,尤其是和人比。另一个指标是「完全答对」:交给它的任务,有多大比例会一次做到完美。
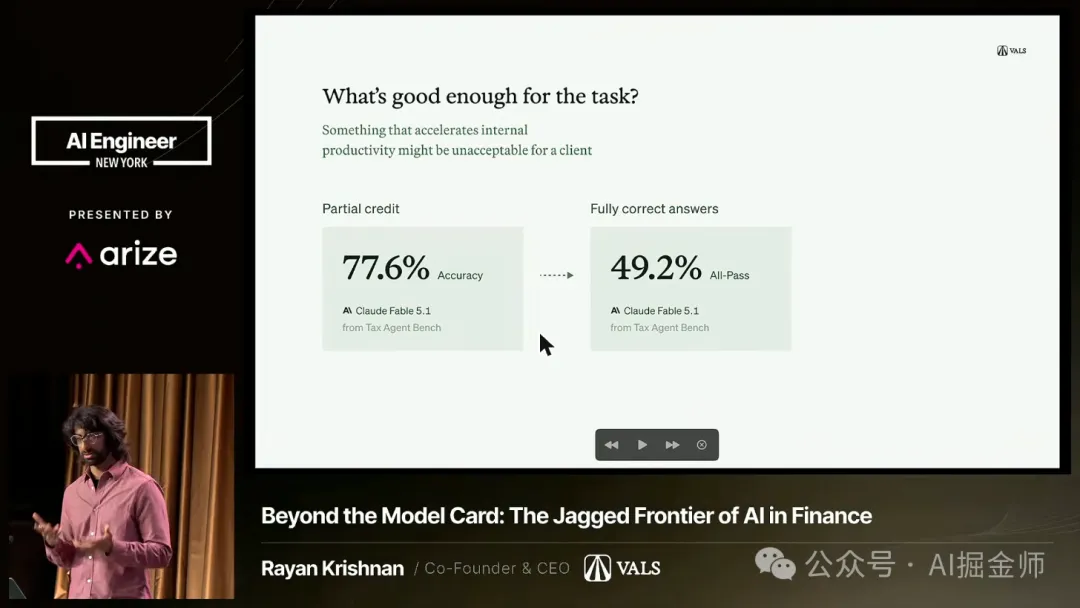 ▲ Claude Fable 5.1 在 Tax Agent Bench 上:部分得分口径的准确率 77.6%,完全答对(All-Pass)口径 49.2%。来源:AI Engineer New York 直播回放截图
幻灯片的标题是「What's good enough for the task?」,副标题是「Something that accelerates internal productivity might be unacceptable for a client」,能加速内部生产力的东西,对客户来说可能不可接受。前者高、后者低的模型,适合产出一份让你接着改的增量稿;但如果把它的输出直接递给客户,「it would be a coin toss of whether it was meeting all the criteria that you have」,能不能满足你的全部标准,是一次抛硬币。
AI掘金师注 编者读数:49.2% 约等于一半,和「抛硬币」的说法吻合,但这句话是讲者的口头比喻,幻灯片上没有。同一个模型,换一个口径,从 77.6% 掉到 49.2%,所以他说选对指标「is very important」,要看清一个模型到底能做什么,而不是看它在哪张榜上排第几。 |
这一场之外,AI Engineer NYC 金融专场还有更多一线实录在路上。关注 #金融AI一线实录 不错过。 |
好评测的三个条件,和一个藏在后面的前提
他把一个好基准要过的关归成三项,幻灯片的标题是「What makes for a good benchmark?」。第一是有效性(Validity):它是否准确反映了我们要评的真实世界任务?口述里他补充,题目是不是编出来的,评分标准写的是不是真的在描述「我们想看到的卓越标准」。第二是可靠性(Reliability):重复跑的结果是否一致,测试在各次运行之间是否公平?这主要取决于任务数和样本数。他说很多公司手里只有五六个样本,拿到新模型就凭感觉试一试,「vibing」;严谨的做法是任务和样本足够多。第三是区分度(Discriminability):能不能区分模型,前沿上是否还有空间?所有模型都拿 100% 或者都拿 0% 的基准没有价值。
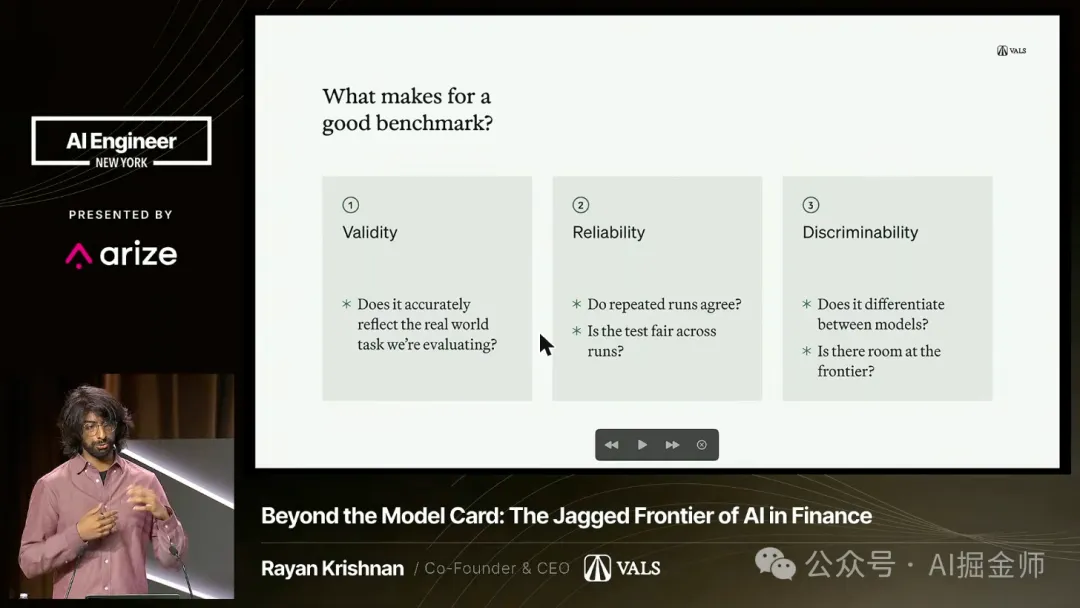
▲ 一个好基准的三个条件:Validity、Reliability、Discriminability。来源:AI Engineer New York 直播回放截图
三项之外还有一个前提,也藏在第三项的第二个问题里:基准要朝前看。得不断出比今天模型能做的更有野心的任务,给前沿留出空间,这样等模型下一轮变强,榜单才有地方继续往上量。一份所有模型都已经考满分的试卷,只能证明过去。
如果你手上的模型选型测试只有五六个样本,这一段说的就是你。
三个麻烦:Agent 会做考卷,评测很重,真实工作是多轮
他列了自己做评测碰到的三个问题。第一个他的说法是 Agent 解的是考卷,不是问题,也就是常说的奖励作弊。Vals 跑评测时让模型走自家的模型代理,有时模型会在沙箱里去调用别的模型,或者想办法联网,等于绕开考试条件。所以评测的容器要造得让它真的测到你要测的东西:能不能完成任务,还是借了别的工具、别的模型。
金融评测里还有一种刷法,他说在金融领域尤其常见。很多评测是对着一组评分要点逐条核对回答有没有覆盖,于是模型学会了留后手,一次给三个可能的答案,三个里碰中要点的概率更高。可是在实际工作里,「a person does not want to consider three different answers. They just want to get the first answer and have it be right.」没有人想看三个答案,只想第一个就对。他的要求是评测得反映人真正想要的产出,别造模型能钻空子的考卷。
第二个问题是基础设施。他们的体会是,代码的成本在下降,写出来很容易,可是把评测跑起来依然很难,任务越长越难:基础设施要在很长时间里保持一致,中途被打断还要能续上重新拉起。他说 Vals 评测累计用掉的 token 最近刚过六万亿(原话「I think just recently crossed six trillion」),所有评测都尽可能高并行地跑,已经被「load tested」。他预计别人迟早也会撞上这些问题,只是规模小一些。
第三个问题是多轮。现有基准大多是一个提示、一个回答,真实工作却是:你先有一份自认为覆盖了一切的初始规格,随后收到追问,或者东西做出来之后又有反馈,要靠一轮轮迭代才到最终产出。所以他的判断是,评测这个环节不会消失。
▲ 金句卡:部分得分高,不等于能交给客户。
团队放开 token 一个月:1.5M 美元,他说约十倍工资
案例来自 Vals 自己的工程团队。他们做过一次「token maxing」实验:拿到一批免费的工具额度,放给全体工程师,随便用。工程师真的用满了。幻灯片的标题是「Case study: Coding」,下面一行大字:「What do you do when your engineers spend $1.5M in a month?」
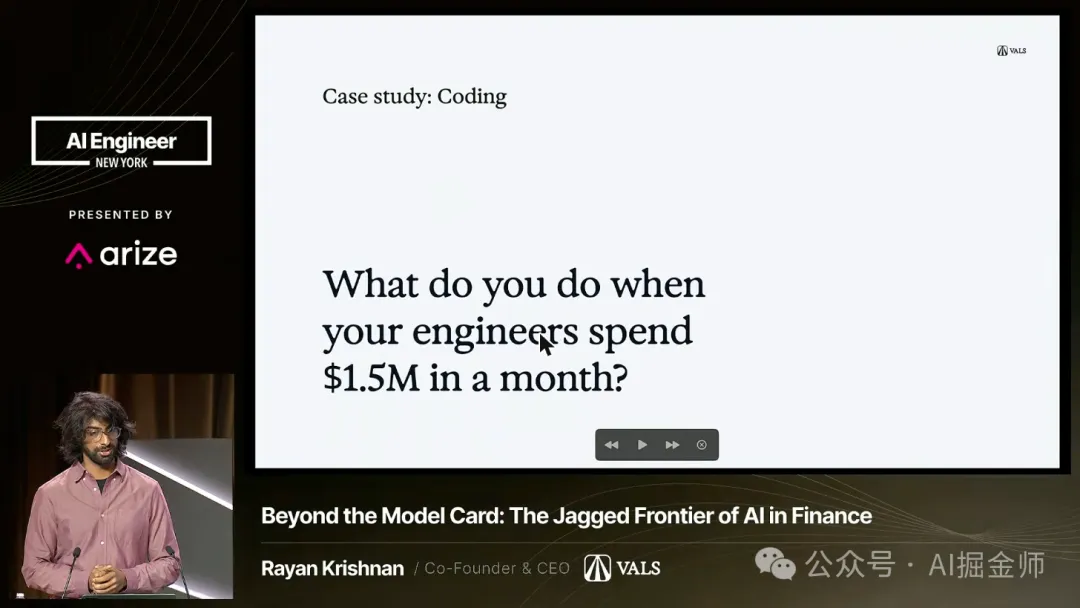
▲ 案例页:工程师一个月花掉 150 万美元 token。画面只有这一个数字;人数与「约十倍工资」来自讲者口述。来源:AI Engineer New York 直播回放截图
口述里他补了两个数字:团队大约 10 到 12 人,这笔钱约为同月工资开支的 10 倍。这两个数字画面上没有,字幕又是自动识别,所以放在这里时都带着「他说」。
AI掘金师注 粗算一下,编者推算,建立在口述数字上,均待核:150 万美元除以 10 到 12 人,人均每月 12.5 万到 15 万美元的 token;如果这正好是工资的 10 倍,团队当月工资大约 15 万美元,人均 1.2 万到 1.5 万美元一个月。不管确切数字是多少,这个量级说明一件事:在重度使用 Agent 的工程团队里,token 的账单可以超过人头的账单。 |
他用的词是「pretty insane」,同时又说「we saw great output」,产出很漂亮。这让问题变得有意思:不是该不该用,而是怎么在产出不变的前提下把成本压下来。他们的做法是做评测,先是内部做了一批工具,后来对外做成了产品,叫 Vals Smith。他还说,这是他们在编程上做的事,也是知识工作其他领域将要发生的事的预演。
用 PR 历史倒带:Vals Smith 和那张对比表
评测怎么造?Vals Smith 页面上的第一句话是:从你自己的仓库里造定制的编码评测,用真实任务给每个工具打分,看成功率、成本和速度。他们把 GitHub 仓库当成「已完成工作」的集中账本:仓库由 PR(合并请求)组成,每个 PR 带一个 issue 和一个解决方案。幻灯片的说法是「History as ground truth」:每一个合并过的 PR,都是一个人已经解决、评审也已经认可的任务,Vals Smith 把这段历史重放一遍,测一个模型能不能做出同样的活。讲者口述里叫它「unwind the clock」,把时钟倒回去。这样回放出来的结果,让他们清楚地看到哪些模型是杀鸡用牛刀、太贵、完全没必要用,哪些真能把活干完。
这里有个和直觉相反的结果。讲者说,很多人看到自己大量使用闭源模型,会想着要降成本就换成自托管的开源模型。他们在同一套回放评测里比了两个模型,画面右侧的「Model Comparison」把数字摆在了一起。
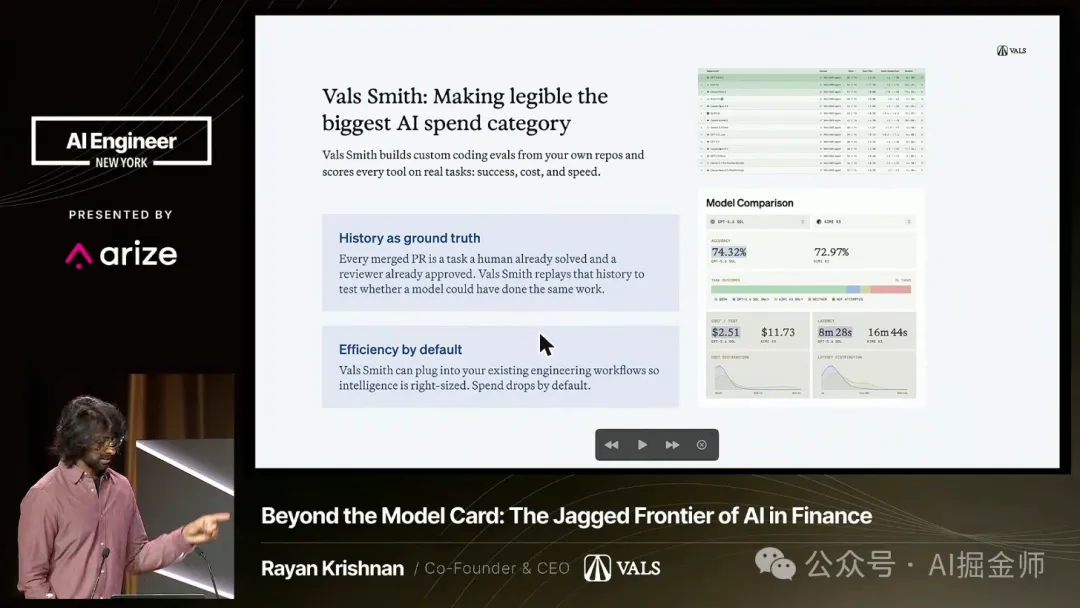
▲ Vals Smith 页面:GPT-5.6 SOL 与 Kimi K3 的对比,74 个任务;准确率 74.32% 对 72.97%,每个任务成本 $2.51 对 $11.73,耗时 8 分 28 秒对 16 分 44 秒。来源:AI Engineer New York 直播回放截图
按画面读:GPT-5.6 SOL 准确率 74.32%,Kimi K3 为 72.97%,差 1.35 个百分点,相对约 1.9%,与讲者口述的「约 2% 更好」大致吻合;每个任务成本 2.51 美元对 11.73 美元,约 4.7 倍;耗时 8 分 28 秒对 16 分 44 秒,约 2 倍,和口述里的「faster half the time」对得上。字幕里那句含混的「250 instead of $11」,对照画面,应是指 $2.51 对 $11.73 的口头约数。讲者的说法是,闭源那个在这个内部评测上更准,而且比起用推理优化过的栈自己托管开源模型,成本也低得多。他的结论是清楚的:「there's no real reason why this kind of intuitive sense of using open source would be a legitimate way to drive down costs.」凭直觉换成开源就能降成本,没有真正的理由。
边界要标清楚:这是 Vals Smith 的产品演示界面,页面没有标注数据来源,讲者口述称这是内部评测;只有 74 个任务;Kimi K3 的成本是否按自托管计,画面上也没有写,是讲者口头交代的。能搬走的是方法,不是结论。
评测带来两个具体差别。一是可以决定采购哪些工具、整个组织的使用额度该设多少;二是可以给工程师逐项推荐,这个 GitHub issue 用哪个编码工具配哪个模型。讲者说,「I think we're spending 90% less but still able to get the same output.」现在花的钱少了约九成,产出不变。原话带着「I think」,页面上只写了「Spend drops by default」,没有这个数字,所以它是讲者的估计,不是审计后的数字。
轮到金融和法律:公司的质量标准存在哪
讲者最后把话题从代码转到别的知识工作:法律、金融这些领域,同样的做法能不能搬过去?他把关键问题改写成一句:你们在哪里记录这家公司已经做过的工作?有的律所有一百年历史,「quality of the organization」存在哪,「standard of excellence」又记在哪?他自己的回答是:今天它可能在给客户的历史回复邮件里,在共享盘里,在数据湖的转储文件里。他把这叫做「treasure trove」,宝库,说很多公司拥有却没意识到,它会是评测的主要解锁点,进而是 AI 在组织里系统性落地的解锁点。
AI掘金师注 编者类比:对一家金融机构,这个宝库大概就是历年的研究报告、投委会备忘录、客户沟通记录、合规意见。这是编者的类比,讲者没有点名这些具体材料。 |
评测一旦建起来,幻灯片的标题是「Evals guides companies through key optimizations」,列了四类更值钱的用法。
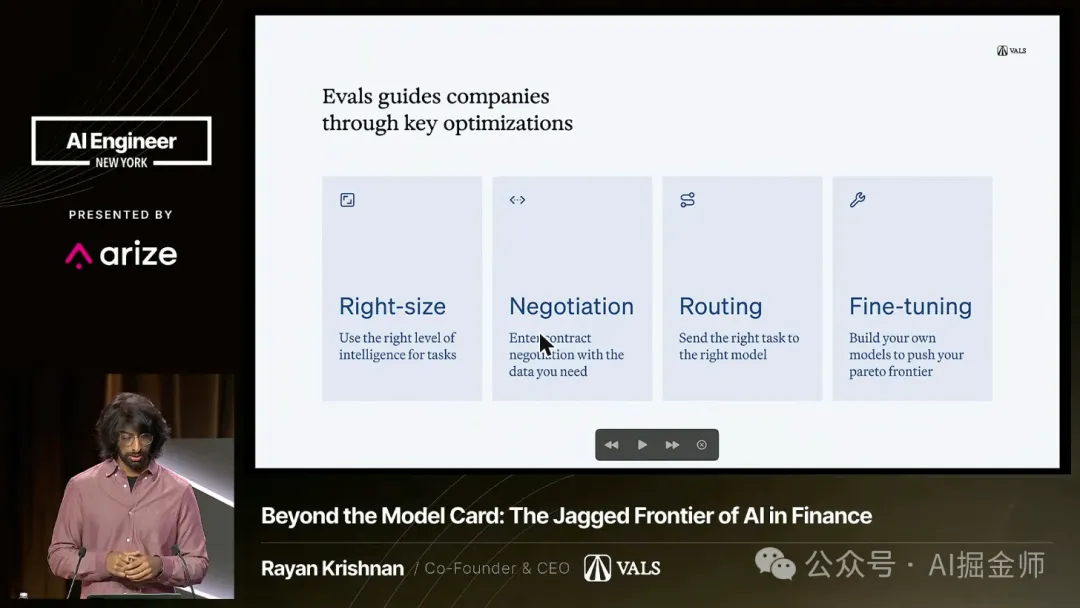
▲ 评测建起来之后的四类用法:Right-size(用对智能等级)、Negotiation(带着数据谈合同)、Routing(把对的任务交给对的模型)、Fine-tuning(造自己的模型推高帕累托前沿)。来源:AI Engineer New York 直播回放截图
第一类是 Right-size:不是一味 token maximizing,而是算出整个组织合适的使用上限。第二类是 Negotiation,口述里他接着第一类讲:一旦你手里有了实际的杠杆,可以拿去和供应商谈批量价格,幻灯片的说法是「Enter contract negotiation with the data you need」。第三类是 Routing,现在已经是很多 AI 产品的核心原语,用户自己也能搭一个智能路由,给每个任务选对的模型。第四类是 Fine-tuning 或后训练,他认为这是最可靠的路径:先造出任务,再用一套外部评测集去验证这个做法到底有没有用(字幕作「mint the tasks」,具体含义待核);幻灯片的说法是「Build your own models to push your pareto frontier」,造自己的模型去推高帕累托前沿。
他最后一句话讲的是护城河:不少公司的竞争优势原本存在员工的脑子里,是组织的隐性知识;评测能让你把这种优势用文字或脚本写下来,他认为这是公司在 Agent 时代取胜的最大解锁。字幕里演讲到此收尾,没有问答环节。
AI掘金师注 读这场演讲有一个提醒:Krishnan 卖的就是评测。「评测是 AI 落地的解锁钥匙」这个结论,恰好也是 Vals 的生意;他唯一展开的案例来自自家的工程团队,任务是写代码。但逻辑本身站得住:没有自己的评测集,选型、限额、议价都只能靠感觉。 |
我的思考:排行榜是别人的考卷,你得有自己的错题本
Vals 的基准被各家模型发布页引用,这说明公共榜单有用。但 Krishnan 自己的幻灯片同时在说另一件事:Claude Fable 5.1 在 Vals Index 上排第三,在 Excel Modeling 和 Tax Agent Bench 上排第一,Gemini 4 Argon 刚好反过来。榜单告诉你谁在别人的题上考得好,不告诉你谁在你的题上够用。
所以他们没有拿榜单来决定团队用哪个模型,而是把自己过去做过的 PR 倒带,让模型重做一遍。金融机构的版本不难想:一家机构做过几年的研究、写过几百份备忘录、答复过上万封客户邮件,这些东西本来就是最像样的考卷,现在大多散落在邮箱和共享盘里。谁先把它们整理成可以反复跑的评测集,谁就有资格对着模型供应商谈价格。
没有自己的错题本,你就只能按别人的排行榜付钱。
本文参考
AI Engineer New York 2026 主舞台演讲《Beyond the Model Card: The Jagged Frontier of AI in Finance》,演讲者 Vals AI 联合创始人兼 CEO Rayan Krishnan(直播屏幕字幕条标注「Rayan Krishnan / Co-Founder & CEO | VALS」),2026 年 10 月 13 日,主舞台,片长约 10 分钟。视频:AI Engineer 官方 10 月 13 日直播回放 youtube.com/watch?v=akEqiXFo3GM,演讲位于 5:06:59 起(直达 &t=18419s)。
转给你们组里正在审 AI 预算的同事。
本文收录于合集 #金融AI一线实录。
关注【AI掘金师】,每周追踪最值得读的 AI×金融动向。
