论文:PROVIA: Procedure State Tracking for Online Mistake Detection in Egocentric Videos(arXiv 2609.20638)
时间:2026-09 | 机构:卡尔斯鲁厄理工学院(KIT)/ 湖南大学
作者:Di Wen, Kailun Yang, Jimmy Weissert, Luc Maria Scherrer, Cedric Zöllner, Ruiping Liu, Yufan Chen, Jiale Wei, Junwei Zheng, Kunyu Peng
arXiv:https://arxiv.org/abs/2609.20638
代码:https://github.com/Kratos-Wen/PROVIA
一个人戴着头戴相机做菜或者装配,助手在边上看着这条视频流。它该做的事是:从已经过去的画面里发现某一步做错了,赶在下一步开始之前提醒,而且人改回来之后还能接着跟下去。这个任务叫在线错误检测(online mistake detection)。
难的地方在于「凭什么判断错了」。错误没有统一形态,菜谱里放错料、顺序颠倒,装配里零件装反、工具用错,尺度也差得远,有些动作慢到能全程看清,有些刚开始就结束了。第一人称视角还只给一个不断增长的过去片段,观察者不知道当前步骤从哪一帧开始,看不到未来,也不能在即将被评判的录像上挑阈值。
更麻烦的是流程本身有两条性质。独立的步骤可以交换顺序,所以给定一个前缀之后,「正确」是一组可行的后续,而不是一个确定的下一个动作。错误会改变工作的状态,后面每一步都得对着「实际做过什么」来读,不能对着「计划本来该做什么」来读。
已有的在线方法(PREGO、DTGL)报告在 first-mistake protocol 上:每条测试视频在第一处错误处截断,方法在截断后的片段上分段,最后一个预测段被标成错误,再算正确和错误两类的 F1。这篇先花了很大篇幅论证这个协议不成立。
🔍 旧考法:不看视频也能拿满分
论文给了四个测量,每一个都指向同一件事,旧协议奖励的是时间位置,不是视觉判断。
第一,截断之后什么都不测了。Assembly101 完整标注里有 707 处错误,其中 73% 发生在此前已经出过错之后,全被排除在评测之外。
第二,方法和标签的位置都不受约束。每条录像给两个固定时间的事件,把第二个标成错误,完全不看画面,两个基准上的平均 F1 都是 1.000。作为参照,DTGL 报告的是 .54 和 .47。
第三,标签本身就是一个位置先验。只用正确执行训练出来的长度先验和步数先验,在 Assembly101-O 上能到平均 F1 .50,EPIC-Tent-O 上 .52,高于 PREGO 报告的 .33 和 .29,和 DTGL 的 .54 与 .47 处在同一量级。单个事件归一化后的位置,在 EPIC-Tent-O 上单独就能把终止事件分出来,AUROC .971。
第四,数据划分没有按参与者隔离。Assembly101-O 的 47 个测试参与者里,35 个也出现在训练集。
四条连起来的意思是,一个从不看视频、只用「事件在录像里的相对位置」的系统,能在旧协议上打赢当时最好的方法。那么旧协议上报出来的提升,有多少来自视觉理解,说不清楚。
替代方案是报警级协议。整条录像从头到尾打分,完全正确的那些也算在内;方法只能读已经到达的帧,在每个自己的决策点上决定报不报警,除了任务名不给它任何关于这条录像的信息。每个标注步骤拥有自己的完成区间,报警落在某个错误步骤的完成区间内、或者落在它最后一个决策之后的下一个决策上,算抓到这次错误;落在正确步骤区间里的报警一律算误报。误报率按正确操作的时长每分钟计。为了让跨方法可比,所有方法的分段分数都过同一条顺序检验规则,阈值按给定误报预算在验证集上冻结。另外加了三组不看画面的对照,打分依据分别是决策序号、经过时间,以及训练集里该序号步骤的出错频率,方法只有在超过所有对照组时才算真的检测到。
这个设计的关键是把误报写进了指标。真实场景里一个乱报警的助手比一个沉默的助手更烦人,旧协议没有这个维度。
🧩 新方法:做过什么,和该到哪一步,分开记
PROVIA 的核心是两份记录分开存。
一份叫事实状态 H,是学习出来的摘要,记录每个执行者实际做了哪些步骤,做错的也记进去。它在每个段结束时更新,不管这段被判成正确还是错误,所以它记的是「发生过什么」。
另一份叫已接受进度 B,是一个精确后验,分布在由正确演示归纳出的过程自动机上,同时带每个执行者的执行状态。它的更新有讲究,只有「正确」分支能让自动机往前走,错误和纠正分支原地不动,保留进入时的状态。这样,一个错误之后的下一步是拿「实际做过的事」去读的,不是拿「这个错误本来会把流程带到哪」去读的。
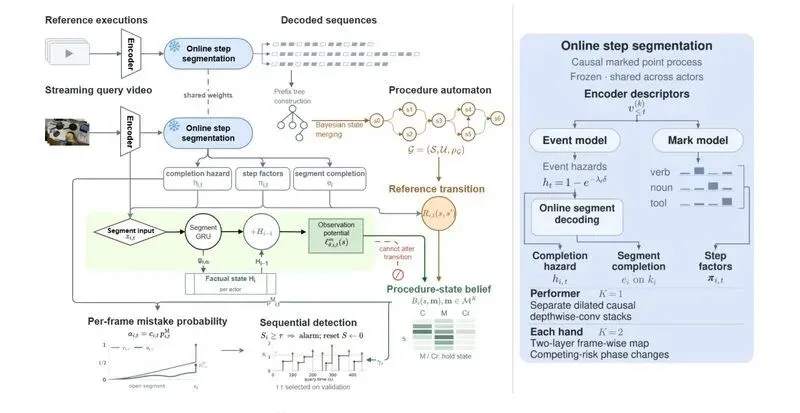
▲ PROVIA 全图:左边是参考执行被解码成带执行者标记的步骤序列、经贝叶斯状态合并成过程自动机,查询流上同时维护事实状态 H 与过程状态后验 B;右边是跨执行者共享的分割模块(论文 Figure 1)自动机怎么来的。一条执行只走一条路径,等于把训练集背下来,所以先从正确演示解码出步骤序列,按完成时间交错成带执行者标记的序列,建成前缀树,再用贝叶斯状态合并(Stolcke 与 Omohundro 1992 的方法)把「预测同一种后续」的历史并成同一个状态。两只手都参与的流程里,两手步骤的先后顺序本身也是语言的一部分。
为什么需要自动机而不是一条参考路径。独立步骤可以交换顺序,同一个任务在一处演示里是「先切后煮」,在另一处可能是「先烧水再切」,一条路径会把后者判成错误。自动机保留所有观察到的分支,只合并后续分布真的相同的历史。
分割模块是一个因果标记点过程,跨执行者共享参数。每帧输出各事件类型的强度、完成风险,以及动词和名词和工具三组步骤因子。解码用因果后验中位数,从上一个解码事件起累积的生存概率掉到一半就算一个事件,不需要任何分数、时长、间隔阈值。分割模型先用步骤标签训好再冻结,错误监督不能移动段边界,也不能改写自动机,这一点实验里还要单独验证。
观察模型给每个段在当前自动机状态 s 下、每种执行状态 m 下的对数似然。状态编码了三个自动机统计量,分别是后继支撑、终止概率和延续熵。段完成时做一次精确滤波更新,只动过程状态和该执行者的状态坐标。
最后是报警规则。每帧的报错概率由两部分相乘,一部分是段被判成「已完成」的门控质量,一部分是在此证据下段状态为错误的概率。门控让概率随着「这一步已经做完了」的证据上升,不会在步骤中途乱报。把每个段的证据分数(后验几率除以先验几率)送进 Shiryaev-Roberts 统计量累加,越过阈值就报警,报警只重置累加器,滤波器和事实状态都不动。阈值在验证集上按给定误报预算定。
整个管线在单张 A100 上跑 58 到 70 帧每秒。事实状态和滤波器只有 0.71 到 0.78M 可训练参数,没有按数据集分的头,没有任务嵌入,没有语言模型。
📊 结果:分数、提前量与消融
四个基准覆盖烹饪、工业装配、日常混合任务、双手拆装。步骤粒度从 43.3 秒到 1.9 秒,跨度 23 倍;类别数从 39 到 2,197;只有 IMPACT-ego 是按手标注的,对应两只手各算一个执行者的情况。
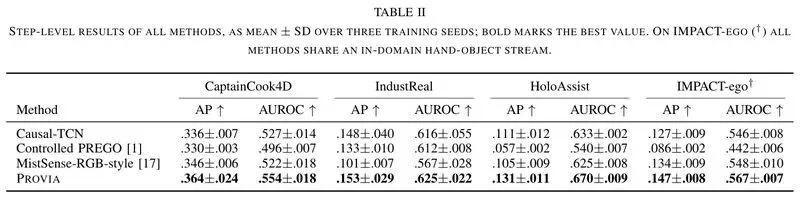
步骤级指标上,PROVIA 在四个基准的 AP 和 AUROC 都排在受控在线基线之前。
▲ 步骤级结果,三次训练种子的均值±标准差:CaptainCook4D 的 AP 是 .364,最强基线 .346;HoloAssist .131 对 .111;IMPACT-ego .147 对 .134(论文 Table II)这里的对比是受控的。三个基线拿到同一条输入流,同样的预测分段与顺序检验规则,只在「怎么携带流程」上不同。Causal-TCN 是纯监督视觉对照,Controlled PREGO 把官方 MiniROAD 识别器里的语言模型调用换成从正确前缀学出的确定性预测器,MistSense-RGB-style 去掉了手部姿态和解释用的语言模型。作者解释了为什么不用原版,PREGO 每步查一次语言模型、MistSense 读手部姿态,两者都在第一处错误截断的录像上打过分,也都不给带误报率的分数。
报警级结果更能说明问题。
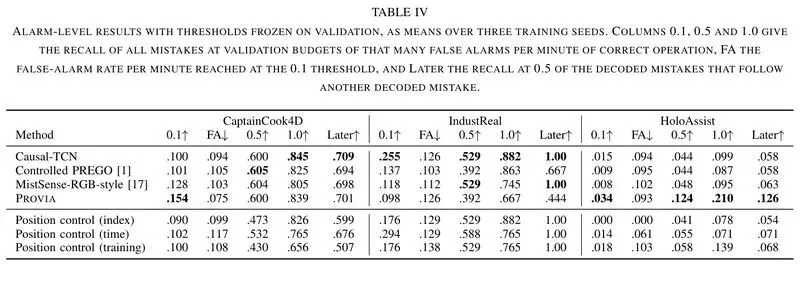
▲ 报警级结果,阈值在验证集上冻结:0.1 次误报每种的预算下,CaptainCook4D 召回 .154 对 .128,HoloAssist .034 对 .015;HoloAssist 上每个预算都领先(论文 Table IV)绝对值要看清。0.1 预算下 .154 的召回意味着大部分错误还是漏掉了。这篇真正垫平的是评测的地基,让「谁更好」这件事第一次有了不含位置先验的比较。
几个细节值得单独看。
领先不是靠后续错误好抓。HoloAssist 那一列里,「跟在另一个已解码错误之后」的错误召回是 .126,最强基线 .063;首次错误的召回是 .180,其他行最多 .048。它在没有被错误污染的状态上照样领先。
提前量。0.5 次误报每种的预算下,CaptainCook4D 上 .82 的检测发生在下一步开始之前,HoloAssist 上 .89,而所有基线中最多只有 .85 的检测能赶在下一步之前。
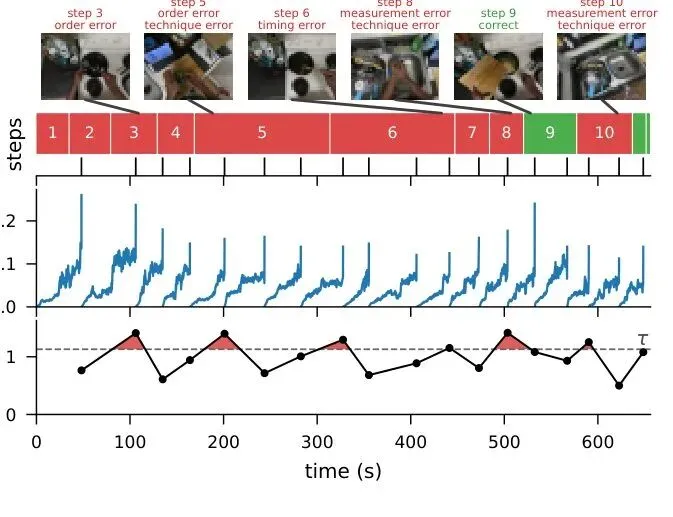
▲ 一条 CaptainCook4D 测试执行(Zoodles,656 秒):第二行 12 个标注步骤按完成区间铺开,红为错误、绿为正确,竖线是 18 个预测完成点;第三行逐帧报错概率,第四行 Shiryaev-Roberts 统计量对阈值 τ,越过 τ 的阴影区就是报警(论文 Figure 2)消融拆得比较诚实。
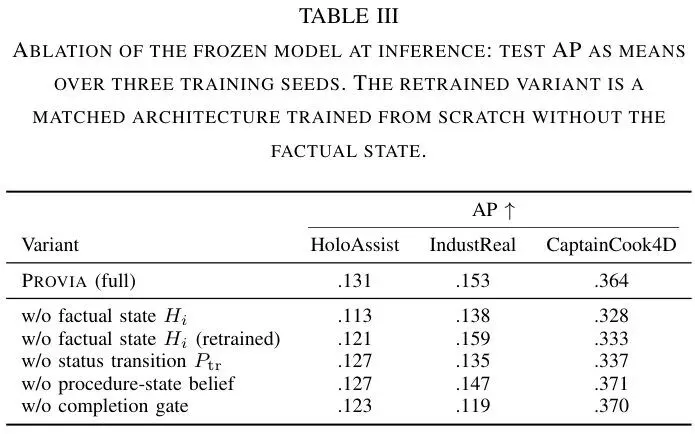
▲ 冻结模型在推理时的逐项消融,指标是测试 AP:去掉事实状态 H 后三个单执行者基准全部下降,HoloAssist 从 .131 到 .113,IndustReal 从 .153 到 .138,CaptainCook4D 从 .364 到 .328(论文 Table III)争议最大的一项是过程状态后验 B。它在步骤级几乎没有贡献,作者自己给了原因,合并后的自动机接近线性,一个状态平均只允许 1.01 到 1.18 个后继步骤,合并只把演示前缀树压缩了 1% 到 14%。在接近线性的自动机上做信念传播,除了「走到哪了」之外提供不了多少信息。这个结论对后面做任务图的人是负面的,如果流程本身退化成一条链,花力气维护状态分布不如维护位置。
完成门控在 IndustReal 上最有用(.119 对 .153 的差距),在 CaptainCook4D 上反而不帮忙,那个基准靠的是状态转移。原因也给了,CaptainCook4D 有 .318 的步骤是错的,四个基准里错误率最高,一条菜谱平均只有 3.9 次完全正确的执行,自动机实际上只是大约四条轨迹的前缀树,而状态转移是从所有训练执行里估的,样本多得多。
🧭 位置与局限
这篇的贡献分两层。一层在协议,把「截断在第一处错误、把最后一个段标成错误、算 F1」这套规则拆开,用四个可复现的测量说明它奖励位置先验;另一层在方法,给出一个在线系统,把「实际做过什么」和「接受了什么进度」分开记,配上带误报预算的报警规则。
方法选择也值得说清。任务图上做精确滤波这件事本身不新,DTGL 就用可微任务图做过前瞻。这篇的不同在于把滤波器限制在「已接受的进度」这一侧,错误分支不改状态,让事实状态单独承载「发生过什么」。有了这个拆分,错误之后还有纠正的流程才读得下去。
局限同样实在。召回绝对值低,0.1 预算下 .154 意味着大量错误没被报出来,离工业部署还远;自动机接近线性,过程状态后验的收益被消融证明很小,这套表示在当前的流程数据上没有被用满;分割模型是监督训练的,错误监督不能改它,所以段边界的质量决定了上限;两只手的设定只在 IMPACT-ego 一个基准上验证过;查询时需要知道任务名才能选参考演示集,真实场景里任务识别本身是个前置问题;数据集里完全正确的执行很少,CaptainCook4D 一条菜谱平均 3.9 次,自动机归纳的样本量受限。
对做第一人称助手、工业质检、教学纠错的人,这篇的实用价值一半在方法一半在那套评测。旧协议上刷出来的分数不能再当基线比,这一条比它自己的 .154 更重要。