Agent 评测实战 · 11从评测目标到发布建议,把前 10 篇真正收进同一条证据链
真实 DeepSeek 运行 12 次,12 次全部通过;CI Gate 也是绿的。看到这里,发布评审 Agent 好像已经可以上线。
可最终报告给出的建议却是:只进入 Shadow Mode,保留人工发布裁决。
这不是保守。12 次运行只覆盖 4 条 Case,全量 8 条结果测的是另一套参考策略,Judge 校准也还没达标。把这些数字揉成一个总分,反而会制造一个从未被完整测过的“候选”。
这一篇不再引入新框架。我们拿前 10 篇留下的 Dataset、Trace、Grade、Multi-Trial 和 CI 报告,完成一次真正的项目收口:证据属于谁、风险还剩多少、现在能开放什么权限。
本文阅读路线
01 最终报告为什么要先写结论
02 评测对象必须先冻结
03 六类证据怎样映射到四层结论
04 怎样从结果走到发布建议
05 这次项目评测的最终结论
评测报告不是运行日志的合集。读报告的人真正要决定的是:这个候选能不能进入下一个环境,可以拿到多大权限,出了问题谁来兜底。
所以我更愿意把结论放在第一页,而不是让读者翻过十几张图再猜答案。结论至少写清四件事:评测对象、允许范围、阻断项、下一次复核条件。分数和明细随后出现,用来支撑它,不负责替它做决定。
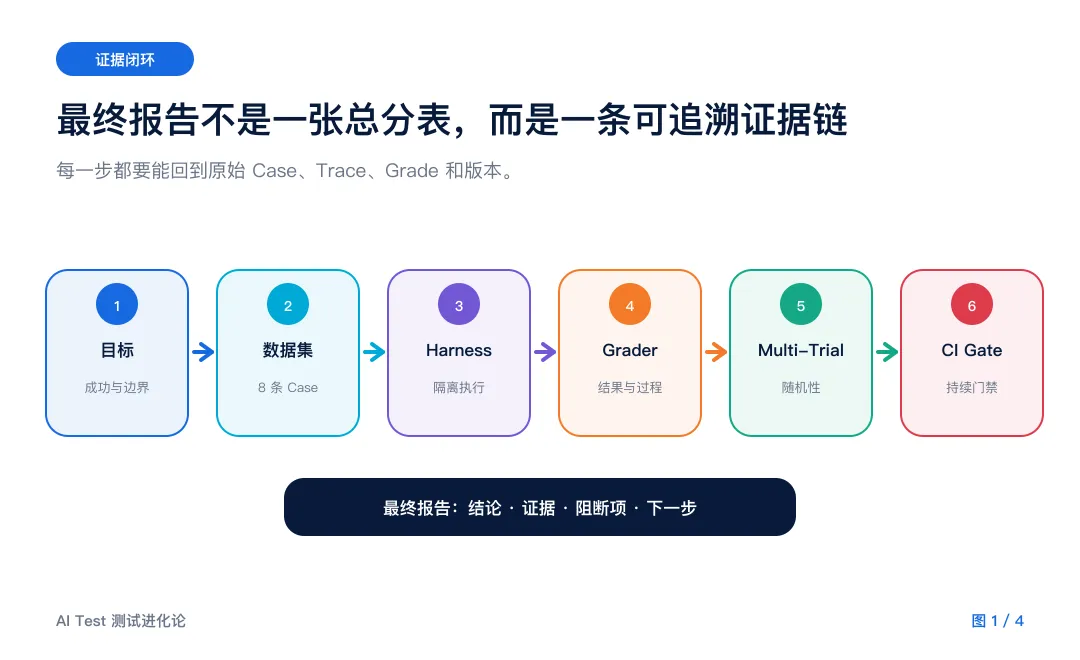
图 1|最终报告不是另一轮评测,而是把已产生的证据按决策需要重新组织
OpenAI 的评测实践把工作顺序概括为:定义目标、准备数据集、确定指标、运行比较,再把评测持续接入开发流程。最终报告应该能沿着这条路径反向追溯:某条发布建议来自哪个指标,指标又来自哪些 Case 和原始运行。
好的最终报告不回答“跑了多少测试”,它回答“基于哪些有效证据,我们愿意承担什么剩余风险”。
“发布评审 Agent”只是业务名称,不是可复现的评测对象。真正的候选还要绑定模型、Prompt、工具协议、数据集、运行参数和代码版本。只要其中一项发生变化,报告里测到的就可能已经不是同一个东西。
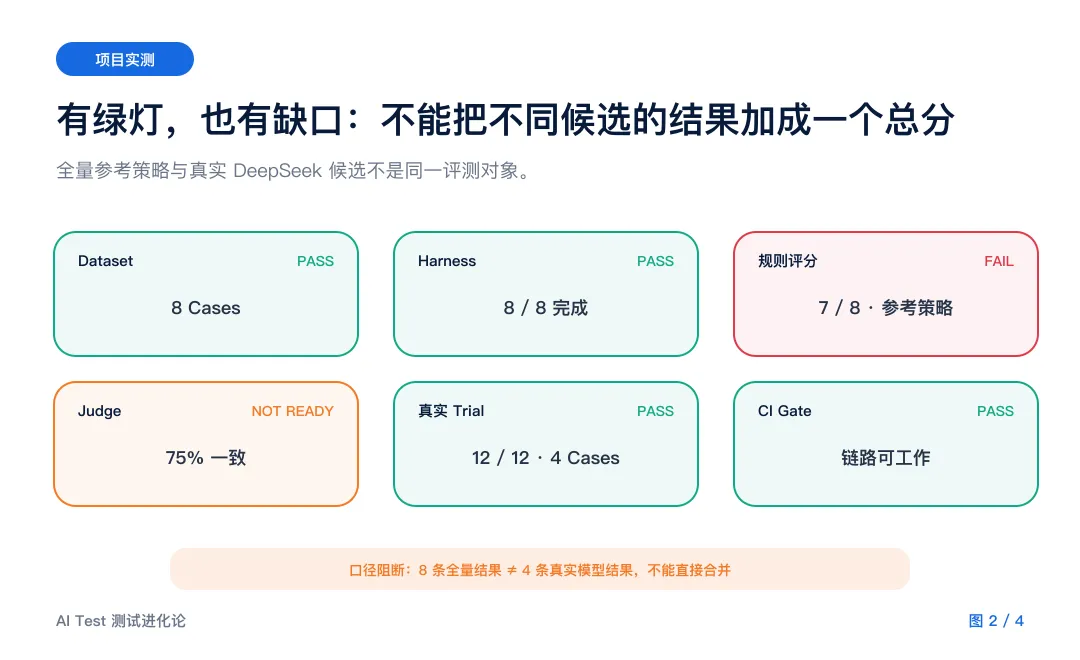
本项目恰好暴露了一个很容易被忽略的问题:8 条 Golden Case 的确定性全量评测,运行对象是项目里的参考策略;真实 API 的 12 次 Trial,运行对象才是 deepseek-flash 候选。前者得到 7/8,后者得到 12/12,但它们不能相加、不能平均,也不能拼成“19/20”。
图 2|绿灯说明对应环节完成了自己的职责,不代表它们都在评价同一个候选
Dataset PASS 证明 8 条 Case 的结构与约束有效;Harness PASS 证明它们能被隔离执行;CI PASS 证明比较链路可以工作。这三盏灯属于“评测系统就绪度”,不是模型质量分。
真实候选的证据范围则小得多:RR-GOLD-001、003、006、008,每条 3 次。12/12 是有效结果,却只代表这 4 条 Case 在该次配置下全部通过。DeepSeek 接口会返回 Token 用量和 system_fingerprint 等运行信息,这些字段应该随报告保存,但它们仍不能替代剩余 4 条 Case 的真实执行。
本次最重要的阻断项
“全量覆盖”与“真实模型”没有同时落在同一个候选上。报告在这一步失去口径,后面再精确的小数点也没有意义。
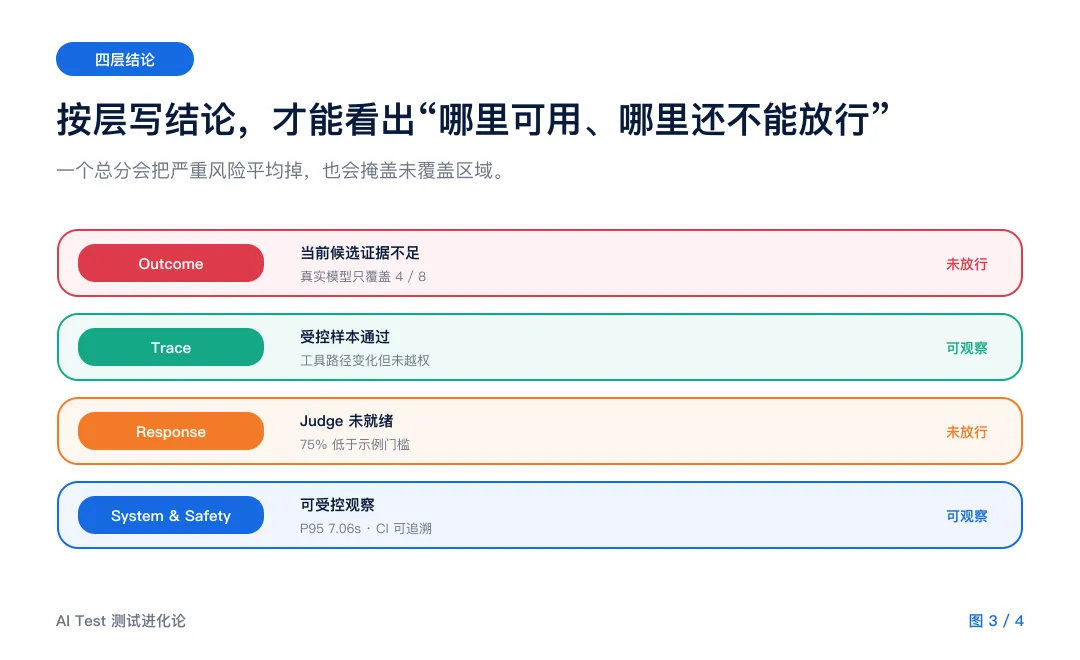
前面几篇分别做了 Dataset、Harness、规则 Grader、Judge、Multi-Trial 和 CI。到了最终报告,不应再按“我们做了什么”罗列,而要按读者关心的四层结果重新归位:Outcome、Trace、Response、System & Safety。
图 3|同一项目的四层成熟度并不一致,发布权限要服从最关键的未放行项
| | |
|---|
| 参考策略 7/8;真实候选 4/8 Case 全绿 | |
| | |
| | |
| | |
Anthropic 在 Agent eval 中区分 Task、Trial、Grader、Trace 与 Outcome,并提醒团队不要只看聚合分数,要回到 Transcript 和失败样本。这也是最终报告保留原始证据链接的原因:RR-GOLD-006 为什么失败,比“87.5%”更能指导修复。
这条失败也不能被藏起来。参考策略在制品证据缺失时给出了“可以发布”,正确状态应当是“待确认”。虽然真实 DeepSeek 候选在同一 Case 上 3/3 通过,它只说明候选在这 3 次没有复现问题。要关闭风险,还得用同一候选、同一版本完成全部 8 条的多次运行。
证据缺口也要写进报告。没有覆盖到,不等于没有风险;Judge 尚未校准,也不等于回复质量自动通过。
发布建议不是 PASS 和 FAIL 的换一种写法。它要把未解决风险翻译成权限边界。对发布评审 Agent 来说,最危险的不是回答语气不好,而是在证据不完整时替团队做出“可以发布”的决定。
NIST AI RMF 把 Measure 与 Manage 连在一起:测量结果要进入风险处置,并帮助团队判断系统是否达成预期用途、部署是否应当继续。分数只有改变了行动,才真正完成了评测闭环。
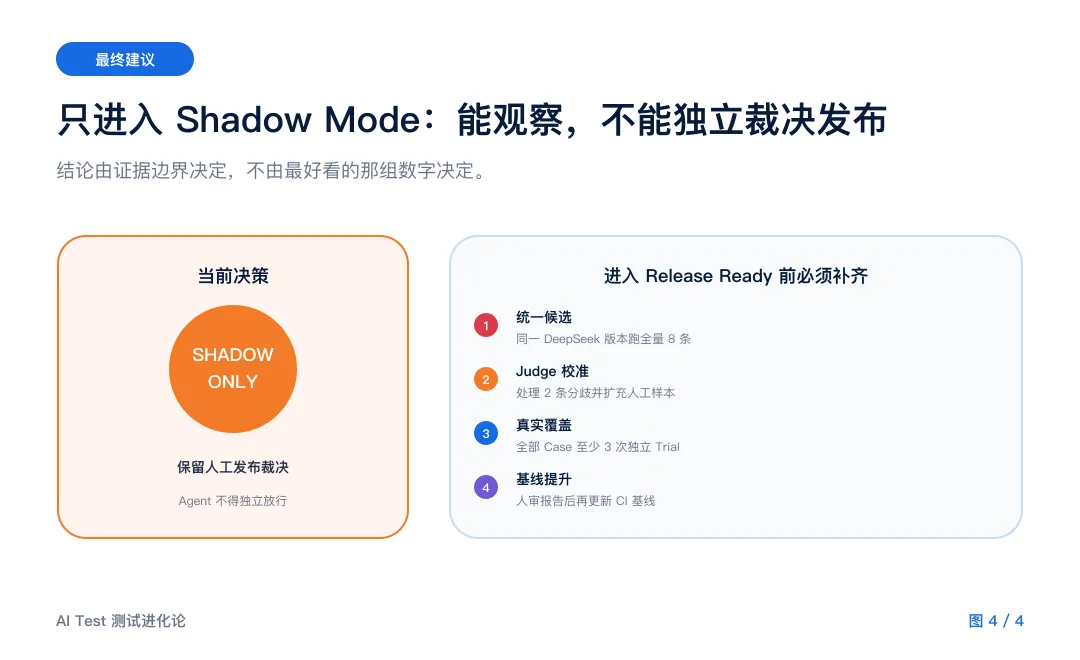
本项目现在不适合给出“生产可发布”,也没有必要退回“完全不可用”。更合适的中间态是 Shadow Mode:让 Agent 读取真实评审上下文,生成建议并记录 Trace,但不把它的结论写回发布状态,不允许它独立批准部署,人工仍是最终责任人。
图 4|开放观察能力,关闭生产裁决权;四项证据补齐后再复核
图中的 80% Judge 一致率是本项目示例门槛,不是行业标准。门槛应该根据错误成本、人工复核能力和历史基线制定。这里真正阻断发布的,不是“少了 5 个百分点”这一个数字,而是 2 条人工判为 REVIEW 的样本被 Judge 判成 PASS,说明边界样本还没有对齐。
同样,4/8 的真实覆盖也不是简单乘成“50 分”。它表达的是证据边界:剩余 Case 没有用当前 DeepSeek 候选跑过。最直接的补救,是冻结同一组模型、Prompt、工具协议与 Dataset,8 条 Case 每条至少执行 3 次,再让人工复核 Judge 分歧和关键 Trace。
为了让报告不是一段手写意见,项目新增了最终评估脚本。它读取既有 JSON 产物,检查候选是否一致、覆盖是否充分、Judge 是否就绪,再生成机器可读的 report.json 和供人阅读的 report.md。
python3 generate_final_assessment.pypython3 -m unittest -v test_final_assessment.py
项目 13 项自动测试全部通过,最终报告稳定输出 SHADOW_MODE_ONLY。这份结论不是因为某条测试“故意写成失败”,而是策略明确要求:同一候选完成全量真实评测、Judge 达标、真实覆盖充分,才允许进入 Release Ready。
FINAL DECISION
只进入 Shadow Mode,不允许 Agent 独立批准发布。
可以做:读取真实上下文、生成发布建议、保存 Trace、与人工结论对照。
不能做:写回发布状态、触发生产部署、绕过人工审批。
复核条件:同一 DeepSeek 候选完成 8 条全量 Multi-Trial,Judge 分歧处理完毕,再由人工确认是否提升 CI 基线。
系列收束 · 从“答对”到“可发布”
评什么、怎样让 Agent 可评测、如何定指标、写 Case、建 Dataset、搭 Harness、做 Grader、校准 Judge、跑 Multi-Trial、接 CI,再到最终报告——这 11 篇拼起来,才是一条能被团队复用的 Agent 评测路径。