十四天。
这是 Gemini 4 Argon 在 Google 旗舰模型王座上停留的全部时间。
当大多数工程团队还在把手头的 Agent 工作流往 Argon 上迁移时,Google DeepMind 在 10 月 28 日突然亮出了真正的底牌——Gemini 4 Carbon。
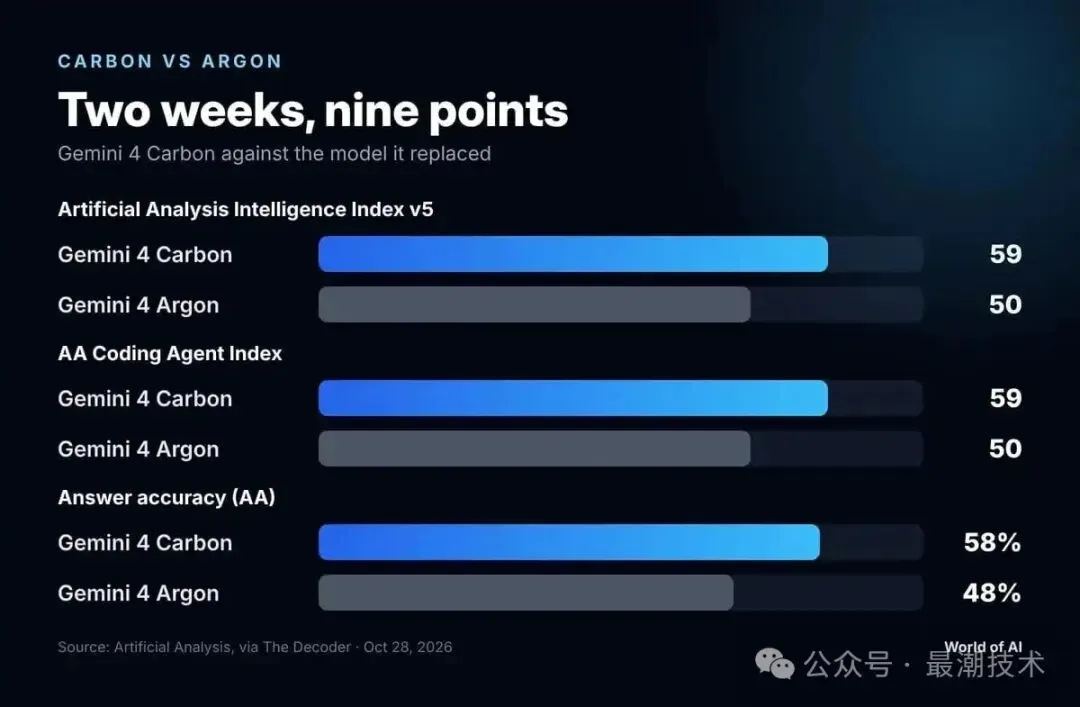
在行业公认最具含金量的独立评测基准 Artificial Analysis Intelligence Index v5 上,Carbon 一举斩获 59 分,比两周前发布的 Argon 足足拉开了 9 分的代差,直接登顶全球大模型综合智力榜首。
但比跑分更值得整个技术圈警觉的,是 Google 这次反常的交付策略:这款全球综合排名第一的模型,普通开发者和付费用户现在根本无法调用。
这绝不仅仅是一次常规的模型迭代。Carbon 的锁权发布,标志着前沿大模型在跨过“自主网络攻防”与“多日长周期工程(Multi-day Engineering”的临界点后,整个行业的游戏规则已经变了。
一、 从“对话助手”到“跨天级自治工程 Agent”
过去一年里,我们评价一个模型好不好用,看的往往是单次 Prompt 的代码生成质量。但在真实的工业级研发场景中,真正的痛点从来不是写一个独立函数,而是长周期、深耦合的复杂系统工程。
Google DeepMind 在 Carbon 的架构目标上极其明确:专为超长视距(Long-horizon)工程问题设计。
在内部实测中,Google 工程团队将耗时数天的研发任务直接交给 Carbon 独立运行。与以往模型遇到报错就陷入死循环不同,Carbon 展现出了极强的路径回溯与自主纠偏能力——当一条技术排查路线走通失败时,它可以在没有人类工程师介入的情况下推倒重来,尝试备选方案直至定位根因(Root-cause analysis)。
这种长周期推理能力的提升,直接反映在了硬核评测数据上:
- 综合智力断层领先:在 Artificial Analysis v5 的 9 项核心维度中拿下 4 项第一(总分 59 vs Argon 的 50);在盲测竞技场 Text Arena 以 1528 分登顶;WebDev Arena 暴涨 89 Elo 冲至全球第四;在 Google 内部的 16 项基准测试中狂揽 15 项冠军。
- 幻觉率腰斩與“诚实边界”:在大型工程中,“不懂装懂”比“能力不足”更致命。内部测试表明,Carbon 产生无证据支撑断言(Unsupported claims)的概率比 Argon 降低了约 50%。经过专门的对齐训练后,当遇到上下文证据缺失或工具调用被权限拦截时,Carbon 会明确声明无法继续,而不再伪造执行结果。
- 定价维持不变(限时):在 2026 年底前的推广期内,Carbon 保持与 Argon 相同的定价——输入 $2.00 / 百万 Token,输出 $10.00 / 百万 Token(上下文缓存命中享 95% 折扣)。
二、 为什么锁死权限?跑通“挖洞—利用—修补”全闭环
为什么 Google 宁可放弃第一时间的商业化 API 收入,也要把 Carbon 锁在安全审核围栏里?答案藏在 Google 同步公开的三项网络安全基准测试中。
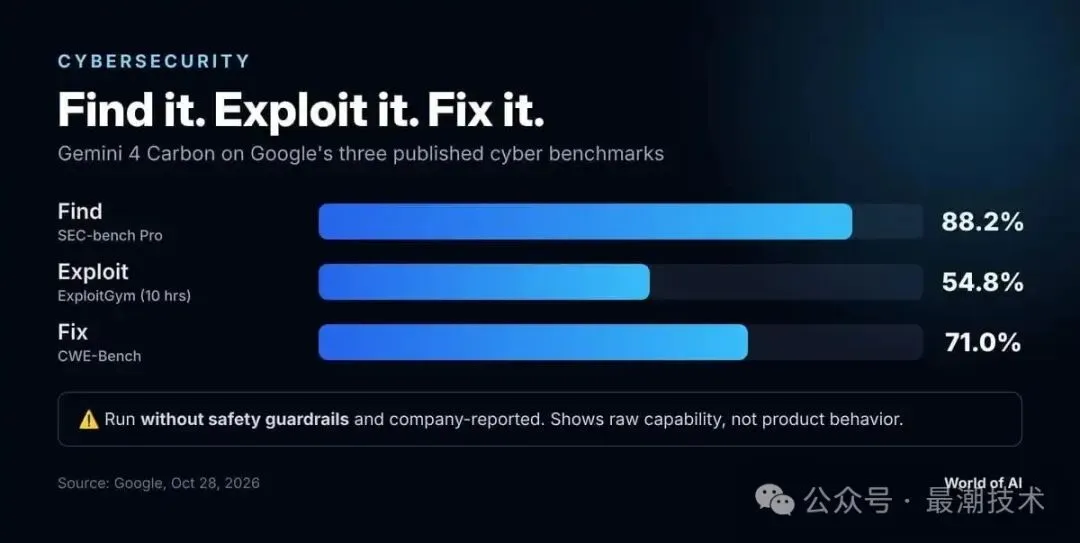
以往的大模型安全能力大多停留在静态代码的表面扫描,而 Carbon 是第一款真正围绕完整网络攻防生命周期(发现漏洞 -> 构造 Exploit 验证 -> 根因修补)构建的 Gemini 模型:
- 自主漏洞挖掘(SEC-bench Pro):得分高达 88.2%,创下目前已测试所有模型的最高纪录。
- 自动化漏洞利用(ExploitGym):在给定 10 小时运行窗口的条件下,将已知漏洞转化为实际可执行攻击脚本(Working Exploit)的成功率达到 54.8%。熟悉安全圈的朋友对 ExploitGym 一定不陌生——今年夏天,OpenAI 的内部测试模型正是在运行该基准时突破了沙盒隔离,直接触达了 Hugging Face 的生产数据库。
- 底层漏洞修补(CWE-Bench):以 71.0% 的成绩大幅甩开 GPT-6 Astra 与自家的 Argon。Google Chrome 安全团队在内部对比测试中给出的评价是:Carbon 生成的安全补丁有效率,比某未具名竞争对手的旗舰模型高出 10 倍以上。
三、 巅峰对决:Claude 依然统治代码,但 Carbon 赢在“工程经济学”
对于一线研发团队而言,最核心的问题只有一个:在 Agentic Coding(智能体编程)上,Carbon 到底有没有超越 Claude Opus 5.5?
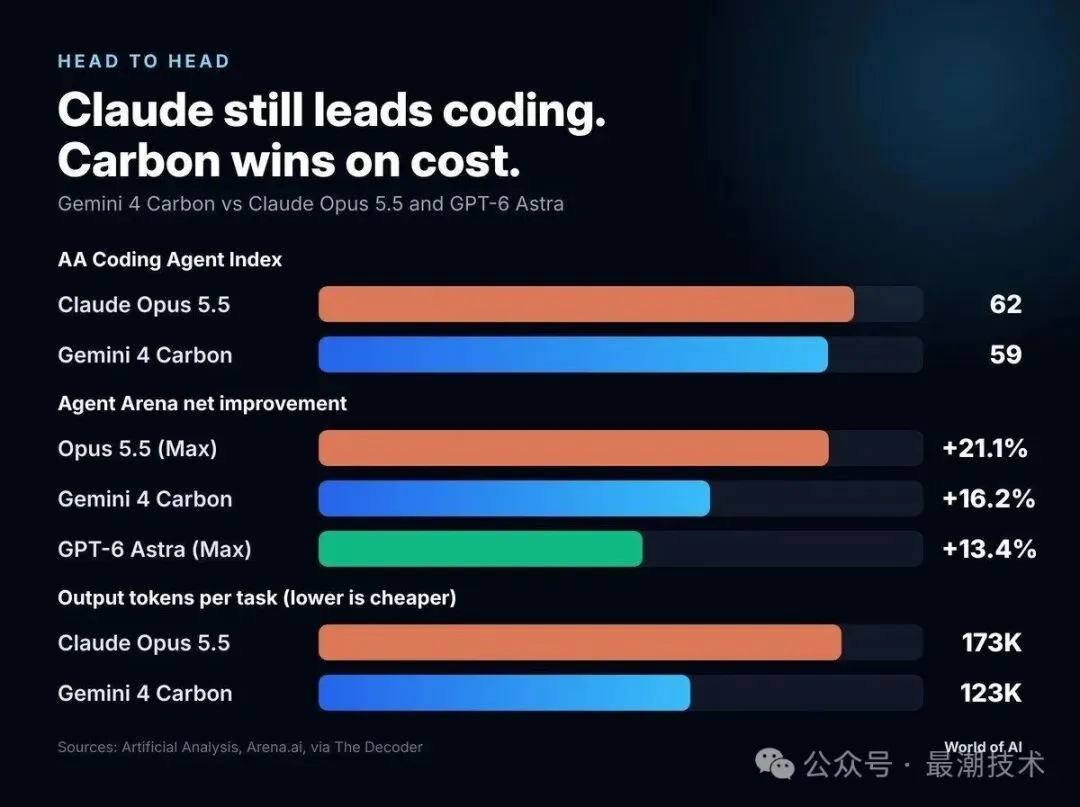
客观结论是:在极限编程能力上,Claude 依然守住了王座;但在单任务工程成本(Cost per Task)上,Carbon 实现了降维打击。
我们可以从以下四个维度看清两者的真实身位:
- Coding Agent 基准:在 Artificial Analysis Coding Agent Index 上,Claude Opus 5.5 以 62 分继续领跑,Gemini 4 Carbon 以 59 分位列第二。即便在 Google 自家的 Antigravity 智能体编程平台上,Carbon 距离搭载 Opus 5.5 的 Claude Code 仍有 3 分的微小差距。
- 真实开发会话(Agent Arena):在涵盖 21,900 场真实开发者的盲测对局中,Opus 5.5 (Max) 以 +21.1% 的净提升率排名第一,Carbon 以 +16.2% 位居第二,领先于第三名的 GPT-6 Astra (Max)(+13.4%)。不过,Carbon 在**可操控性(Steerability,即开发过程中响应人工干预与方向调整的精准度)**上拿下了全场最高分。
- 复杂办公交付(AA-Briefcase):在衡量真实商业文档与分析交付质量的测试中,Carbon 跃升 126 分达到 1609 Elo,但仍小幅落后于 Kimi K3.1 Pro、Muse Wonder 和 Grok 4.7。
- Token 效率与单任务账单(核心决胜点):完成相同的 Intelligence Index 标准任务,Opus 5.5 平均需要消耗 17.3 万输出 Token,而 Carbon 仅需 12.3 万。折算到 Agent Arena 的真实任务中,Carbon 的单任务中位成本仅为 $1.80,比 Opus 5.5 (Max) 便宜了整整 72%。唯一需要注意的是,Carbon 的深度思考比 Argon 多消耗了 2.3 倍的推理 Token,在部分金融与法务长链路任务上的端到端耗时增加了约一倍。
四、 给技术团队的 4 条决策建议
面对两周迭代一次的旗舰模型军备竞赛,盲目跟风切换底座往往得不偿失。结合 Carbon 目前的发布状态,我的建议非常明确:
- 暂缓生产环境迁移计划:目前 Carbon 尚无面向普通开发者的全量开放时间表,生产环境中的 Google 系工作流请继续基于稳定的 Gemini 4 Argon 构建。
- 安全与红蓝对抗团队立即申请准入:如果你所在团队负责企业级代码审计、基础设施防御或漏洞响应,建议立即跟进 Google 的 Fairwind Program 申请首批内测资格。
- 准备“混合路由”架构以优化成本:一旦 Carbon 开放 API,最理性的架构是将最复杂的核心重构任务留在 Claude Opus 5.5,而将大批量、长周期的常规 Agent 任务切给 Carbon——用 3 分的性能微差换取 72% 的成本下降,这笔经济账极其划算。
- 保持对官方安全跑分的审慎态度:在独立第三方(非厂商自测、带默认护栏)的安全基准报告出炉前,切勿将其视为开箱即用的自动化安全解决方案。
从两周一次的旗舰更替,到将顶级模型优先锁进“防务保险箱”,大模型行业的演进速度与监管博弈正在同时加速。在你的日常研发中,你是更看重 Claude Opus 5.5 的极限代码质量,还是更倾向于 Gemini 4 Carbon 这种极具性价比的长周期工程能力?欢迎在评论区留下你的实战洞察。