微软研究院公开了一套企业级评测数据生成平台,核心做法是:不碰客户真实数据,而是用公开数据源“长”出完整的企业租户,再在租户里自动生成评测查询。资料给出的三个基础来源是O*NET职业数据、在线招聘启事和SEC文件。
这套平台要回答两个问题:Copilot是否真的做了用户需要的事,以及能否在不接触用户数据的前提下证明这一点。对关心AI评测数据从哪来、怎么保证覆盖度的人来说,它的取舍值得逐层拆开看。
真实企业数据不能用于评测
资料把矛盾说得很直接:企业级AI评测需要能反映真实组织复杂度的测试数据,包括汇报关系、项目历史、沟通模式、领域工作流;但真实企业数据含敏感信息,在任何情况下都不能用于评测。
图|基准任务性能对比
微软的选择不是缩小测试规模,而是生成全尺寸合成环境。每个模拟工作区在内部称为“租户”,是一个隔离的组织环境,有自己的用户、数据和配置,团队可以在此基础上继续构建。
这里有一个容易忽略的边界:合成环境追求的是结构性和行为性属性,而不是复刻某一家真实企业。全合成不等于真实客户数据的替身,它替代的是“小规模人工测试样本”这种评测方式。
三类公开数据撑起组织骨架
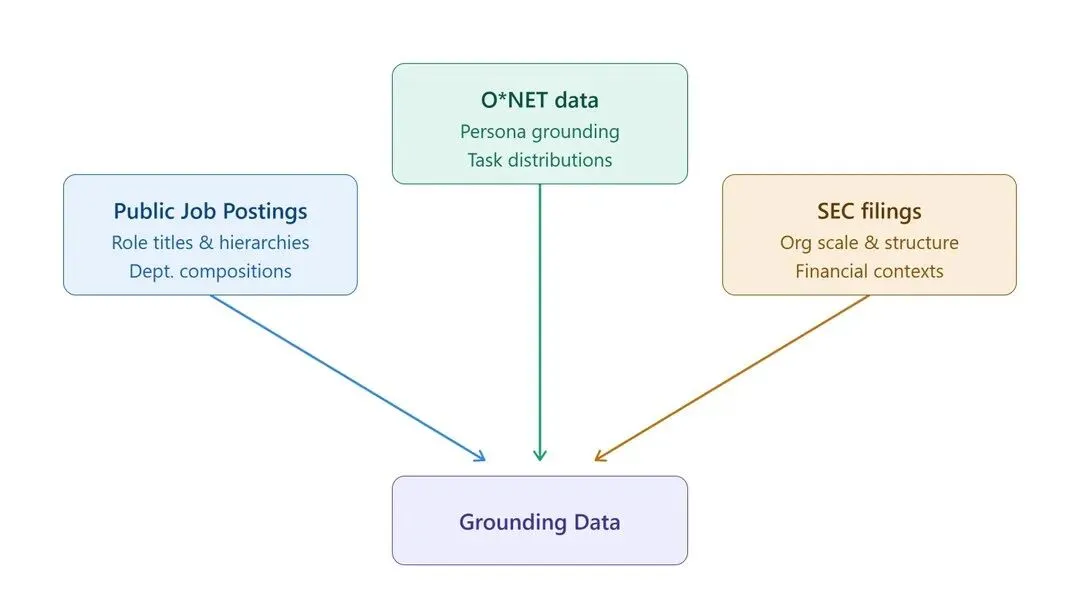
合成环境要像真的,先得让岗位、层级和业务上下文站得住。O*NET来自美国劳工部的职业数据库,用来让合成员工的角色和职责更可信,并校准不同角色的工作活动组合与频率,以及临床试验评审、投资组合更新这类行业工作流。
在线招聘启事提供真实的职位名称、汇报层级和部门构成;SEC文件则影响组织规模、业务单元结构和财务语境。资料称这些来源均为公开数据,并经过微软法务与政策组织审核批准。
这三个来源各管一段:职业数据管“人做什么”,招聘启事管“组织怎么排”,SEC文件管“公司有多大、钱怎么走”。单看任何一类都不足以支撑企业评测,组合起来才形成可运行的骨架。
时间维度决定查询能否被评测
资料特别强调,合成环境不是静态快照。它模拟随时间演化的组织:会议历史、项目时间线、跨越数周发展的邮件线程,以及自然发生的组织变化。
原因是一大类Copilot查询本身带时间属性。“团队上周四决定了什么”“上次季度评审以来有什么变化”,这类问题只有在底层数据具备真实时间结构时,评测才有意义。
这也是合成数据常被质疑的地方:如果环境只有一份文档和一次会议,模型答对可能只是碰巧。时间结构是评测有效性的前提条件,不是锦上添花的真实感装饰。
资料展示了三个行业的合成环境:制药环境包含监管提交工作流、临床试验讨论和跨职能安全评审会议;资本市场环境包含交易管线、合规沟通和客户投资组合评审;IT与软件公司环境模拟冲刺规划和相关研发流程。
自动查询与安全校验如何配合
平台由三根支柱组成:合成企业环境、自动化查询生成流水线、结构化质量框架。查询流水线追求快速且可复现地产出评测数据集,质量框架则负责判断合成数据是否达到有意义评测的门槛。
安全与隐私是设计内置的:每个环境完全合成,自动化内容安全检查确保生成数据不含有害材料或可识别个人身份的信息。资料没有披露检查项的具体清单和误判率。
资料称这套体系建立了Copilot的第一个标准化评测基线,但未给出基线包含多少任务、覆盖哪些能力维度、与通用基准的对比数字。这些空白决定了它目前更适合被理解为方法论披露,而非可直接复用的评测指标。
资料明确验证的是合成环境生成与查询自动化流程,未验证合成环境对真实企业分布的覆盖程度。
另一个未验证的问题是:用公开数据校准出的岗位与工作流,能否代表监管严格、数据高度敏感行业的真实使用形态。制药和资本市场环境只是模拟,资料没有给出与真实组织行为的偏差测量。
因此,这套方法能回答“评测是否绕开了客户数据”,但还不能回答“合成环境漏掉的问题有多严重”。后者需要偏差评估,而资料中没有这部分结果。
项目合作
正在推进数据采集、标注或模型评测?打开公众号菜单“联系慧链”,告诉我们数据类型、规模和交付时间。