让真实运行成为评测素材:Agent Insight如何将Trace转为评测集
- 更新时间 2026-11-01 11:08:07
Agent每天都在处理真实问题:理解用户意图、调用工具、执行任务,再给出回答。这些过程被记录为Trace,帮助开发者查看执行路径、定位异常、分析问题。
但当团队准备修改提示词、更新Skill,或者调整工具配置时,往往还要做另一件事:准备一批评测案例。
用户问过的问题已经留在运行记录里,Agent的回答也有迹可循,可整理评测集时,仍需要逐条翻看记录、复制输入输出、清理重复内容,再导入平台。运行记录不断增加,能用于评测的案例却需要重新准备。
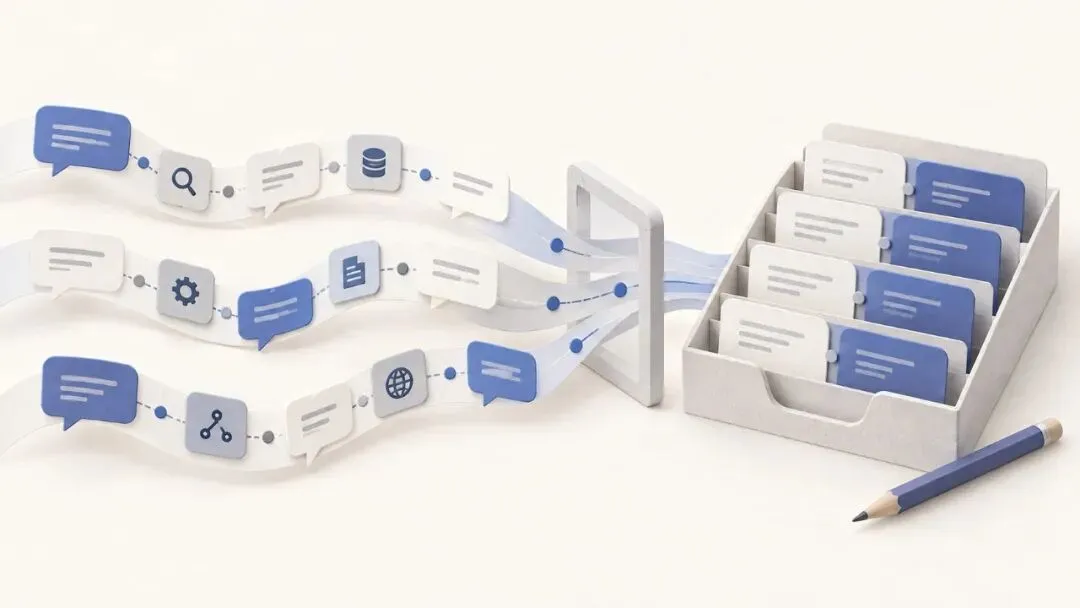
Agent Insight的"基于Trace生成评测集"功能,将这段准备流程接了起来:从已有运行记录中提取问答、合并重复项,并在设定的数量上限内选择样本,生成可继续审阅和编辑的评测集。
这让真实请求有机会从一次运行记录,变成后续版本迭代中可以反复使用的测试素材。
PART 01
Trace中已经有哪些评测素材?
一条Trace通常包含用户输入、助手回复,以及执行过程中的工具调用等信息。用户提出的问题和Agent给出的最终回答,是构建问答评测案例的直接来源。
以一个简化的数据处理场景为例。用户提出请求:
将以下销售记录按产品汇总销量,返回JSON:产品A:12产品B:8产品A:5
Agent完成处理后回答:
在这条记录满足提取条件时,系统可以将它整理为一条评测数据:
{"A": 17, "B": 8} |
当前自动生成的结果是**"理想输出评测集"**,每条数据包含"输入"和"预期输出"两个字段。工具调用等执行信息可以参与样本选择,最终写入数据集的是提取出的问答文本。
对于开发者来说,这提供了一个明确的起点:先把真实发生过的请求整理出来,再检查它是否适合作为长期保留的评测案例。
PART 02
从Trace到问答,需要处理哪些细节?
真实运行记录的结构往往比一问一答更复杂。一条Trace可能包含多轮对话;一轮处理中,Agent可能先调用工具,再根据结果给出回答;有些执行没有完成,有些内容发生了截断。
因此,生成过程需要先确定:哪段文本是用户的问题,哪段回答真正属于这一轮,以及这组问答是否完整。
Agent Insight按用户消息划分轮次,检查输入和回答的结构归属,提取对应的最终助手回答。对于无法可靠配对、缺失回答或存在截断等情况的轮次,系统会跳过,并在本次生成的筛选明细中说明原因。
一条Trace可以贡献多条评测数据。 例如,三条Trace分别包含两轮、一轮和两轮有效问答,在去重前就可以得到五条候选。因此,Trace数量与最终生成的数据条数并不一一对应。
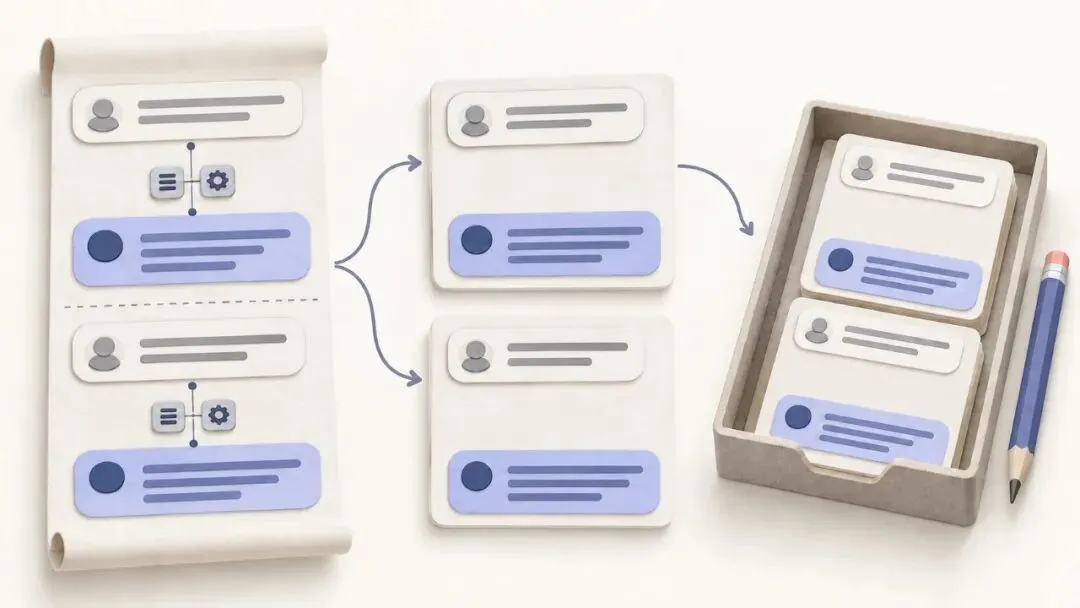
提取之后,系统还会按完整的输入和回答进行精确去重。同一组问答重复出现时会合并;同一个问题对应不同历史回答时,则可以保留为不同候选。
PART 03
当候选很多时,应该留下哪些?
假设一个Agent最近一周积累了几千条有效问答,而团队只准备生成 100 条案例。
直接取最近的记录,可能集中在某一时段的常见请求;随机抽样可以作为基线,但在数量有限时,也可能把多个名额分配给相似输入。团队更希望这 100 条案例能够包含更多不同的问题。
Agent Insight在生成流程中引入了智能采样。候选数量超过上限时,系统会综合考虑输入覆盖、长度分布和已有执行行为,选择具有互补性的问答;同一问题存在多个历史回答时,也会结合文本特征选择参考回答。
整个过程不需要额外调用LLM,也无需为该功能增加Trace采集字段。
这项能力让"生成多少条"之外,多了一层对"选出哪些条"的考虑。具体采用了什么方法、覆盖改善如何衡量,我们将在下一篇结合实验展开。
PART 04
在Agent Insight中如何生成?
使用前,需要确保目标Agent已经有Trace记录进入平台。之后,在页面中完成以下操作:
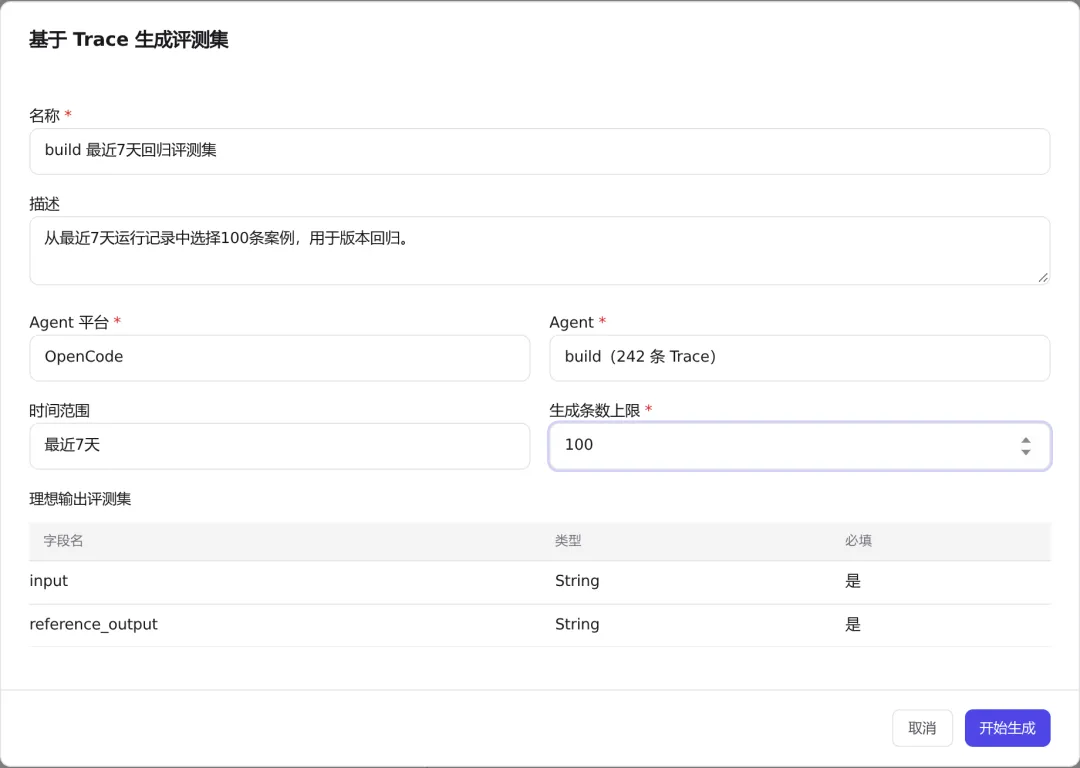
例如,准备整理某个Agent最近一周的使用情况,可以选择"最近 7 天",将生成条数上限设为 100,再开始生成。
这里的 100 是上限。经过有效性检查和去重后,如果候选不足 100 条,最终数量也会相应减少。一条多轮Trace又可能贡献多组问答,因此也不能仅根据页面上的Trace数推断生成结果。
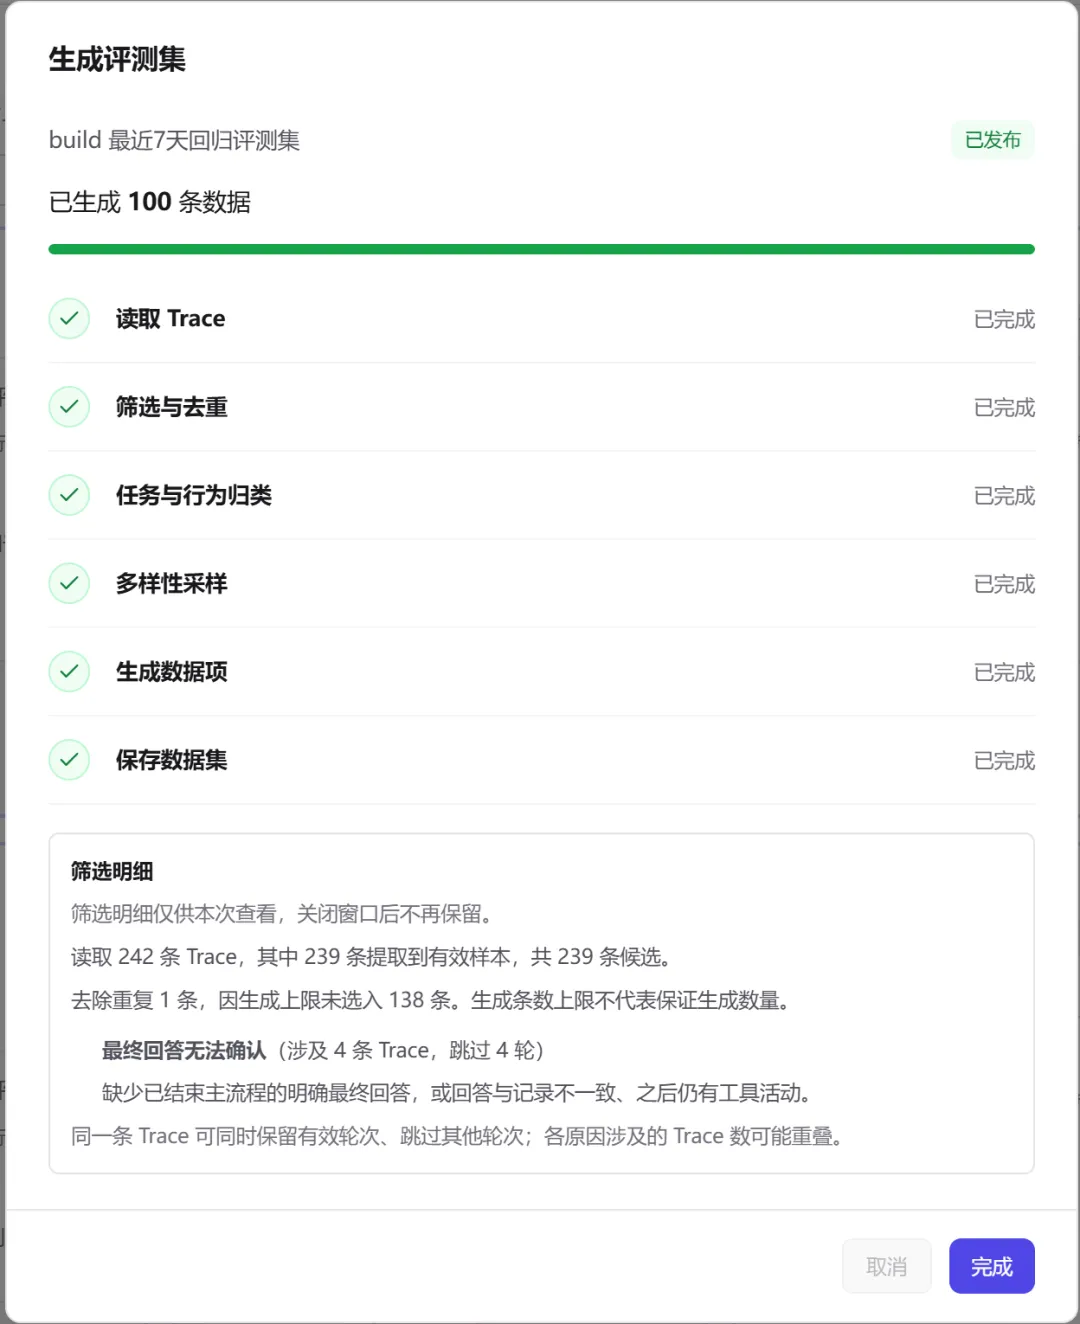
生成过程中关闭窗口或刷新页面,任务仍会继续;需要再次查看时,可以打开生成中的数据集卡片。
PART 05
生成后,还需要检查什么?
生成成功意味着问答已经完成整理,可以进入审阅和编辑环节。要把它们用于评测,还需要结合业务目标检查内容。
首先是参考回答的正确性。页面上的"预期输出"来自历史回答,而历史回答可能存在事实错误、遗漏,或者已经不符合当前业务规则。智能采样依据文本和结构特征选择样本,并不验证答案是否正确。发现问题后,应修改参考输出,或移除不适合的案例。
其次是输入是否具有足够的上下文。多轮对话中,"把第二项改成英文""再乘以 2"这样的请求,对当时的对话参与者很清楚,单独拿出来却缺少必要信息。当前生成过程不会自动判断每轮输入能否脱离历史独立执行。审阅时,可以补全必要背景,或移除无法独立使用的条目。
最后是评测目标。生成的集合应当包含团队真正想持续检查的问题。可以围绕业务需要,继续修改、补充和整理数据项,再将它用于后续版本回归。
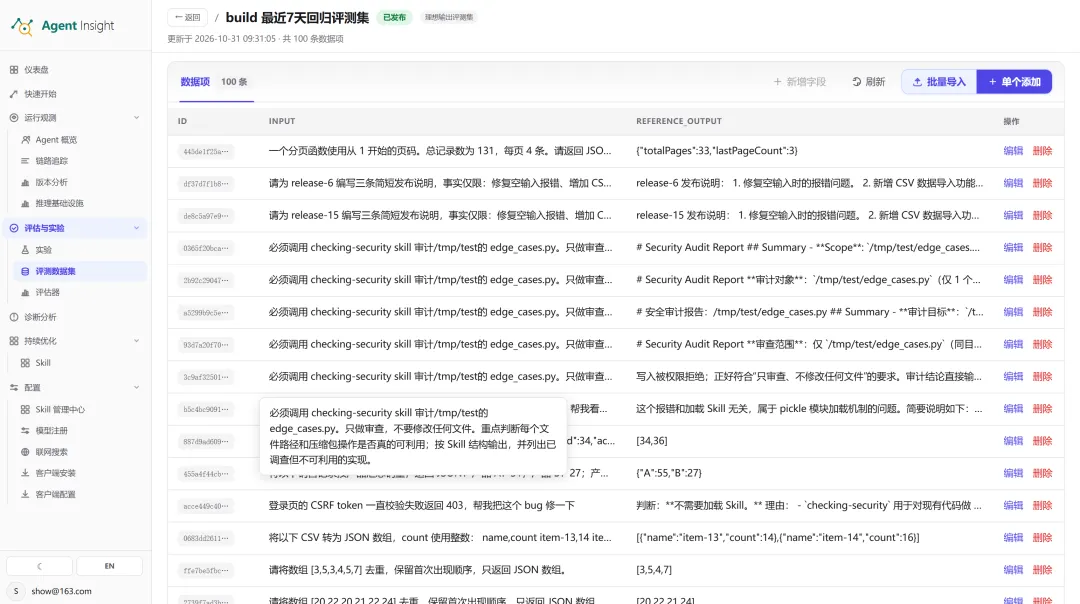
这样,每次准备评测集时,团队都可以从已有运行记录出发,把精力更多地放在案例审阅和业务判断上。
随着Trace持续积累,另一个问题也会变得越来越具体:当候选从几百条增长到几万条,而每轮仍然只能评测 100 条,该怎样分配这些名额,才能减少重复、覆盖更多不同的输入?
🔗 仓库地址(点击阅读原文可访问):https://atomgit.com/openeuler/agent-insight 📖 文档 / 使用指南:ttps://atomgit.com/openeuler/agent-insight/blob/master/docs/user-guide/home.md
🐛 在实际使用中遇到问题?来提 Issue,或直接反馈你的想法; ✨ 有新功能点子、想优化体验?欢迎提交设计或需求; 🔧 想动手写代码?认领任务、提交 Merge Request,你的代码会被看见; 📝 擅长文档或测试?完善说明、补充用例同样价值巨大。
PS:
最后,做个小小的推荐,目前正在进行的项目:
Agent Insight:openEuler孵化的项目,旨在让每一个Agent 都可被观测、可被评估、可自我进化。
AET(Agentic Engineering Team):openEuler孵化的项目,全流程 AI 辅助研发底座/引擎,覆盖从需求分析、设计、编码、测试到发布、运维的软件研发全生命周期。
Skill Radar:给Agent Skills技术画一张”活地图”,追踪Skills技术,让Agent能力进化有迹可循。
如果你对Agent Insight、AET感兴趣,欢迎参与进来,一起把它变得更好~~
🔗 Agent Insight:https://atomgit.com/openeuler/agent-insight
🔗 AET:https://atomgit.com/openeuler/agentic-engineering-team
更多Agentic AI技术前沿分享,欢迎扫描下方二维码进入技术交流群(或者添加群助手ID:qstarsky 邀请您进群交流)