【AI评测-第四节】你信奉的榜单正在慢慢失去作用,Benchmark不够看
- 更新时间 2026-10-31 12:52:48
AI 评测实战 · 第四节
上一节我们把评测集这条护城河挖好了——出题四原则、标注规范、负面场景题库,全是自己家的功课。但做评测不能只埋头自己出题,还得抬头看世界:MMLU、C-Eval、GSM8K……这些榜单分数天天被发布会引用,“XX 模型 MMLU 涨了 5 个点”满天飞。问题是:这些分到底在测什么?多高的分才够用?能信几分?这一节,把主流 Benchmark 一个个拆开,并带你本地亲手跑一遍完整流程。
Benchmark(基准测试)本质上就是一套公开的、标准化的评测集:题量固定、题型固定、判定脚本固定,谁都能下载来跑。它解决的是“横向可比”问题——你不能拿自家 100 条客服题去跟别家比,但可以拿同一份 GSM8K 跑分对齐。
它的价值与局限同样明显:
01横向可比:同题同规则,分数能对齐
局限 测的是通用能力,不是你的业务能力
02快速初筛:几十分钟筛掉明显不行的模型
局限 题目公开,存在被“背过”的风险
03社区共识:选型时有公共语言
局限 分数趋同后区分度下降(MMLU 高分段挤成一团)
真相:Benchmark 是“体检报告的参考值”,不是“录取通知书”——它告诉你这个模型整体健康水平,不能告诉你它能不能干你们公司那摊活。
01MMLU
能力域 英文学科知识(57 个科目)
题型 4 选 1 选择题
规模 约 1.4 万题
主指标 accuracy
适合用它看什么 英文知识面基线
02C-Eval
能力域 中文学科知识(52 个科目)
题型 4 选 1 选择题
规模 约 1.3 万题
主指标 accuracy
适合用它看什么 中文知识面基线
03GSM8K
能力域 小学数学应用题推理
题型 数值答案题
规模 8500 题
主指标 accuracy
适合用它看什么 数理推理链能力
04HumanEval
能力域 代码生成
题型 函数级编程题
规模 164 题
主指标 pass@1
适合用它看什么 代码能力(题量小,只做参考)
05AGIEval
能力域 人类标准化考试(高考/法考/公务员/竞赛)
题型 选择题+填空题
规模 多来源汇总
主指标 accuracy
适合用它看什么 高难度综合推理
看表就能发现一个关键事实:这五个全是“封闭题”——选择题或唯一数值答案,判定零歧义,所以能自动化跑分。但你的业务是开放生成:没有选项、没有唯一答案。这就是榜单分数和业务表现之间永远存在裂缝的根本原因。
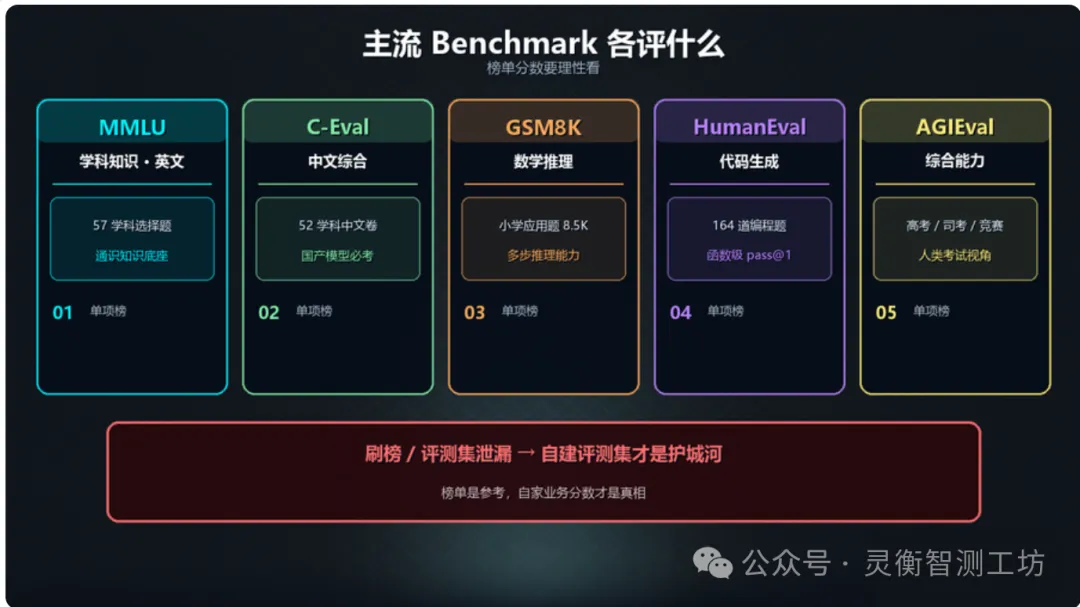
—图 1 · Benchmark解析
四条看分纪律,缺一条就会被数字骗:
纪律 1:只在同一榜单内横向比。 MMLU 的 82 和 GSM8K 的 82 没有任何可比性,一个是知识面、一个是推理链,加起来平均更是无意义操作。
纪律 2:看口径。 few-shot 数量(0-shot 还是 5-shot)、有没有开思维链、温度多少,口径不同分数能差好几个点。很多宣传页只报最高口径。
纪律 3:看置信区间。 样本量固定,分数本身有统计波动,accuracy 后面那个 stderr 才是误差棒——两个模型差 0.3 分就宣布“超越”,基本是噪音内自嗨。
纪律 4:高分不等于好用。 我们实测过:某模型 AGIEval 比另一家高 4 个点,但在金融客服负面场景上幻觉率反而高一倍。通用能力的排名,和你的业务场景排名,经常不是一回事。
一句话版本:同榜横比、对齐口径、盯住误差棒、最后用自家题复验——四步走完,榜单分数才值得写进选型报告。
两个机制会让榜单分数系统性虚高:
一是数据泄漏。 题目是公开的,可能在无意识(爬来的语料里本来就有)或有意识(定向收集)中混进预训练数据。结果就是模型“背过考卷”——GSM8K 90 分,换一道同难度的自编数学题掉到 70 分。这也是第二节反复强调“评测集保密”的公共版教训。
二是定向调优。 发布前对着榜单题目反复调 prompt、调采样参数、甚至微调,把分数“磨”上去。分数涨了,泛化能力没涨。
识别信号很统一:榜单分数与自建集分数出现大幅背离。榜单 +5,自建集 +0.5,甚至倒退——先怀疑泄漏和过拟合,再谈能力提升。
把两者放到决策流程里,分工就清楚了:
01候选模型海选
用什么 公开 Benchmark
为什么 几十个模型快速筛到 3-5 个,省时间
02入围终选
用什么 自建评测集(第三节那套)
为什么 业务分布、负面场景、自家红线,只有你的题测得出
03上线门禁
用什么 自建评测集 + 回归集
为什么 决策依据必须可控、保密、可版本化
真相:榜单决定“哪些模型值得进面试”,自建评测集决定“谁拿 offer”——把终选权交给公开榜单,等于让出题权交给外人。
光说不练假把式。以社区标准工具 lm-eval-harness 为例,从零到出分的完整流程:
# 1) 独立虚拟环境,避免污染工作区
python -m venv .venv
source .venv/bin/activate # Windows: .venv\Scripts\activate
# 2) 安装评测框架
pip install "lm-eval"
# 3) 第一次跑:先小规模验证流程通不通(GSM8K 前 200 题,5-shot)
lm_eval --model hf \
--model_args pretrained=Qwen/Qwen2.5-7B-Instruct,dtype=bfloat16 \
--tasks gsm8k --num_fewshot 5 \
--limit 200 --batch_size auto \
--device cuda:0 \
--output_path results/gsm8k_smoke/
# 4) 流程跑通后,正式评测多个能力域
lm_eval --model hf \
--model_args pretrained=Qwen/Qwen2.5-7B-Instruct,dtype=bfloat16 \
--tasks ceval-valid,agieval,humaneval \
--batch_size auto --device cuda:0 \
--output_path results/qwen25_7b_full/
# 5) 结果解读:重点看每个 task 的 accuracy 和 stderr
# results 目录下的 json 里,stderr 大于模型间分差 = 差异不可信
三个实战提醒:
·先 `--limit 200` 冒烟再全量,评测一跑几小时,环境问题要提前暴露;
·对照组要同口径:换模型对比时,few-shot、温度、dtype 全部保持一致,否则对比无效;
·把结果入库:模型名、版本、口径、分数、stderr 存成表——这就是你评测平台题库管理模块的雏形(第十八节展开)。
如果你是测试开发
本地跑通这套流程,本身就是环境搭建与环境管理能力的展示。进阶玩法:把 lm_eval 挂进 CI,每次基座/微调版本更新自动跑一轮 benchmark 回归,分数波动超阈值就报警——这就是第十九节“评测门禁”的雏形。
如果你是 AI 评测
你的报告里引用任何榜单分数,都必须带口径:几 shot、什么版本、stderr 多少。养成这个习惯,你的选型建议才经得起追问;再配上自建集交叉验证,别人就没法用一句“我看榜单不是这样”推翻你。
如果你是全栈开发
选模型别只看发布会分数。花半天时间:把候选模型的 API 各跑一遍你自己的 50 条业务题,人工判一遍——这个粗筛结果,比任何榜单都贴近你的真实体验。
一句话总结这一节:
榜单分数是参考值,不是诊断书——初筛看榜单,决策靠自建评测集,这是评测人的基本修养。
分数会跑了、榜单会看了,但有一个维度,选择题榜单永远测不出来,又最容易把产品送上热搜:一本正经地胡说八道。编一篇不存在的论文、引一条不存在的条款——这比做错一道选择题严重一百倍。
幻觉评测:怎么量化“一本正经胡说八道”。
下一节,把幻觉这个最要命的维度量化掉。
👇 直接加我 V
加 V 私聊,回复关键词「评测」

扫码加 V 回复「评测」领课程资料
本文为「AI 评测全景实战」系列第 4 篇
往期:AI 评测全景图 / 指标体系:从准确率到 7 维框架 / 评测集建设
别再手写评测框架了——这次我直接给你一个能跑的!Vue3 + FastAPI + Harness,评测集 / 指标 / 评估器 / 流水线 / 报告全链路可演示
【评测第二节】AI Agent 评测体系:四层质量评估框架拆解
下期:幻觉评测
👇 想直接拿去用
加我微信,回复关键词「评测」,领这一节的评分卡模板、评测集样例与跑分脚本
cheerupSq
— 扫码加 V,备注「灵衡智测」
微信号 cheerupSq,备注「灵衡智测」
