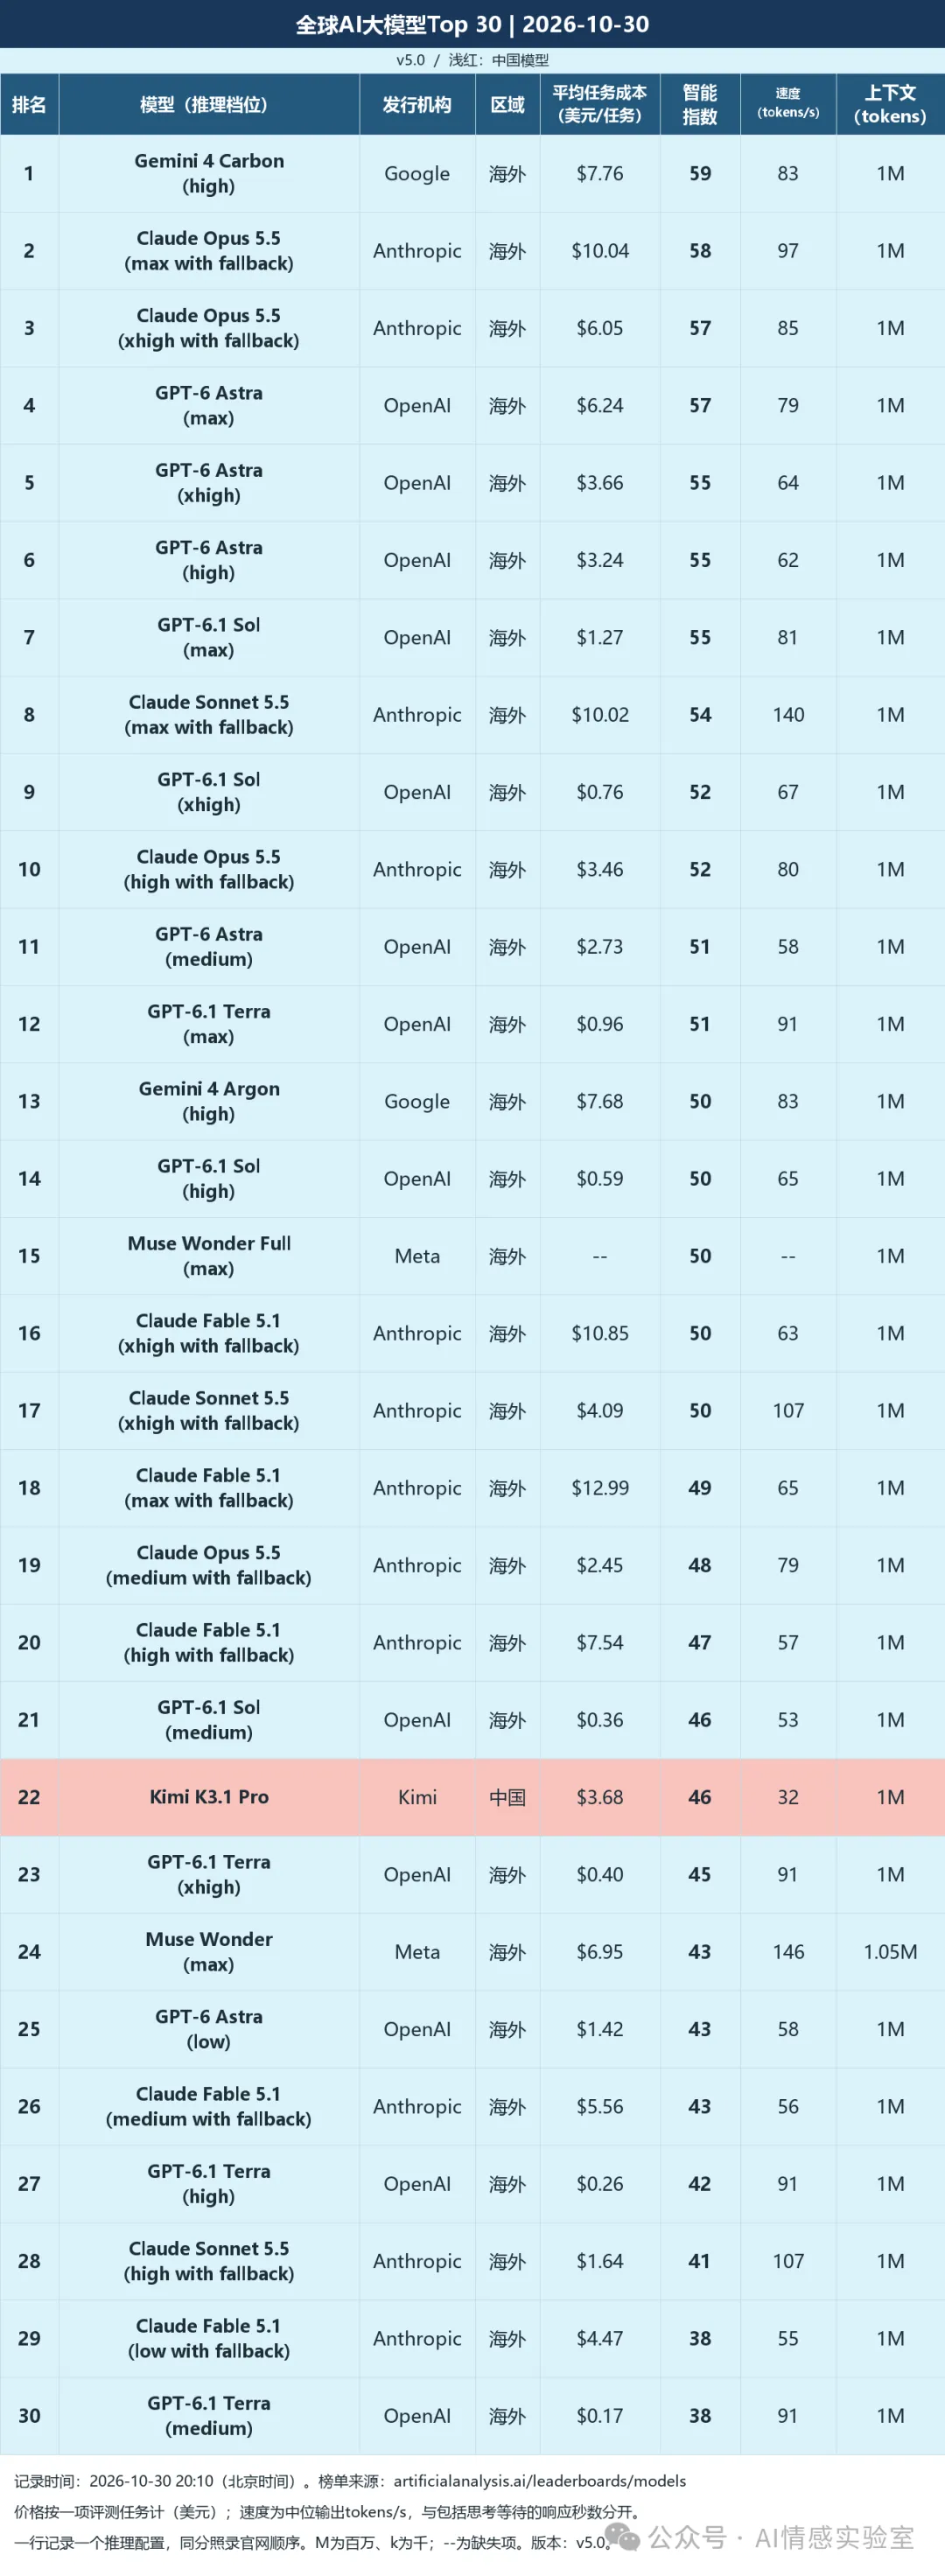
榜首换成Gemini 4 Carbon,评测也换成了v5.0。本期对照10月26日已发表的榜单,30行仍放在一张图里,浅红色标出中国模型。先提醒一句:两期分数不宜直接相减。
Carbon high以59分排第一。Opus max为58,Opus xhigh和Astra max都是57。上期没有Carbon这一行;Kimi当时55分,本次46分。这里的9分不算“跌幅”,因为前一次用的是v4.3.2。
10月27日的官方说明(https://artificialanalysis.ai/articles/artificial-analysis-intelligence-index-v5)把九项测试分为四组:知识工作、编程、科学、通用能力各25%。其中有新增的FrontierCode 2.0、Terminal-Bench-Science,也有升级和撤下的项目。老成绩单没有直接搬到新总分里。
Carbon并非九项全赢。官方解读(https://artificialanalysis.ai/articles/gemini-4-carbon-new-number-1)给出的AA-Briefcase Elo是1609,Kimi为1678;但Carbon在另外四项测试领先。图中7.76美元按标准价格计算,未使用该文提到的限时折扣。
Astra high和Sol max都拿55分,成本一行3.24美元,另一行1.27美元。Sol少花1.97美元,总响应却从45.86秒变为283.35秒,多等237.49秒。后台跑批与前台连续追问,对这四分钟的容忍程度不会一样。
Terra的max、xhigh、high、medium分别51、45、42、38分,对应0.96、0.40、0.26、0.17美元。max相对medium多13分,成本约5.65倍。这13分没有告诉我们固定格式抽取会少错几条,仍需在目标数据上测。
本期Opus max为10.04美元,约为Sol max的7.91倍。上期Opus写5.98美元,不能顺手算成API涨价:榜单这一列是评测任务成本,换了任务集合与token消耗,不是同一商品的两次报价。
Kimi K3.1 Pro在第22,46分、3.68美元。26日长图里有四个国产条目,今天只有它。这是入围数量变化,不是四个模型的受控性能对比;两张图之间还隔着v5换版。
Qwen3.8 Max 0902在37,34分、10.02美元。38、39分别是DeepSeek V4.1 Flash 1017 max和GLM-5.3 max,都是32分。MiMo-V2.6-Pro第45,30分、0.26美元。后面几行仍列出来,方便查找国产候选。
DeepSeek的成本0.60美元,GLM为5.01美元,相差8.35倍;总响应分别15.33、34.08秒。同分时这两列已经能拉开不少距离。中文情绪标注还缺一列:每百条结果需要人工改多少条。评测榜没有给出这个数。
第31的Haiku max:36分、0.41美元、234 tokens/s。总响应328.83秒,其中326.69秒都在首块输出之前,约占99.35%。读完速度列,还得翻到等待时间;234并没有把这一轮缩短到几秒。
MiniMax-M3.1-Flash第49,Step 5 Preview第50,同为29分。MiniMax为121 tokens/s、22.04秒、0.49美元;Step为170 tokens/s、15.61秒、2.35美元。本次测量中,Step少等6.43秒,成本多1.86美元。
这张表没有排队、内部推理各自占时,因而无法解释为什么等得久。做交互实验时要自己留首块延迟和整轮耗时。Wonder Full则连成本、运行数值都未披露,本期继续留“--”,不参与最低成本比较。
30行并不是30个独立模型。按机构数,OpenAI占13行、Anthropic占12行,合计25;Google与Meta各2行,Kimi占1行。比如Sol的max、xhigh、high、medium都在图内,不能把四个档位算成四款新模型,也不能把条目数量当成市场份额。
情感识别可以先做这样的对照:“行,你说了算”,前面分别接接受建议和表达不满的对话,核对标签与证据句。正式比较用独立测试集的macro-F1、逐类召回率,再另记格式错误和耗时。这里给的是试验设计,尚无模型实测结果。
最后保留两个口径:方法页(https://artificialanalysis.ai/methodology/intelligence-benchmarking)以英语、文本任务为主,部分评测包含图像输入,59分不等于中文情感分类准确率59%;官方用于跨期追踪的是Progress Index,本期照录的是当前Intelligence Index。这两种指数不能混着算升降。
数据来源: Artificial Analysis LLM Leaderboard(https://artificialanalysis.ai/leaderboards/models)
评测方法: Artificial Analysis Intelligence Index v5.0(https://artificialanalysis.ai/methodology/intelligence-benchmarking)
官方更新日志: Artificial Analysis Changelog(https://artificialanalysis.ai/changelog)
数据截点: 2026年10月30日