评测分数越来越好看,放行却更犹豫。缺的不是更高的分,是能追问的证据,以及对评测系统本身的验收。
作者:元让 | 移动端测试 / AI 测试技术
评测集越做越大,分数越刷越好看。周报上可以写「通过率又涨了」。
可到了放行会上,测试仍不敢只拿分数拍板:环境对不对?题目是不是泄漏了?裁判会不会系统性偏袒?失败样本有没有回流进门禁?
分数在涨,信心不涨。这不是模型不够强,是整套评测系统还没成为可追问的质量信号。对测试团队来说,宁可慢半拍扩题,也要先把「分数凭什么可信」说清楚——否则绿盘只会加速错误放行。
一个反常识判断
评测分数好看,不等于可以放行。 放行看的是:任务有没有办成、证据能不能复核、评测系统本身是否可信。
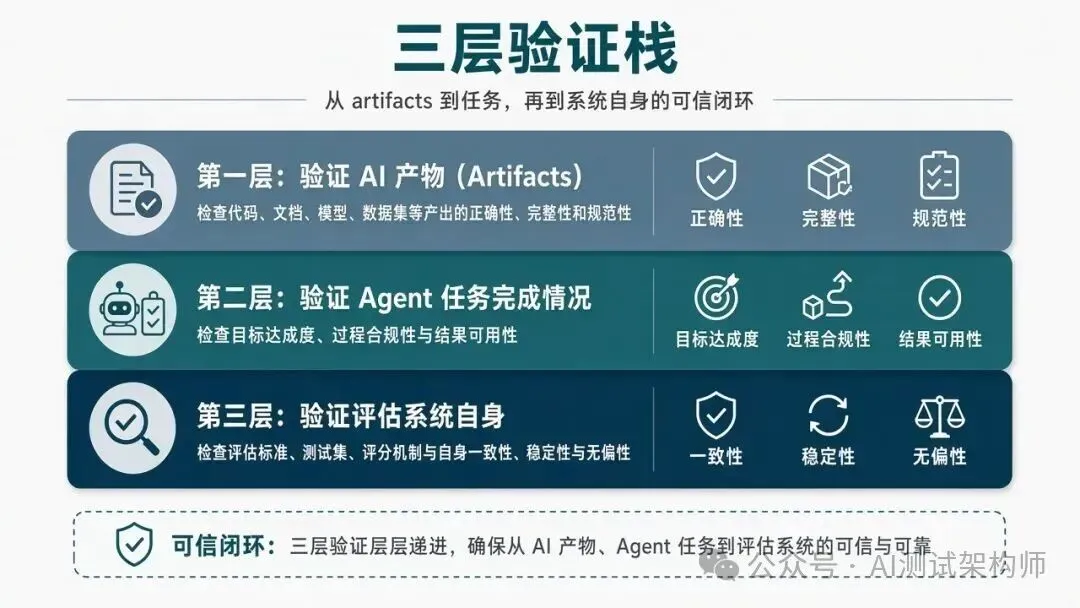
质量保障正在从「验产物」扩到「验 Agent 是否办成事」,再扩到「验评测系统」。只盯中间分数,会把噪声当成进步。上层分数吃的是残缺证据时,绿盘只会更大胆。
可以把放行会改成三张表,而不是一张通过率:
1. 产物表:用例/报告/代码能不能用,断言能不能失败
2. 办事表:用户要办的事是否办成,多次运行是否稳定
3. 评测表:题目、环境、证据、裁判是否值得相信
三张表分开报,夹心和假绿才露得出来。
分数为什么会骗人
常见几类,命中任意一条就别把「绿」当完成:
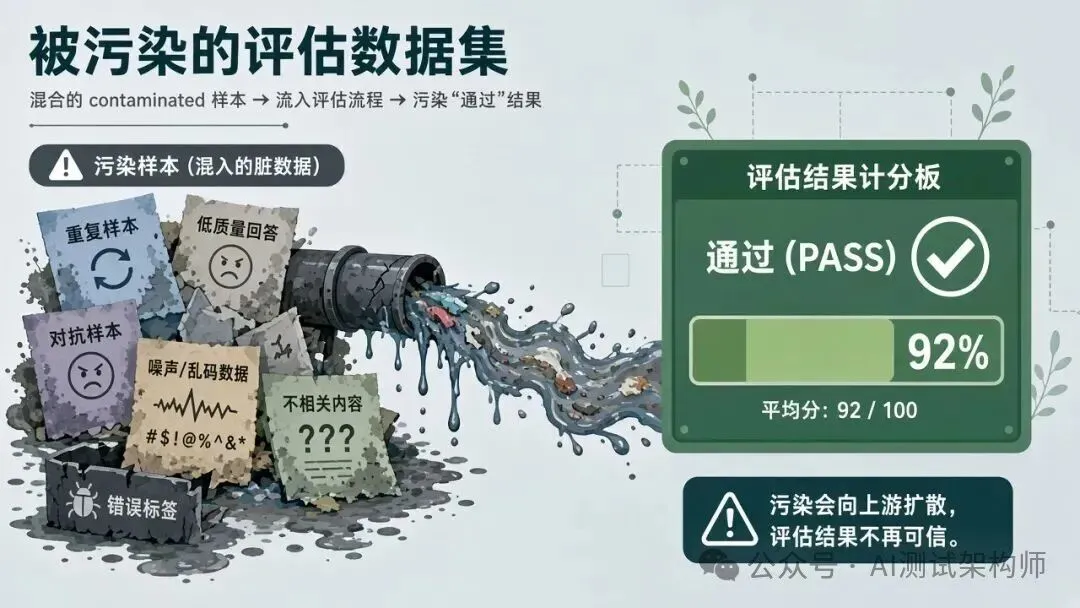
1. 题目污染:训练/调试见过的样本混进评测集,分数虚高。
2. 环境演戏:mock、录制回放、弱网缺失,却宣称端侧/实机能力。
3. 裁判偏袒:用同一模型家族互评,或提示词诱导「尽量给高分」。
4. 单次运气:概率系统只报一次通过率,不看重复跑的波动与最差情况。
5. 证据缺失:只有分数,没有轨迹、版本、失败归因,接手无法复核。
还有一种更隐蔽:题目看起来很多,却都扎堆在同一条低风险路径上。高风险旅程几乎没覆盖,分数照样漂亮。覆盖幻觉和评测幻觉是亲戚——都用「量大」冒充「可信」。
生成 / 执行 / 知识库:评测从哪裂开
评测不是孤立模块。它和用例生成、自动执行、知识库共用同一套组织记忆。
### 生成:快产,也会快污染
AI 生成用例/评测样本很爽,也最容易把幻觉样本送进金标。没有范围对账、风险标签、断言可失败门禁,评测集会迅速变成「看起来合理」的题库。生成越快,污染越厚——除非入库默认带版本、来源、适用范围与反例。
### 执行:会跑,不可复核
自动执行若只回 PASS/FAIL,评测只能统计热闹。契约层不稳却拿任务完成率当 KPI,假绿会伪装成评测进步。GUI Agent 尤其危险:演示路径进了评测集,回归路径缺弹窗策略与机型标签,分数会系统性偏乐观。
### 知识库:缺地基,裁判只能猜
没有规格要点、历史缺陷、误报模式、黄金失败样本,裁判只能凭模型常识打分。失效库不回流,同类假绿每周重演。铁律仍是:先知识库,后 Skill / 后堆题。
生成再快,没有知识约束与失效回流,只会更快污染评测;执行没有轨迹,评测只能看热闹;知识库不记反例,门禁永远补不上。
手机 / OS 场景里,评测更会偏乐观
端侧比 Web 更容易「看起来过了」:
• 权限与系统弹窗:弹窗被点掉却记成任务完成。
• 网络条件:飞行模式没开却宣称端侧智能,弱网一来全垮。
• 机型与控件树:参考机绿、目标机漂移;自愈若无证据,只是把错误修绿。
• 实验室与传感器:模拟器绿、实机红;缺环境标记却进金标。
端侧评测至少要写明:实机还是模拟器、网络条件、OS 大版本、是否允许自愈。缺标签的 PASS,放行会上应直接降级。把 OS 差异写成可检索条目,比让裁判每次临场猜更便宜、更稳。
可执行结论:把评测建成质量系统
把评测当质量系统来建,而不是当分数看板。按这条链做:
1. 拆三层验收:产物能不能用、任务有没有办成、评测题/环境/裁判是否可信——三张表分开报。
2. 金标冻结:评测集版本号、适用环境、禁止混入调试样本;改题必须升版本。
3. 重复跑:同一金标至少跑多次,看波动与最差,不单报一次均值。
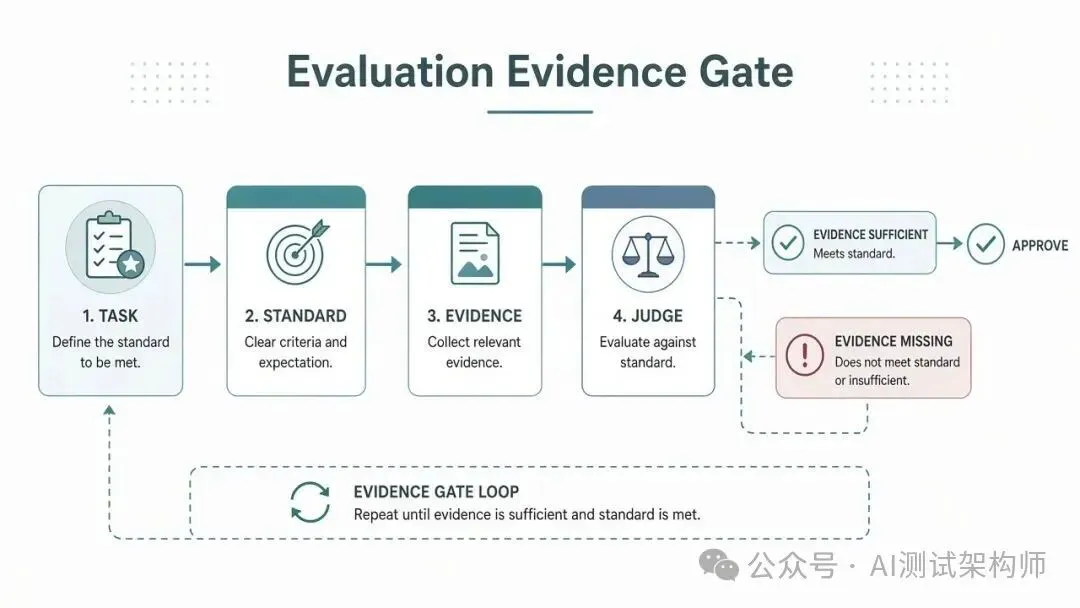
4. 证据字段:步骤、截图/日志、模型与工具版本、失败归因;缺字段一律不计 PASS。
5. 坏案例回流:本周至少把 1 条假绿写进失效库,并升级为默认门禁,下周回归必须还能拦住同类问题。
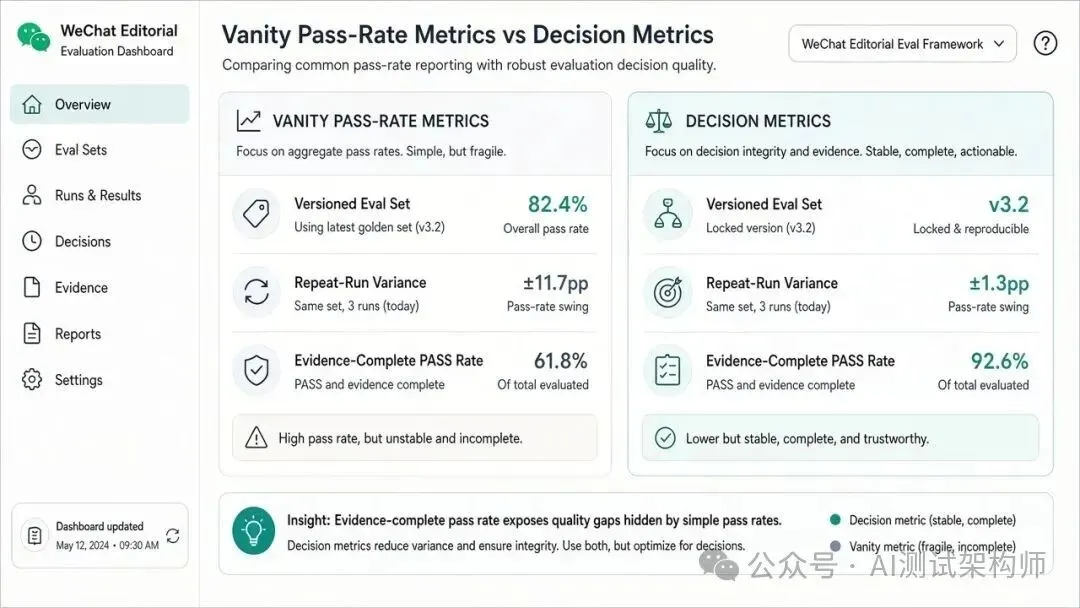
6. 改度量:少报题量和单次通过率;多报证据齐全 PASS 占比、打回率、评测版本变更说明、夹心补位人时。
### 今天就能做的三件事
1. 抽查现有评测集:有多少题没有环境标签?有多少来自调试会话?先列清单。
2. 给「放行会」加一条硬规则:无轨迹、无版本的评测结果不得单独作为放行依据。
3. 选一条高风险用户旅程,建最小金标切片(10~20 题)并连续重复跑一周,只看波动与最差。
平台很重要,但平台不是行动起点。更常见的有效路径是:先打穿一条样板评测闭环,沉淀知识、证据与回流,再扩题量。
一条可放行的样板评测链
别从「今天加 100 道题」开始。选一条真会疼的用户旅程,按七天节奏打穿:
第 1~2 天:写清任务契约——目标、依据、交付物、验收、环境约束;从知识库抽出规格要点与历史缺陷,生成最小金标切片。 第 3~4 天:自动执行只认带轨迹的结果;同一金标重复跑,记录均值、波动、最差;缺证据的一律打回。 第 5 天:复盘假绿——题目污染、环境演戏、裁判偏袒各至少找一条;写入失效库。 第 6 天:把命中规则升级为默认门禁;金标升版本,注明变更原因。 第 7 天:放行会只带三张表(产物/办事/评测)与最差情况,不带「单次通过率喜报」。
这条样板链跑通之前,禁止把评测通过率写进对外发布口径。样板链的意义,不是证明模型更强,而是证明你们能拒绝不可信的绿。
若七天内样板链都建不起来,通常卡在三处之一:没有人维护金标版本、执行不落轨迹、失效库没有责任人。把这三处写成岗位职责,比再买一个评测平台更管用。组织若连「谁对评测可信负责」都答不清,扩题只会扩幻觉。先指定金标 Owner 与失效库 Owner,哪怕各只花半天,也比无人负责的千题库更接近可放行。责任到人,评测才有机会从分数看板变成质量系统,而不是一份热闹报表而已。
度量怎么改:少报热闹,多报接得住
评测之所以长期「分数涨、信心不涨」,常常因为度量在奖励中间热闹。题量、单次通过率、演示视频都能上桌;污染率、重复跑波动、证据齐全率却很少出现。
建议两周内至少对照一次:
1. 中间层(参考):题量、单次通过率、平均分——只说明产能。
2. 决策层(放行):金标版本是否冻结;重复跑波动;证据齐全 PASS 占比;因缺证据被打回的比例;本周回流门禁条数。
如果决策层不动、中间层暴涨,你正在把假绿做厚。管理层若只问「评测覆盖了多少」,一线就会继续堆题。把问题改成「哪条放行因为评测变稳了」,污染才会被迫露出来。
五个会让评测越做越空的坑
1. 只加题不加治理:题量涨、污染涨,分数与风险脱节。
2. 用评测替代底层测试:上层分数不能自动证明契约层/回归层已绿。
3. 周报只晒通过率:不晒打回率、证据齐全率、评测变更说明。
4. 裁判与被测同源:同一模型家族自评,系统性偏袒难发现。
5. 扩题早于样板:样板金标都经不起重复跑,扩 10 倍只是把幻觉放大 10 倍。
周会可以改问三句:本周评测集是否升过版本?重复跑波动有没有变大?有几条假绿回流成了门禁?三句答不清,就先别扩题量。
给放行会的一句话
没有证据的分数,只是情绪安慰;有版本、有重复跑、有回流的评测,才配进放行议程。
小结
做了一堆评测集,仍不敢放行,通常不是「分还不够高」,而是分数还经不起追问。
先让评测可版本、可重复、可归因,再让分数进放行会。否则你只是在用更精致的绿盘,安慰发布压力。评测要服务放行决策,而不是服务周报上的好看数字。
下次再听到「评测通过率又提升了」,先问三句:
1. 金标版本和环境标签齐不齐?
2. 重复跑的最差情况能不能接受?
3. 失败有没有回流进知识库与门禁?
三句答得干净,再谈扩题。评测集的价值,不在它能刷出多高的分,而在它能逼团队把失败变成下一次默认拦住的规则。
你团队现在最不放心的是哪一块:题目污染、环境演戏,还是裁判不可信?评论区丢一个真实场景,我们按下篇拆对应门禁写法与字段清单。