模型越会写,越容易把「没验收」当成「做完了」。单测全绿、演示能跑、聊天窗口里感觉还行——合入之后线上仍翻车,这类反差并不少见。
公开可核对的一例:腾讯技术工程《3 个月用 Harness 重构 90 万行旧项目》(约 2026-10-16)写到,团队约 2~3 人,把约 90 万行旧系统按「需求说明书」重写;截至约 8 月底,重构版约 12 万行代码、15 万行文档、6000+ 测试用例、覆盖率约 86%。文里反复强调的不是「换了更强的模型」,而是人守住需求边界、验收标准和关键路径——运动员和裁判员要分开。我未参与该项目,数字以原文为准。
这篇做入门地图:Harness 到底管哪几层、每层管什么/不管什么、和「再换一个更好模型」差在哪。评测门禁、数据流水线约束门禁,可以当作其中两层已经落地的实例;护栏、可观测等层只给边界,不展开工具手册。
先说结论
Harness = 围绕模型 / Agent 的约束与交付链,不是聊天壳。六层:评测、护栏、工具编排、记忆、可观测、交付脚手架。评测答「变没变差」;护栏答「允不允许」;编排答「谁在何时调工具」;记忆管可版本化上下文,不是个人笔记流;可观测让失败可回放;交付把断言接到 CI / 合入 / 回滚。从零只做一件:先钉评测门禁(失败用例进仓库、失败变红灯)。换更强模型解不了「没验收」;只堆 Prompt 也不是护栏。
1、问题定义:缺的是哪一层,不是哪个模型
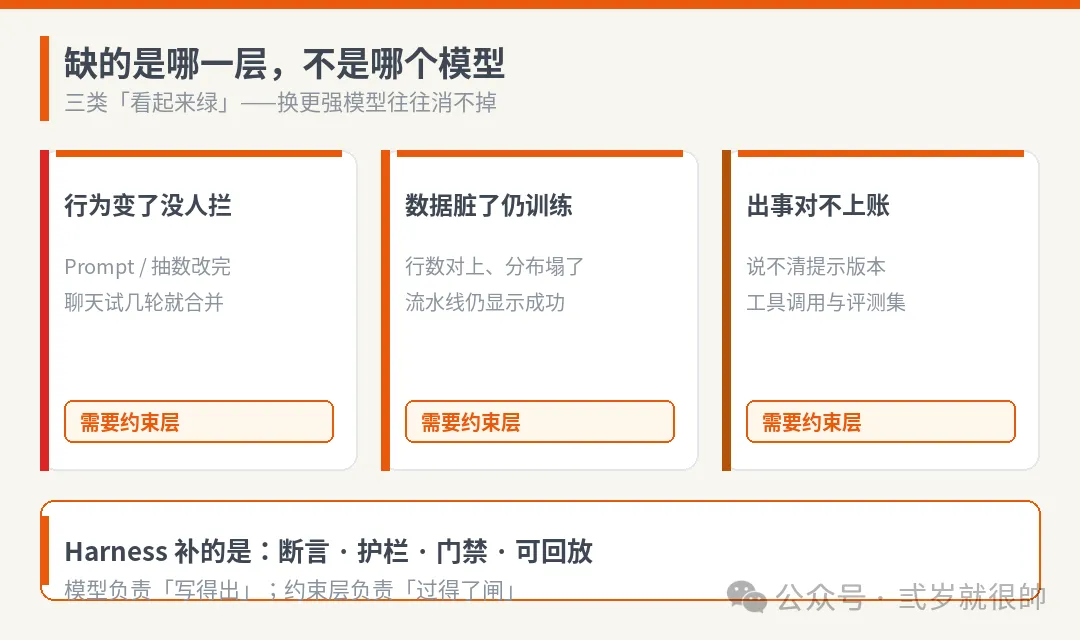
AI 研发和数据工程里,常见「看起来绿」有三类:
- 行为变了没人拦:Prompt / 抽数规则改了一处,聊天里多试几轮就合并;
- 数据脏了仍训练:特征批行数对上,标签正例率却塌了,流水线显示成功;
- 出事对不上账:线上偶发,说不清当时用了哪版提示、哪次工具调用、哪份评测集。
这三类痛点,换一个更强的基座模型,往往只能「偶尔变好」,不能系统性消掉。缺的是可验证的约束层:谁在改动后断言失败、谁在越权前拦住、谁把失败接到合入闸口、谁留下可重放痕迹。
本栏用语里,AI Harness = 围绕模型 / Agent 的工程脚手架与约束层——让生成结果可被信任、可复现、可运维。它和「裸调模型」「只堆系统提示」的边界就在这里:后者靠叮嘱;前者靠检查、门禁和交付链。
2、概念与分层:六层各管什么
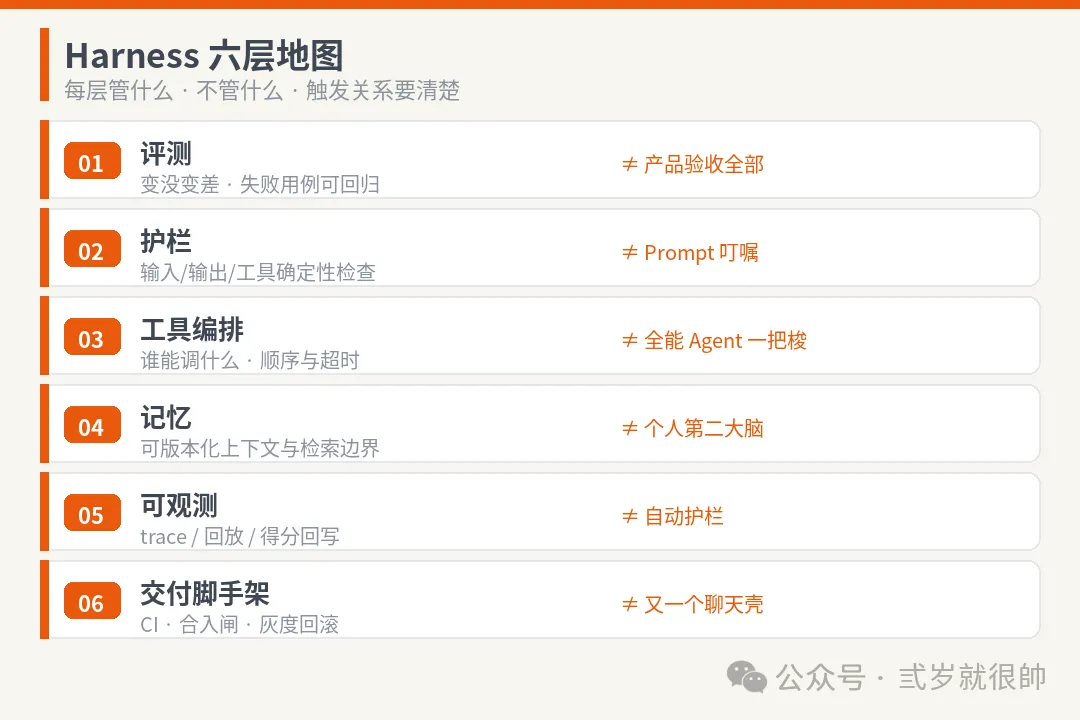
下面这张表是本栏默认地图。层名可本地化,职责别糊成一锅。
层 | 管什么 | 不管什么 | 缺了会怎样(反例)**评测** | 改完有没有变差;失败用例与基线可回归 | 不替代产品验收;不自动等于线上 SLA | 演示稿直接合并,两周后才发现回归**护栏** | 输入 / 输出 / 工具 / 检索的确定性检查 | 不是把审核政策全文塞进 Prompt | 「别乱来」写进系统提示,模型照样调了禁用 API**工具编排** | 谁能调什么、顺序与超时、失败重试边界 | 不是把所有能力一次性塞给 Agent | 运动员兼裁判:同一 Agent 既写实现又判自己过关**记忆** | Agent / 流水线侧可版本化的上下文与检索边界 | 不是个人第二大脑式笔记整理 | 上下文腐烂:旧约束和过期事实混进同一窗口**可观测** | trace / 日志 / 得分回写,出事能回放对比 | 不等于护栏;看见了不自动拦住 | 门禁红了却说不清是哪次调用、哪条用例**交付脚手架** | 断言进 CI、合入闸、灰度与回滚钩子 | 不是又一个聊天前端 | 本地 eval 绿、主干无门禁,红灯只停在个人电脑
六层可以叠,但触发关系要清楚:评测验行为;护栏挡越权;编排约束工具面;记忆管「带什么上下文上场」;可观测服务复盘;交付把前面几层的失败变成「不敢合并 / 不敢放量」。
已落地的两层实例(只点位置,不写成工具课):
- 评测门禁:断言进仓库,failures > 0 → 构建非零退出(例如声明式 eval 接到 CI)。
- 数据约束门禁:schema / 分布 / 枚举写进校验脚本,脏批 exit 1,拦住下游训练。
两者共用三块积木:断言进仓库、失败变红灯、版本可重放。
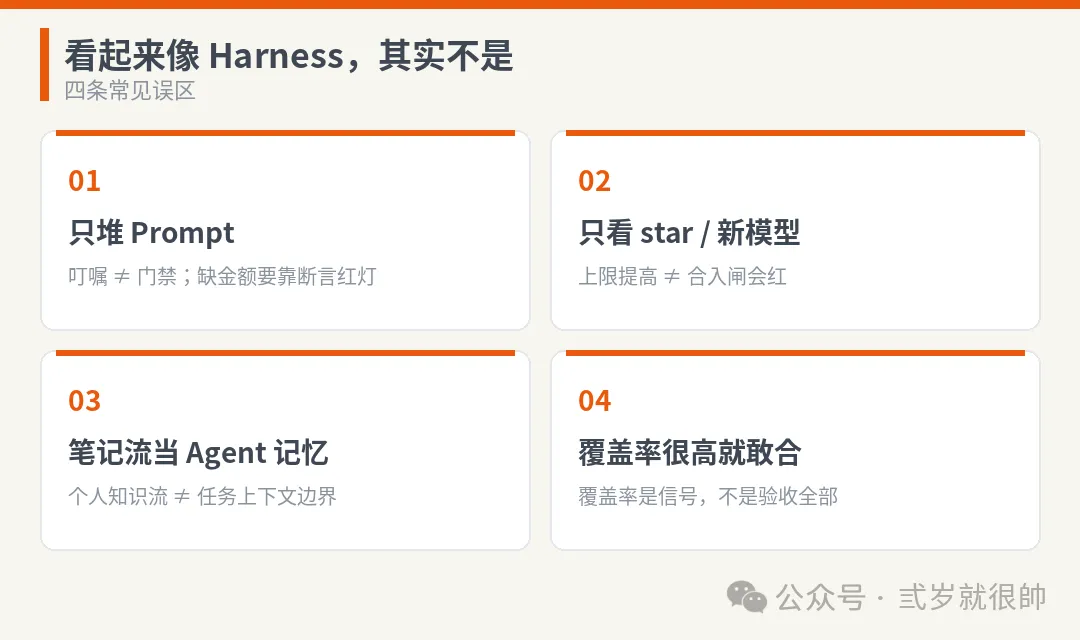
3、常见误区(至少三条)
误区 1:只堆 Prompt,就当上了 Harness。
叮嘱模型「输出必须含金额字段」不是门禁;门禁是用例里断言缺金额就失败,并且失败能红掉流水线。
误区 2:只看 star / 新模型发布,不看失败能否复现。
开源积木可以加速某一层,但 star 数证明不了你的合入闸会不会红。模型发版解决的是生成上限;Harness 解决的是「生成结果敢不敢放行」。
误区 3:把个人笔记流当成 Agent 记忆。
个人知识库怎么收件、怎么复习,是另一类问题。Harness 里的记忆,关心的是:这次任务允许检索哪些材料、版本是哪一版、过期约束有没有清掉——和「我怎么整理笔记」不是同一层。
误区 4:覆盖率很高 = 可以放心合并。
公开复盘里也提到:AI 生成的测试容易「自己圆覆盖率」。覆盖率是信号之一,不是验收全部;关键路径仍要人守,变异测试一类手段是在问「断言够不够严」,不是再堆行数。
4、最小可行骨架:从零只做一件时先钉评测门禁
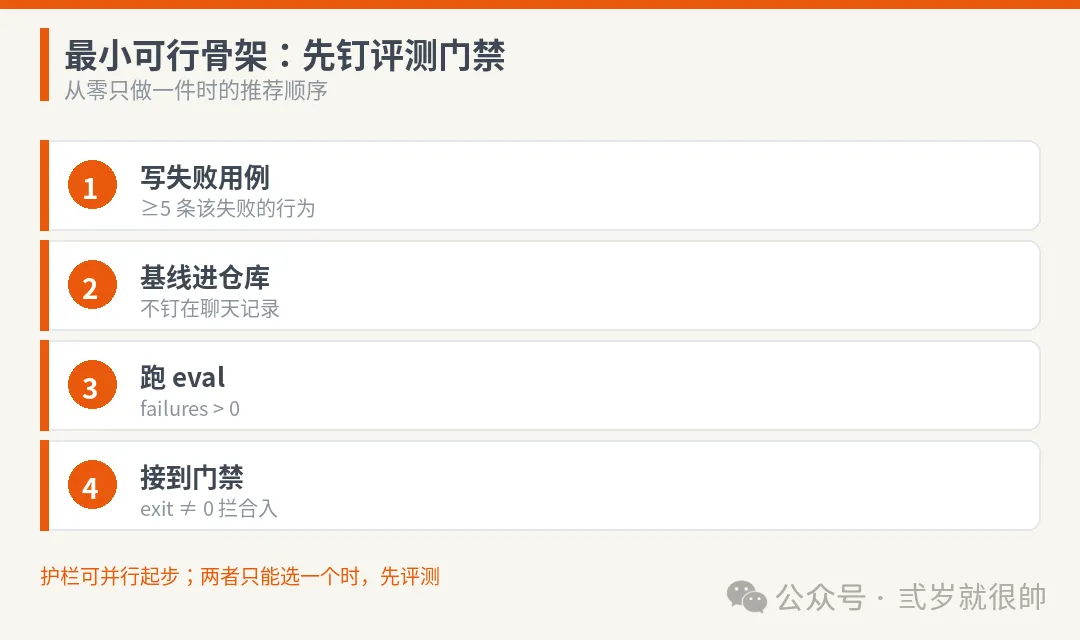
若只能先做一层,本栏建议:先做评测门禁。
理由很实在:
- 反馈最快:本周改的 Prompt / 抽数规则,有没有变差,立刻有答案;
- 和数据工程同构:用例就是小数据集;字段缺失、格式不合法,和「抽数结果必须过闸」是同一思路;
- 后面几层好挂:护栏、可观测、CI 合入,都可以挂在「已有失败信号」后面;没有失败信号,后面只能盲拦或空转。
最小动作(可本周做完):
- 为本周一个 Agent / Prompt 行为写 ≥5 条该失败的用例(可验收、可回归);
- 跑 eval:failures > 0 → exit ≠ 0;
- 把这步接到现有 CI 或合并前钩子(哪怕先只拦本仓库一条流水线)。
护栏可以并行起步(例如「写文件 / 调外部 API」允许列表),但若两者只能选一个,先评测——没有「变差」的定义,允许列表也容易变成摆设。
5、和相邻方案的边界
对照 | 差别**裸 Agent / 只聊天** | 有生成,无系统层验收;Harness 补的是约束与交付链**纯大模型平台 / 中台** | 平台提供模型与配额;Harness 是你仓内「敢不敢放行」的规矩,二者可叠加,不能互相替代**个人第二大脑** | 服务的是人的知识流;Harness 记忆服务的是 Agent / 数据任务的上下文边界**换更好的模型** | 提高生成上限;不自动产生失败用例、护栏接口、合入闸与回放
一句话:模型负责「写得出」;Harness 负责「过得了闸、说得清、回得了滚」。
6、可带走的清单
- 先画一张六层表,标出你现在有哪几层、缺哪几层——缺层用技术语言写,别用「以后再优化」糊弄。
- 从零只做一件:评测门禁——失败用例进仓库,失败变红灯。
- 护栏写成调用前后的确定性检查,不要只靠系统提示叮嘱。
- 数据侧与模型侧共用同一习惯:断言进仓、非零退出、版本可重放。
- 可观测是为了回放与归因;看见了仍要接到门禁,否则只是仪表盘。
收尾一句实话:Harness 是确定性工程在系统层的落地——不是换更好的模型,而是给模型套上可验证的约束与交付链。你这边最先补上的是哪一层?欢迎留言对一下地图。
出处与延伸
- 腾讯技术工程《3 个月用 Harness 重构 90 万行旧项目》(公开复盘,约 2026-10-16;微信可搜标题;小红书请搜索「腾讯技术工程 Harness」)。文中 90 万→约 12 万行、6000+ 用例、覆盖率约 86% 等数字以原文为准;我未参与。
- 本栏分层用语与学习路径见栏目约定;具体评测门禁、数据约束门禁的工具接入,见已写的工程实践文,本文只钉地图与边界。