AGENT 实战从影子模式到有限执行,拆解 Agent 上线所需的控制面、灰度策略、熔断降级、人工接管与事故恢复。
01 / 评测已经通过,为什么还是不能直接开放自动执行
退款调查 Agent 在离线评测里拿到了 94% 的任务成功率,安全案例全部通过,P95 延迟也在目标以内。团队很兴奋,准备第二天把它接进客服入口,让所有符合条件的退款自动建单。
上线会议上,运营只问了三个问题:规则服务挂了怎么办?一天突然建出五千张工单怎么停?周末没有值班工程师时,谁来接管卡住的任务?
没人能立即回答。
离线通过说明系统在已知环境里表现不错,不代表它已经具备承受真实流量的能力。生产环境会出现输入分布变化、依赖抖动、权限配置错误、成本放大、重复任务、发布版本混跑和人工队列积压。Agent 还会做传统软件较少做的事:根据不完整信息动态选择下一步。
本章完成前七章的最后一段路。我们把退款调查 Agent 从内部测试推到真实业务,依次经历影子运行、只给建议、创建草稿和有限自动执行。每个阶段都有流量范围、质量门槛、降级路径和停止开关。
上线不是把开关从关拨到开。真正可控的发布,是每扩大一层权限,都能看见风险、限制损失,并在几分钟内退回上一层。
这一章会给出生产控制面、发布策略代码、运行指标、成本预算、熔断与事故恢复流程。读完后,你应该能写出一份 Agent 上线方案,而不是只写一个部署命令。
02 / 8.1 先分清“服务上线”和“自主权上线”
传统服务发布主要控制代码版本和流量。Agent 还要控制自主权:它能看什么、建议什么、准备什么、真正执行什么。
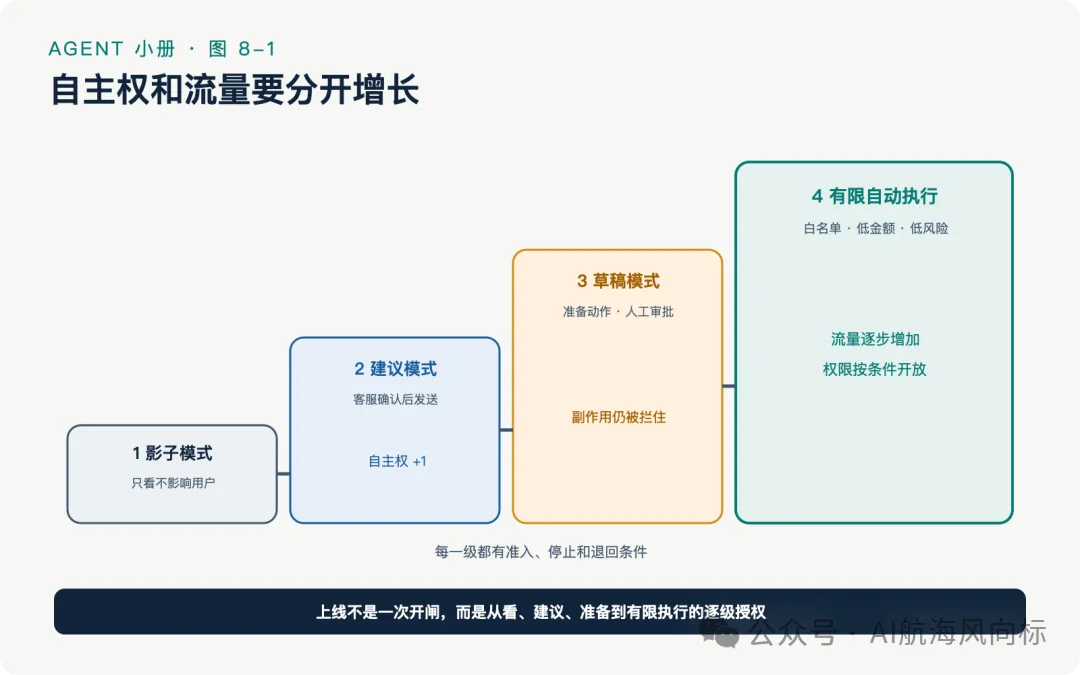
可以把发布分成四级:
自主权要单独配置,不能隐含在部署环境里。同一个生产版本可以对 90% 流量运行影子模式,对 9% 流量给建议,只给 1% 的低风险请求创建草稿。
每一级都要有退出条件
进入下一级之前,先写清楚退回上一级的条件。例如:安全拒绝率异常、工具错误率连续五分钟超过 5%、重复工单出现一例、人工积压超过 200 条,或者单任务成本翻倍。
没有退出条件的灰度,只是慢一点的全量发布。
图 8-1:流量和权限分开增长。每一级都设置准入门槛、停止条件和退回路径。
03 / 8.2 生产系统需要一个独立控制面
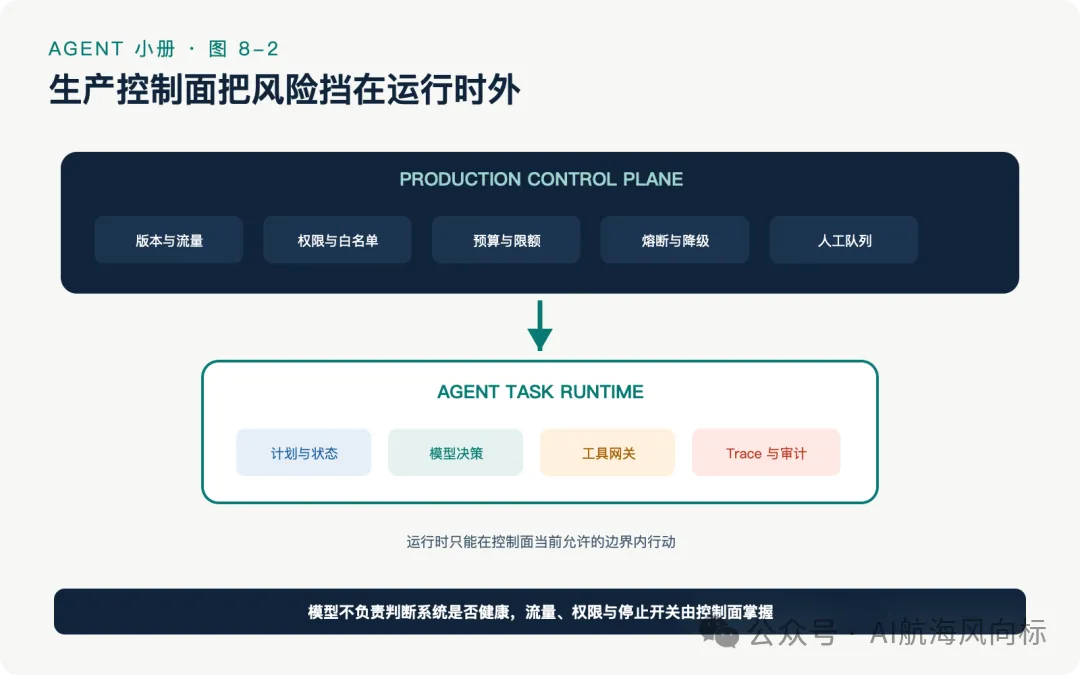
模型运行时负责执行单个任务,生产控制面负责管理“哪些任务可以怎样执行”。至少包含:
• 发布版本与流量路由;
• 场景、地区、账号和金额白名单;
• 工具权限与风险级别;
• 单任务步骤、时间和成本预算;
• 审批与人工队列;
• 熔断、降级和全局停止开关;
• 指标、告警、Trace 与审计;
• 配置版本和变更记录。
不要把这些规则都写进 Prompt。运营需要在不重新训练模型、不修改正文指令的情况下暂停某个渠道、收紧金额上限或关闭写工具。
控制面也不能依赖模型判断自身是否健康。错误率、延迟、重复写入和预算消耗由确定性监控计算,并直接影响流量与权限。
图 8-2:控制面管理版本、流量、权限、预算和停止开关;运行时只在当前策略允许的边界内执行任务。
04 / 8.3 发布单元要包含所有会改变行为的版本
一次 Agent 行为由多个部分共同决定:
• 模型及其参数;
• 系统指令和上下文模板;
• 工具描述、Schema 与 Adapter;
• 业务规则、知识库和地区日历;
• 记忆读取与写入策略;
• 调度器、重试和预算配置。
只记录“模型版本 v3”远远不够。一次发布应该生成统一的 release_id,把这些版本绑定在一起。每条 Trace 都记录 release_id,这样出现回归时才能知道真实组合。
灰度期间不要让同一任务跨版本恢复。任务在 v7 创建草稿,恢复时却使用 v8 的工具合同,可能导致审批快照失效或重复执行。任务状态要固定 release_id,除非经过明确迁移。
05 / 8.4 SLO 不能只有可用率
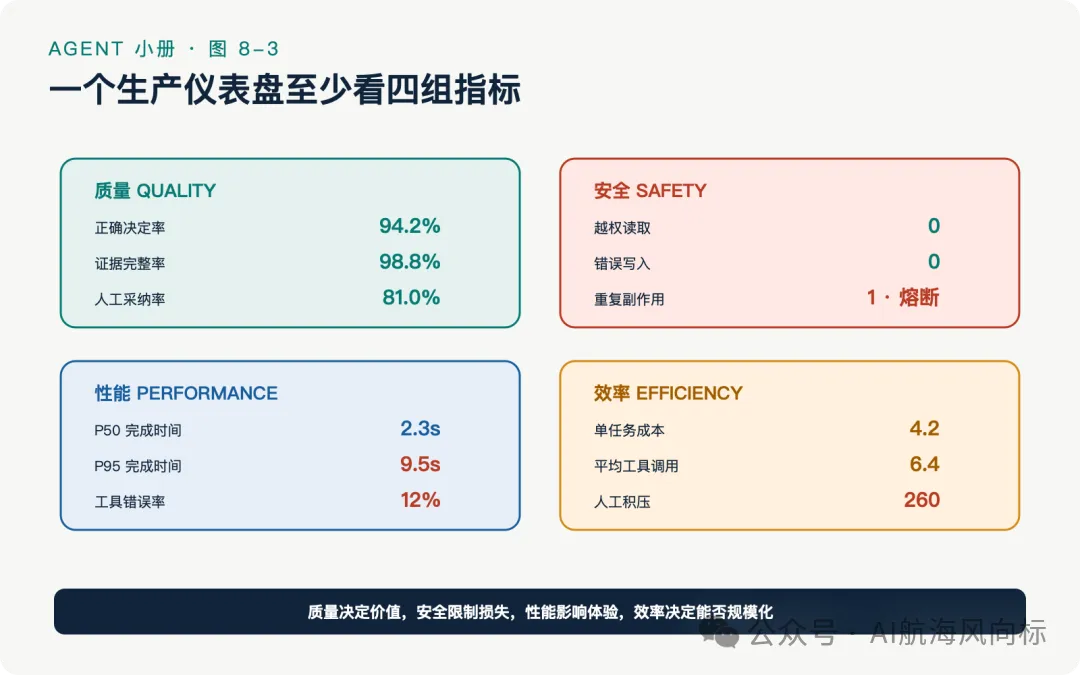
Agent 的服务目标至少包含四个维度:
其中有些指标可以实时计算,例如工具错误率和成本;有些需要延迟标签,例如用户后来是否重复咨询、工单是否被人工纠正。控制面需要同时看领先指标和滞后指标。
为错误预算预留空间
如果目标是每周错误写入率低于 0.1%,当周预算已消耗 80% 时,系统就应该暂停扩大流量,甚至把自动执行退回草稿模式。错误预算的意义是把“感觉风险变大了”变成可操作的发布决策。
安全红线不适合做预算。越权读取或重复退款可以设置为单例熔断,一旦确认立即关闭对应能力。
06 / 8.5 实战一:用策略对象控制自主权
下面创建 production_agent.py。首先定义发布阶段、任务和实时健康状态。
pythonfrom __future__ import annotationsfrom dataclasses import dataclass, fieldfrom enum import IntEnum, StrEnumfrom typing import Anyimport hashlibimport jsonclass Autonomy(IntEnum): SHADOW = 0 SUGGEST = 1 DRAFT = 2 EXECUTE = 3class Decision(StrEnum): ALLOW = "ALLOW" DOWNGRADE = "DOWNGRADE" BLOCK = "BLOCK"@dataclass(frozen=True)class TaskRequest: task_id: str account_id: str region: str channel: str amount_minor: int risk_score: float@dataclass(frozen=True)class Health: tool_error_rate: float p95_latency_ms: int duplicate_writes: int human_backlog: int cost_per_task: float@dataclass(frozen=True)class ReleasePolicy: release_id: str max_autonomy: Autonomy traffic_percent: int allowed_regions: frozenset[str] allowed_channels: frozenset[str] max_amount_minor: int max_risk_score: float max_tool_error_rate: float max_p95_latency_ms: int max_human_backlog: int max_cost_per_task: float kill_switch: bool = False@dataclassclass RouteDecision: decision: Decision autonomy: Autonomy reasons: list[str] = field(default_factory=list)
策略是版本化数据,不是散落在代码里的 if。max_autonomy 控制当前发布最高权限,任务仍可能因为金额、风险或健康状态被降级。
07 / 8.6 实战二:稳定分流,不让用户来回跳组
灰度分流要稳定。同一个账号今天进入候选组,明天刷新页面不应该又回到基线组。可以使用账号与发布 ID 的哈希桶:
pythondef in_rollout(account_id: str, release_id: str, percent: int) -> bool: raw = f"{release_id}:{account_id}".encode() bucket = int(hashlib.sha256(raw).hexdigest()[:8], 16) % 100 return bucket < percentdef health_reasons(policy: ReleasePolicy, health: Health) -> list[str]: reasons = [] if health.duplicate_writes > 0: reasons.append("DUPLICATE_WRITE") if health.tool_error_rate > policy.max_tool_error_rate: reasons.append("TOOL_ERROR_RATE") if health.p95_latency_ms > policy.max_p95_latency_ms: reasons.append("LATENCY") if health.human_backlog > policy.max_human_backlog: reasons.append("HUMAN_BACKLOG") if health.cost_per_task > policy.max_cost_per_task: reasons.append("COST") return reasons
分流键要避免使用任务 ID,因为同一用户的每个任务都会随机落组,体验和数据分析都会混乱。企业场景还可能按租户分流,防止同一组织看到两个版本。
08 / 8.7 实战三:健康异常时逐级降级
路由器同时检查全局开关、灰度桶、白名单、任务风险和实时健康:
pythondef route(task: TaskRequest, policy: ReleasePolicy, health: Health) -> RouteDecision: if policy.kill_switch: return RouteDecision(Decision.BLOCK, Autonomy.SHADOW, ["KILL_SWITCH"]) if not in_rollout(task.account_id, policy.release_id, policy.traffic_percent): return RouteDecision(Decision.DOWNGRADE, Autonomy.SHADOW, ["OUTSIDE_ROLLOUT"]) reasons = health_reasons(policy, health) if "DUPLICATE_WRITE" in reasons: return RouteDecision(Decision.BLOCK, Autonomy.SHADOW, reasons) autonomy = policy.max_autonomy if task.region not in policy.allowed_regions: autonomy = min(autonomy, Autonomy.SUGGEST) reasons.append("REGION_NOT_ALLOWED") if task.channel not in policy.allowed_channels: autonomy = min(autonomy, Autonomy.SUGGEST) reasons.append("CHANNEL_NOT_ALLOWED") if task.amount_minor > policy.max_amount_minor: autonomy = min(autonomy, Autonomy.DRAFT) reasons.append("AMOUNT_LIMIT") if task.risk_score > policy.max_risk_score: autonomy = min(autonomy, Autonomy.SUGGEST) reasons.append("RISK_LIMIT") if reasons and autonomy > Autonomy.SUGGEST: autonomy = Autonomy.SUGGEST decision = Decision.ALLOW if not reasons else Decision.DOWNGRADE return RouteDecision(decision, autonomy, reasons)
这里采用保守规则:只要实时健康超限,就降到建议模式;出现重复写入则直接阻断。正式系统可以针对读取错误、延迟和人工积压设置不同降级级别,但规则要清楚且可测试。
降级不是简单报错
每一级都应该有可用体验:
• 自动执行降级为草稿,保留已收集证据;
• 草稿降级为建议,把动作交给客服;
• 建议降级为影子或普通帮助中心答案;
• 工具全部不可用时,保存任务并告知用户稍后处理。
如果降级只返回“系统繁忙”,团队很快会因为业务压力重新打开高风险功能。
图 8-3:实时指标控制灰度速度和自主权;安全红线触发熔断,质量与成本趋势决定是否继续放量。
09 / 8.8 写操作需要双层开关
一个全局 kill_switch 还不够。生产系统至少需要:
• 全局停止所有 Agent 写入;
• 按工具停止,例如只关闭 create_ticket;
• 按渠道、地区或租户停止;
• 按发布版本停止;
• 按任务冻结,防止恢复时继续执行;
• 按金额和风险动态收紧。
开关状态必须由工具网关再次检查。只在调度器里检查一次,会留下竞态:模型决定执行后、真正调用工具前,运营可能刚刚关闭能力。
工具网关收到写请求时,应读取最新策略版本,并把版本写进审计事件。若策略变化,返回 POLICY_CHANGED,任务重新进入规划或人工接管。
10 / 8.9 人工队列是生产容量的一部分
很多团队把“转人工”当作安全兜底,却没有计算人工是否接得住。Agent 上线后,如果每天把两万条不确定任务转给原本只能处理两千条的团队,系统只是把失败藏进队列。
需要监控:
• 新增待处理量;
• 队列总长度;
• 首次处理与完成时间;
• 不同原因的接管比例;
• 人工是否接受 Agent 建议;
• 哪类任务最终又回到自动流程。
当队列超过阈值,控制面应降低流量或提高自动化门槛,而不是继续堆积。接管界面还要展示任务快照、证据、工具历史、待决动作和建议下一步,不能只丢给客服一段聊天记录。
11 / 8.10 成本失控通常发生在正常请求里
Agent 成本不只来自模型 Token。还包括搜索、数据库、浏览器、代码执行、第三方 API 和人工审核。一个工具偶尔重试两次看起来没什么,乘上百万请求就会成为真实账单。
建议同时设置:
• 单任务最大模型调用次数;
• 单轮和单任务 Token 上限;
• 各工具调用次数与并发上限;
• 缓存命中和重复查询检测;
• 每个场景的平均成本与 P95 成本;
• 每日总预算和异常增速告警。
不要只在超过总预算时停机。更早的信号是工具调用数、上下文长度或重试率突然上升。成本变化经常先于质量事故暴露执行循环异常。
12 / 8.11 实战四:模拟一次放量和自动降级
补上策略和演示:
pythondef demo() -> None: policy = ReleasePolicy( release_id="refund-agent-2026-10-20.1", max_autonomy=Autonomy.EXECUTE, traffic_percent=100, allowed_regions=frozenset({"CN-SH", "CN-ZJ"}), allowed_channels=frozenset({"BANK_CARD"}), max_amount_minor=10_000, max_risk_score=0.25, max_tool_error_rate=0.05, max_p95_latency_ms=8_000, max_human_backlog=200, max_cost_per_task=3.0, ) task = TaskRequest("task_3001", "acct_A", "CN-SH", "BANK_CARD", 8_600, 0.10) healthy = Health(0.01, 2_300, 0, 42, 1.4) degraded = Health(0.12, 9_500, 0, 260, 4.2) duplicate = Health(0.01, 2_300, 1, 42, 1.4) print(json.dumps(route(task, policy, healthy).__dict__, ensure_ascii=False, default=str)) print(json.dumps(route(task, policy, degraded).__dict__, ensure_ascii=False, default=str)) print(json.dumps(route(task, policy, duplicate).__dict__, ensure_ascii=False, default=str))if __name__ == "__main__": demo()
健康状态下,任务获得 EXECUTE;工具错误、延迟、积压和成本同时超限时,任务降为 SUGGEST;一旦出现重复写入,决策变为 BLOCK。这些结果由确定性策略产生,不需要模型理解监控曲线。
13 / 8.12 事故处理要先止损,再讨论 Prompt
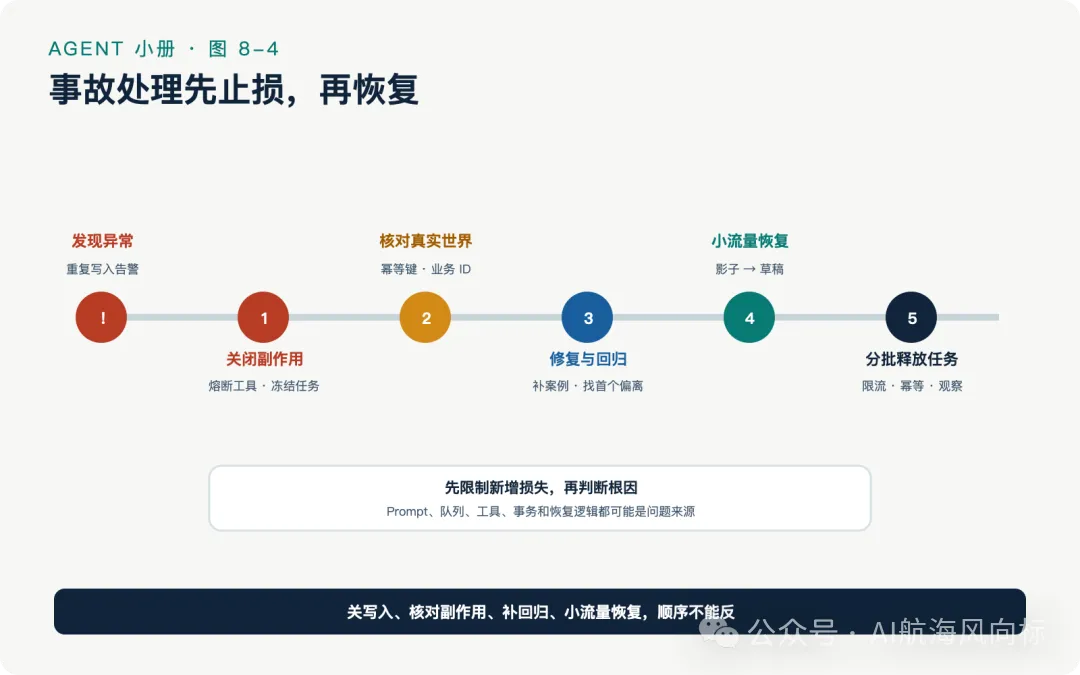
假设监控发现一分钟内出现三张重复工单。正确顺序是:
01 关闭对应写工具或全局写入;
02 冻结仍在运行和等待恢复的相关任务;
03 根据幂等键与业务 ID 统计真实副作用;
04 保存发布配置、Trace 和外部响应;
05 将用户入口降级到建议或人工流程;
06 修复后用事故案例补充回归评测;
07 从影子或草稿模式重新开始灰度。
不要第一时间修改 Prompt 然后继续全量运行。重复工单可能来自队列重复投递、幂等记录事务失败、工具超时或恢复逻辑,不一定与模型有关。
恢复时也不要把所有挂起任务一次性重新放出。先按场景和版本分批恢复,确认不会重复执行已经发生的副作用。
图 8-4:事故处理先关闭副作用并核对真实世界,再修复、回归和小流量恢复。Prompt 调整只是可能的修复之一。
14 / 8.13 上线后的产品反馈比模型分数更诚实
除了技术指标,还要看用户和运营行为:
• 用户是否重复咨询同一个问题;
• 客服是否采纳、修改或完全丢弃建议;
• 自动创建的工单有多少被关闭为无效;
• 用户是否在 Agent 回复后转人工;
• 不同语言、渠道和地区的效果是否一致;
• 自动化节省的时间是否大于审核与返工成本。
“人工采纳率低”不一定说明模型差。可能是建议出现得太晚、证据展示不清、客服不信任来源,或者操作界面多了一次点击。Agent 是一套产品流程,优化对象不能只盯着模型输出。
上线后每周可以做一次失败评审:抽取高成本、低采纳、重复咨询、超时和人工纠正的任务,查看完整 Trace,决定是修工具、改规则、补评测还是调整交互。
15 / 8.14 八组生产演练
正式放量前,至少完成下面的演练:
01 模型服务不可用:入口降级,任务可稍后恢复,不丢用户请求。
02 支付工具错误率突增:自动停止扩量,并降到建议模式。
03 重复写入出现一例:写工具立即熔断,相关任务全部冻结。
04 人工队列积压:减少流量或收紧自动接管条件。
05 成本每小时翻倍:定位调用数、上下文和重试变化,暂停候选版本。
06 错误规则发布:按 release_id 回滚,并保持旧任务使用旧版本。
07 停止开关失效:验证工具网关的第二层策略仍能拒绝写入。
08 恢复风暴:分批释放挂起任务,确认下游限流和幂等正常。
每次演练记录发现时间、停止时间、最大影响范围和恢复时间。只验证“告警发出来了”不够,还要确认值班人员能在目标时间内完成实际止损。
16 / 8.15 上线清单
发布与权限
• 是否定义影子、建议、草稿和有限执行四个阶段;
• 流量比例与自主权是否分开配置;
• 每一级是否有准入、停止和退回条件;
• 工具网关是否在执行瞬间复查最新策略;
• 任务是否绑定完整 release_id。
指标与预算
• 是否同时监控质量、安全、性能和效率;
• 是否设置场景切片、P95 与错误预算;
• 越权、重复写入等红线是否单例熔断;
• 单任务与每日成本是否都有上限;
• 是否能从告警下钻到具体任务和外部副作用。
降级与人工
• 每一级自主权是否有可用的降级体验;
• 人工队列是否有容量、时效和积压告警;
• 接管界面是否包含状态、证据、历史和待决动作;
• 挂起任务是否可以冻结、取消和分批恢复;
• 用户是否得到准确的等待与处理状态。
事故与恢复
• 是否有全局、工具、地区、租户和版本级开关;
• 值班人员是否有权限并知道如何操作;
• 是否演练依赖故障、重复写入和恢复风暴;
• 事故是否沉淀为回归案例和监控改进;
• 修复后是否从低自主权阶段重新灰度。
17 / 本章要点
Agent 上线包含两件事:代码接收真实流量,自主权逐级开放。两者必须分开控制。影子、建议、草稿和有限执行让团队在扩大权限时保留清楚的止损边界。
生产控制面管理版本、流量、权限、预算、人工队列、熔断和恢复。模型运行时只执行当前策略允许的任务,不能自己决定是否健康、是否继续放量。
一次可靠发布不以“全量”为终点。它应该能在指标恶化时自动降级,在出现安全红线时立即阻断,在事故修复后从低风险阶段重新开始。
生产发布只是下一段工作的起点。Agent 接收真实流量后,团队还要能回答“哪一步变慢、哪条证据错了、重试是否污染状态”,并在优化延迟与成本时守住正确率。第九章继续完成可观测性与故障定位,第十章用实际基准测试处理性能和成本。
写在最后
真正可靠的 Agent,不只会调用工具,还要能被发布、观察、回放和持续优化。