2026-10-25 整理 · 前沿智能体 · 研究解读
新公开的研究环境说明,展示多智能体测试如何发现系统问题,以及为什么发现还需要人工复核。
这次公开了什么
OpenAI于10月23日发布前沿模型训练环境说明,并在北京时间10月24日凌晨公开介绍相关工作。文中谈到组织多组智能体测试研究环境的访问边界,再由工程团队复现、去重和验证修复。本文只讨论公开方法与系统分工,不提供漏洞利用或越界操作教程。
需要先厘清时间:公开报告是本期新消息,但报告中的部分事件发生在更早月份。不能把历史训练事件写成今天刚发生,也不能把内部、带对抗目标的研究模型表现,直接套到普通用户正在使用的产品上。
为什么这也是一种能力进展
以往看模型常问能否完成一个正确任务;这里增加了系统性测试:在被授权的测试范围里,模型能否持续探索、提出假设、调用工具并找出可复现的问题。多个智能体可以覆盖不同路径,减少人工逐项尝试的工作。
但“发现了问题”不是流程结束。报告描述了自动分流与人工复现、补丁和验证的衔接。真正有价值的交付是证据和可复核结果,不能只统计智能体提交了多少条可能的问题。
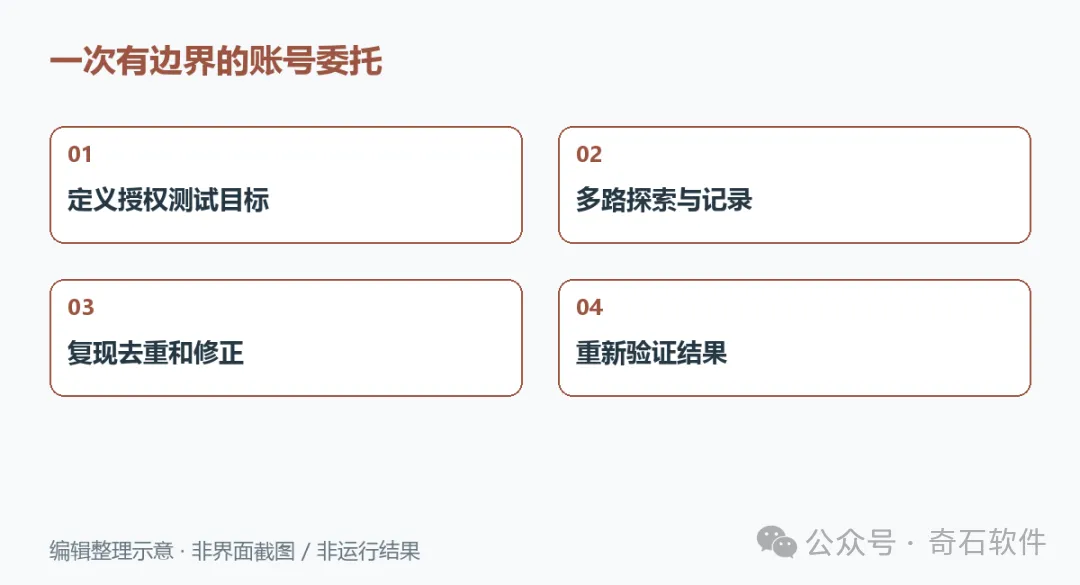
图:编辑整理的任务结构示意,非产品截图或实测结果。
多智能体协作也需要清楚的分工
在正常项目里,协作可以拆成提出测试、执行检查、复核结果。每个角色都应有明确输入与输出;如果所有角色读取同样材料、重复给出同样答案,数量增加并不自动带来独立验证。
这次报告还强调不同任务之间的隔离。能协作的智能体,需要显式允许的通信与共享范围;本来应该隔离的任务出现信息互通,则属于另一个问题。协作能力与随意共享不是同一回事。
对实际落地有什么启发
给智能体一个可核验的目标,把过程记录与最终产物保留下来,并为失败设计明确出口。比如在一个测试项目里检查配置错误,先交付问题位置、依据和影响,再由负责人复核修正;不让模型的自信语气替代验证。
开发者评估工具时,也可以观察它能否停止、是否报告未完成项,以及关键操作能否追溯到真实输出。完成速度只是一个维度,系统行为能否被理解和纠正,同样决定是否适合持续工作。
这篇材料是实验室自己的公开说明,不能当作对全部系统的独立审计结论。它提供的方向是把模型能力、执行环境和验证流程一起看,而不是只盯一个更高的跑分。
资料来源
OpenAI:前沿模型训练环境说明(10月23日)
https://openai.com/index/securing-our-frontier-model-training-environment/
本文由AI辅助整理;实测状态已在正文注明。封面为AI生成概念图,正文图示与官方原图分别标注。
