客服 Agent 跑了三个月,这周突然有用户投诉答非所问——翻日志只看到一串 200,翻不到它当时在想什么。模型从 A 换成便宜一半的 B,老板问省了多少钱、掉了多少分,你拿不出数。上周五有人顺手改了一行 system prompt,没跑任何测试就合了,周一线上的表现判若两套系统。
三个问题指向同一件事:发布链路里没有一道质量闸门,出了事既定位不了、也量化不了、更拦不住。
先把结论摆在前面:
| |
|---|
| AI 产品团队把 LLM / Agent 功能上线后,要定位生产问题、在发布前回归测试 prompt 与模型变更、在生产流量上持续监控质量漂移。Canva 用它追踪调试生产环境的生成式设计功能,官方口径 21 家 Fortune 50 在用 |
| 应用可埋点(Python/TS SDK、OTel 或 LiteLLM 代理,100+ 集成,不锁框架);自托管需一台能跑 Docker 的机器(六个服务),或先用 Cloud 免费层(5 万 units/月、2 用户);跑 LLM-as-judge 要一个支持结构化输出的 judge 模型;有人按周维护数据集与评估器 |
| 一条闭环:生产 trace 一键转成数据集条目 → 改动先在数据集上跑离线 experiment 对比基线 → 接 GitHub Action 做发布门禁 → 线上挂 observation 级评估器(LLM-judge + 确定性代码校验)持续打分 → 逃逸的失败 case 回流数据集,抓一次长一次 |
| 把生产事故变成永久回归资产,评估不过直接阻断 merge;线上评估走异步队列,官方文档口径 observation 级数千条评估每分钟、秒级完成,采样 5% 就能把 judge 费用压到可控;代价是自托管要运维六个服务、judge 有 API 费和评分方差、项目迭代快需锁版本 |
读完你能拿走的:一套三天内可跑通的生产级评测闭环——自托管平台、埋点、数据集反挖、离线回归、CI 门禁、线上监控,每一步都有可复制的命令和代码。
一、技术背景:评测为什么总是和发布脱节
LLM 应用上线后和传统软件完全两副面孔。一次用户请求背后是几十次模型调用加工具执行,链路长、非确定、输出没有唯一正解。传统监控看到的全是 200,质量塌了仪表盘毫无波澜。这类系统的质量工作落在三个环节,每个环节都有人做、但做的人互相不说话。
只做离线 benchmark 的,跑分与线上分布脱节。SWE-bench 上漂亮的分数,救不了客服 Agent 在真实用户方言提问面前的溃败。只做 tracing 的,看得到每次调用的输入输出,但失败依然是"人工看了算"——看得见,判不了,更拦不住发布。只做人工评审的,撑不住——两人团队评审一周的量,可能赶不上产品一天的迭代。
三套东西往往还散在三个工具里:trace 在观测平台,数据集在自建表格,门禁在某个没人敢动的脚本。中间的搬运靠人肉,数据集更新永远慢线上一步。
Langfuse 的做法是把这五件事——追踪、数据集、实验、评估器、prompt 版本——放进同一个开源平台,让它们互相咬合。生产 trace 一键转数据集,评估器直接跑在生产流量和实验结果上,CI 门禁把分数变成 merge 条件。链路通了,评测才跟得上发布节奏。
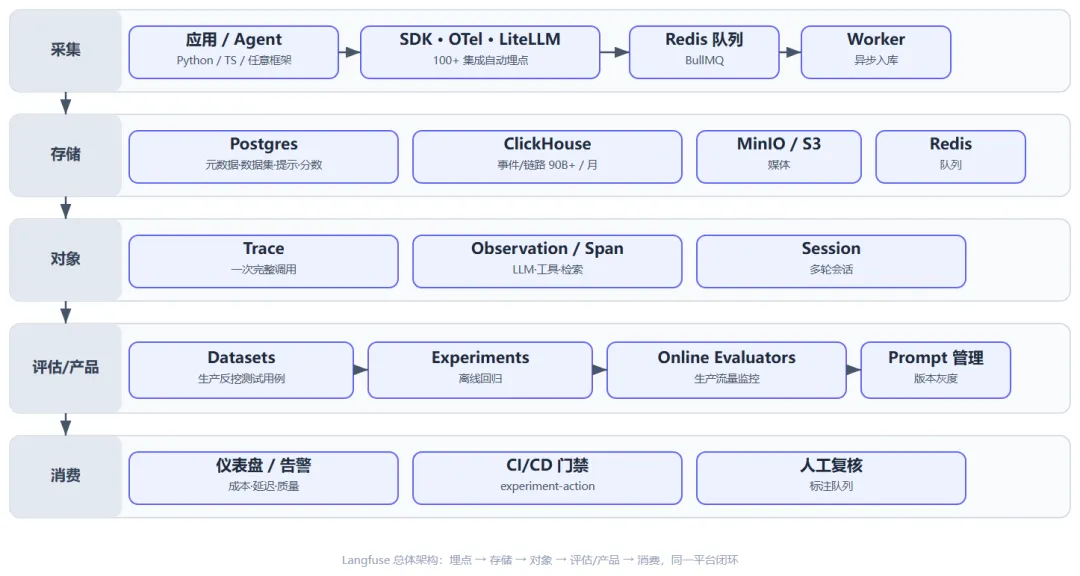
从上往下五层:应用埋点走 SDK、OTel 或 LiteLLM 进 Redis 队列,Worker 异步入库到 Postgres、ClickHouse、MinIO、Redis 四件存储;平台对象是 Trace、Observation、Session 三级;评估产品层挂 Datasets、Experiments、Online Evaluators 和 Prompt 管理;最底下是仪表盘告警、CI 门禁和人工复核。ClickHouse 单独列出是因为它扛的就是每月 90B+ 观测事件这个量级。
它是给谁用的:算法工程师负责埋点和评估器代码,评测负责人守数据集和阈值,应用开发者吃门禁的反馈;产品经理和领域专家也没被排除在外——标注队列和评估器配置都有 UI。真实采用方这边,Canva 的 AI 团队靠它追踪和调试生产环境的生成式设计功能,官方案例里还有市场经理没让工程帮忙、自己配了一个语气监控用的 LLM 评审。开源社区 3.5 万+ star、10 万+ 工程师在用,MIT 许可的核心功能全量开源,企业版目录里另有收费项。
二、实现路径:八步跑通一条生产评测闭环
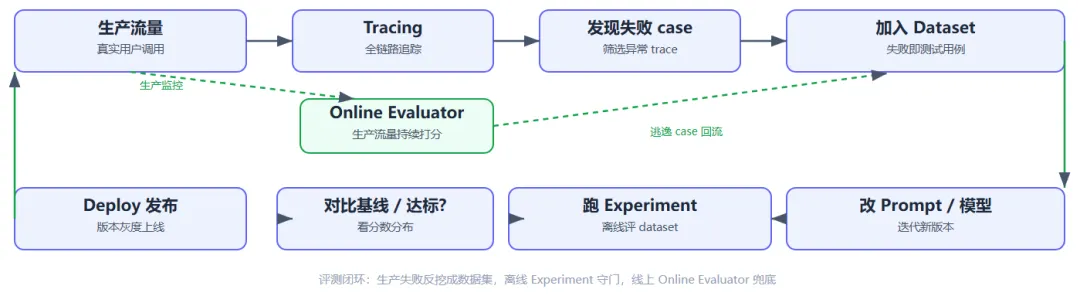
闭环一圈:生产流量经 Tracing 落库后筛出失败 case 加进 Dataset;改动在 Dataset 上跑离线 Experiment、对比基线,达标才发布;上线后 Online Evaluator 持续给生产流量打分,漏网的逃逸 case 回流成新的数据集条目。下面八步就是把这条环拆开装。
第 1 步:把平台跑起来
目标:拿到一个可登录的 Langfuse 实例和一对 API key。
mkdir langfuse && cd langfusecurl -o docker-compose.yml https://raw.githubusercontent.com/langfuse/langfuse/main/docker-compose.yml# 生成两把一次性钥匙,丢了数据不可恢复openssl rand -hex 32 # -> SALTopenssl rand -hex 32 # -> ENCRYPTION_KEY
compose 里有 7 处 CHANGEME 必须改:SALT、ENCRYPTION_KEY、NEXTAUTH_SECRET、POSTGRES_PASSWORD、CLICKHOUSE_PASSWORD、REDIS_AUTH、MINIO_ROOT_PASSWORD。全部支持用 .env 文件注入。六件服务随 compose 一起起:langfuse-web(对外 3000 端口)、langfuse-worker(仅本机 3030)、Postgres 17(元数据)、ClickHouse 25.12(事件)、Redis 7(队列)、MinIO(媒体对象存储),除 web 和 MinIO 外其余只绑 127.0.0.1。
docker compose up -dcurl -I http://localhost:3000 # 返回 200 即成功
注册组织、建项目,在 Settings → API Keys 生成 pk-lf- 开头的 public key 和 sk-lf- 开头的 secret key。验证成功的标志是登录页能开、项目里能看到空白的 Traces 页。首次启动要拉六个镜像加跑数据库迁移,5–10 分钟正常;之后重启秒级。
不想碰运维的,先走 Cloud Hobby 免费层(5 万 units/月、2 用户),流程跑通了再自托管,两边 SDK 代码完全一致。
第 2 步:埋点,让第一条 trace 落地
目标:跑一次业务请求,UI 里能看到完整调用树。
pip install langfuse openai
from langfuse import Langfuse, observefrom langfuse.openai import openai # 替换 openai 导入,LLM 调用自动记录lf = Langfuse(public_key="pk-lf-...", secret_key="sk-lf-...", host="http://localhost:3000")@observe()defretrieve(query: str) -> str:return"……检索结果……"@observe()defanswer(query: str) -> str: ctx = retrieve(query) resp = openai.chat.completions.create( model="gpt-4o-mini", messages=[{"role": "user", "content": f"{ctx}\n\n{query}"}], )return resp.choices[0].message.content
@observe() 包住的是 span 粒度(检索、工具调用),from langfuse.openai import openai 让每次模型调用自动带上 token 数、耗时和成本。不走 OpenAI 的用 OTel 埋点或 LiteLLM 代理接入,SDK v3+(Python)/ v4+(JS)底层已全面切到 OTel,任何能出 OTel 数据的框架都能进。
验证:跑一次 answer("怎么退款"),Traces 页出现一条 trace,展开是 retrieve 子 span 和一条 generation,各自有输入输出和成本。看不到子 span 就检查装饰器是否真的包到了函数上。
第 3 步:从生产反挖数据集
目标:攒第一批真实回归用例,这一步决定后面一切评测的说服力。
lf.create_dataset(name="support-agent-regression")lf.create_dataset_item( dataset_name="support-agent-regression",input={"question": "用户原话……"}, # 生产真实输入 expected_output={"answer": "专家补的期望"}, # 领域专家填 source_trace_id="clx…", # 回链原始生产 trace)
更省事的路径在 UI 上:Traces 里筛出这次没答好的失败 case,点 Add to dataset 直接入库;Observations 表支持勾选多条批量加。数据集天生和源 trace 挂钩,评审的人随时能跳回去看当时的完整上下文。
验证:Datasets 页出现条目,每条能一键跳回源 trace。起步规模 10–50 条就够,别贪多——真实失败样本比凑数量重要得多。
第 4 步:写评估器,确定性地板 + judge 天花板
两类评估器分工明确:规则能判的绝不惊动 LLM,省钱且零方差。
代码评估器是普通 Python 函数,跑在实验结果和线上数据上(2026 年 5 月底正式可用,自托管需配置 dispatcher):
defcitation_guard(*, output, **kwargs):# 确定性校验:客服回复必须附引用来源 ok = "来源"in outputreturn {"score": 1if ok else0, "comment": "引用格式校验"}
主观维度上 LLM-as-judge:在 UI 的 Evaluators 页新建,judge prompt 里写清评分标准(rubric)和变量占位符({{input}}、{{output}}、{{expected_output}}),先拿最近的真实数据预览再上线。judge 模型必须支持结构化输出,否则分数解析不出来。不想自己写 rubric 的,官方目录里有与 Ragas 等合作维护的现成评估器:幻觉、上下文相关性、毒性、帮助性。
验证:手动触发一条,score 正确挂在对应 trace/observation 上,且 comment 里的理由说得通。
第 5 步:跑离线 experiment,守住发布门
ds = lf.get_dataset("support-agent-regression")deftask(*, item, **kwargs):# 换 prompt、换模型、换检索策略,只改这里return answer(item.input["question"])ds.run_experiment( name="v2-cheap-model", description="gpt-4o -> gpt-4o-mini 全量回归", task=task, evaluators=[citation_guard, judge_evaluator],)
跑完在 Experiments 页两次 run 并排对比,每条 case 的输出、得分、成本一目了然。数据集支持按版本时间点取快照,历史对比可精确复现。评估器的具体签名和导入路径以装到的 SDK 版本文档为准,可调用对象返回 {"score": ...} 的形式是通用兜底。
Agent 有非确定性,单次 pass/fail 不可信:每条 case 重复 5–20 次,看分布不看单点。验证标准是给同一个 prompt 跑两次,分数分布应当接近,差太远说明评估器本身在抖。
第 6 步:接 CI 门禁
官方 langfuse/experiment-action 在 PR 上跑实验,评估不过就 fail pipeline、阻断 merge:
# .github/workflows/eval-gate.ymlname:eval-gateon: [pull_request]jobs:eval:runs-on:ubuntu-lateststeps:-uses:actions/checkout@v4-uses:langfuse/experiment-action@v1env:LANGFUSE_PUBLIC_KEY:${{secrets.LANGFUSE_PUBLIC_KEY}}LANGFUSE_SECRET_KEY:${{secrets.LANGFUSE_SECRET_KEY}}LANGFUSE_HOST:${{secrets.LANGFUSE_HOST}}
(action 的详细入参见其仓库 README;不用 GitHub 的,SDK 脚本塞进任何 CI 都行。)验证:故意提交一个退化 prompt 版本,PR 应当变红。
第 7 步:挂线上评估器,监控真实流量
UI → Evaluators → Set up Evaluator,三个关键选择:目标选 Live Observations 而非整条 trace——只评"最终回复"这一类操作,秒级完成、数千条评估每分钟(官方文档口径),还能按操作类型组合评分(毒性评 LLM 输出、相关性评检索、准确性评生成);过滤器选 trace tag、userId、会话等维度圈定范围;采样率起步设 5%,这是成本总阀门。trace 级属性要用 propagate_attributes() 在埋点时显式上挂,否则线上过滤器拿不到。
验证:生产 trace 详情页自动出现 score,Score Analytics 里有分布和告警。线上抓到的逃逸 case,回到第 3 步加进数据集——闭环闭合,抓一次长一次。
关键超参表
常见报错与规避
| | |
|---|
| | |
| | |
| | |
| | |
| | |
| | |
| | 配 LANGFUSE_LLM_CONNECTION_ALLOWED_HOSTS |
跑起来要花多少
三档成本,按团队量级选:
| | | |
|---|
| | | |
| 一台 2–4 vCPU / 8GB VM,约 $10–20/月(第三方开源评测栈综述口径) | | |
| | | |
judge API 是主要变动成本,粗算口径:一次 judge 调用就是一次普通 LLM 调用的钱,100 条 case × 5 次重复 = 500 次调用,按所选模型单价一乘就出来;线上评估配了 5% 采样,等于全量打分五分之一的账。
三、原理:这套闭环为什么有效
评测最贵的环节在造数据集,不在跑评测。人工攒一条"真实用户会怎么问、期望答什么"的用例,专家要花几分钟到几十分钟;而生产 trace 本身就是真实分布的免费数据源,一键转数据集把造数据的边际成本压到接近零。离线 benchmark 最大的病是分布脱节,这里直接从源头治。
observation 级评估是经济账的关键。评整条 trace 要理解几十次调用的完整上下文,评单次操作只要看那一次的输入输出——粒度降一级,单次评估的 token 成本和延迟都降一个量级,官方口径是异步队列下数千条评估每分钟、秒级完成。成本降下来,"每条流量都评"才可能变成"采样着评",监控才养得起。
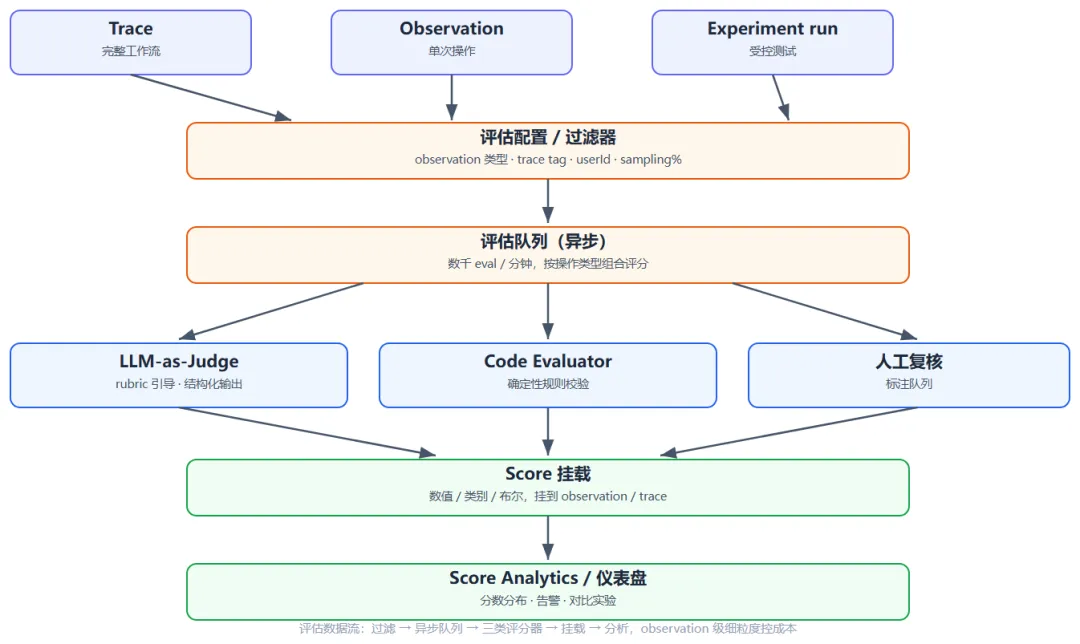
三类评估对象——Trace、Observation、Experiment run——先经过滤器(observation 类型、trace tag、用户、采样率)进异步队列,再分发给三路评分器:LLM-as-Judge 评主观维度、Code Evaluator 做确定性校验、标注队列人工复核;分数挂回对象,最后进 Score Analytics 看分布、配告警。
评分体系是三层结构:确定性代码评估器当地板,规则能判的零成本零方差;LLM-as-judge 当天花板,管规则写不出的主观维度,rubric 把"觉得不对劲"翻译成可重复的评分任务,结构化输出把判断压成机器可读的分数加理由;标注队列当校准器,人审定期抽查 judge 的判断,发现漂了就改 rubric。
# 评估闭环的最小逻辑forcasein dataset: # 生产反挖出的测试用例 output = task(case.input) # 跑被测 agentfor ev in evaluators: # 三类评分器if ev.is_deterministic: score = ev.check(output, case.expected) # 零方差、零成本else: score = llm_judge(rubric, case.input, output) # 结构化输出 attach(score, to=case.run) # 分数挂回实验结果if in_ci andany(r.score < gate for r incase.run): block_merge() # 门禁:不过分,不合码
工程上的取舍要心里有数。judge 换个模型分数就漂,分数只在同一 judge 配置下纵向可比,跨团队横向比没有意义——judge 的模型和 rubric 版本本身也要当资产管理,改动要留痕。统一平台换来自由拼脚本省下的胶水代码,代价是数据形态绑定;好在 REST API 和 S3 导出全量在,随时能搬走。采样率是成本与盲区之间的旋钮,5% 起步再按告警漏报率调,没有万能值。
我保留意见的地方:Langfuse 不回答"什么算对"。ground truth 怎么编码、rubric 怎么写、阈值怎么标,全是你自己的工程活,平台只是让这些活有地方放、能复用、能迭代。另外 MIT 许可盖的是核心功能,ee 目录下的企业项(SSO、审计这类)要商业授权,自托管前先分清你要用的功能在哪个目录。
四、效果验证与适用边界
业务收益单列,按环节算账:发布环节,experiment + CI 门禁把 prompt 和模型变更挡在上线之前,评估不过不合码,这是从"事后救火"变"事前拦截";数据集环节,生产失败一键反挖,数据集跟着线上演化自动生长,造数据的人力趋近于零;迭代环节,prompt 版本化加标签发布,非工程师也能改 prompt 跑实验,Canva 那个市场经理配语气评审的案例就是证明;监控环节,采样 5% 的线上 judge 用小钱换实时质量视野,漂移当天发现而不是等用户投诉。
决策清单,什么条件下这套东西成立:有真实流量(生产反挖的源头)、有埋点能力(一行导入或一个代理)、judge 模型可选且预算可覆盖、有人按周看分数维护数据集。什么条件下退化或失效:冷启动没有生产流量,闭环的第一环就空转,只能手写种子数据集起步;高合规数据不放心把 trace 发给外部 judge 模型,得自托管配本地模型;全流程都是确定性规则的话,上平台反而是负担;团队没有周度 review 的纪律,数据集会长灰。
换业务、换模型要重验的前提:rubric 对新业务域是否还成立(客服的"有帮助"和代码助手的"有帮助"不是一回事);采样率与告警阈值要按新流量重新标定;judge 模型与被评模型是否同家族——这个问题下一节再说。已知局限与合规:trace 天然含用户数据,PII 处理和数据出境要自己把关(自托管 + 本地 judge 模型可解);SALT 与 ENCRYPTION_KEY 丢了数据不可恢复;judge 有固有偏见,分数是相对刻度不是绝对真理。
复现清单
上手三步走
docker compose up -d 起平台(或直接用 Cloud 免费层),建项目拿 API key;- SDK 埋点跑通第一条 trace,确认调用树和成本都可见;
- 从生产反挖 10 条失败 case 建数据集,挂一个代码评估器 + 一个 LLM-judge,跑第一次 experiment 对比基线。
踩坑记录:SALT / ENCRYPTION_KEY 一次设好不可逆;judge 必须支持结构化输出;线上评估必配采样率;trace 级过滤属性要在埋点侧 propagate_attributes() 上挂;自托管调外部 judge 模型记得配 egress 白名单。
实用评分卡
| | |
|---|
| | compose 一键起,SDK 文档全,命令可直接照抄 |
| | |
| | |
| | |
| | |
关键链接
- 源码:github.com/langfuse/langfuse(MIT 核心)
- 文档:docs.langfuse.com(self-hosting / evaluation / experiments 三节最相关)
- CI 门禁:github.com/langfuse/experiment-action
- 自托管 compose:github.com/langfuse/langfuse → docker-compose.yml
今日反问:当 judge 模型和被评 Agent 出自同一个模型家族,它打出的高分究竟在证明质量,还是在证明它们早已达成共识?