《告别“玄学”调参:如何用量化闭环评测 Agent Skill 的真实收益?》
- 更新时间 2026-10-21 09:04:34
PART 01
引子:一个被悄悄跳过的问题
近三个月,我啃了大量 Agent 领域的文章,越读越有一种强烈的错位感。 业界讨论 Agent Harness 的密度已经高到泛滥——工具怎么调用、上下文怎么管理、链路怎么追踪,这些“基础设施”问题被翻来覆去讲透了。但一个更根本的问题被悄悄跳过了: Skill 才是 Agent 工程的地基。 Harness 决定 Agent“能不能跑”,Skill 决定 Agent“跑得好不好”——业务逻辑、步骤编排、质量标准,全压在这几份不起眼的文件上。
而地基的质量,恰恰没人管。 这不是危言耸听。
在当下的 Agent 生态里,Skill 的生成成本已经趋近于零:让模型自己写一份 SKILL.md,几分钟就能“捏造”一个新能力。生成不再是难题,难题是—— 你怎么知道这份 Skill 是好的? 你可能觉得多余:跑一遍看结果,不就知道了?麻烦恰恰在这里。Agent 的行为是概率性的,同一个 Skill 跑十次可能有十种输出;你看到一次成功,是 Skill 写得好,还是模型这次恰好“状态在线”?你改了一版 Skill,分数涨了,是优化生效,还是评估器在端水? 没有一套可信的评测,我们对 Skill 的一切判断,本质上都停留在“感觉不错”的玄学层面。 所以这三个月沉淀下来,我得出了一个也许反直觉的判断: 在 Agent 工程里,评估比生成更值得投入。
实验设定:两个项目与一条因果链
我选了两个 openEuler 系的开源项目来回答这个问题:
实验对象是 AET 的 /aet-design 指令——一条负责生成设计文档的多 Skill 流程。
选它有个现实原因:文档类任务产物结构稳定、可对比、可打分,比代码任务更适合做评测方法论的第一块试验田。 于是整个实验要回答的,其实只有一个问题: Skill 的质量,到底能不能被度量? 我们设想的验证链条是自下而上的:
skill 优化 → 交付物变化 → 评估指标变化
这条链看起来平平无奇,但每一环都埋着陷阱:
而是一个更底层的问题:这套“从交付物反推 Skill 质量”的验证链,到底成不成立,能不能行。
PART 02
标准答案:双仓与代码锚点
验证链条的第一环,是要有一份“好文档”当尺子。但绝大多数任务没有现成的 ground truth,让人类专家手写参考答案,成本高到不现实。 我们的解法是双:
旧仓库:跑未实现需求的版本;
新仓库:跑已实现的版本;
两边执行同一个设计任务,新仓库的产出充当参考答案。 这看起来像循环论证:参考答案也是 Agent 生成的,用 Agent 生成的东西去评判 Agent,算数吗? 能,但前提是锚点。参考答案虽然由 Agent 写成,却锚定在已合入的真实代码上——Agent 的任务从“想象功能该怎么做”变成了“描述功能实际怎么做”。前者会虚构,后者有代码兜底。
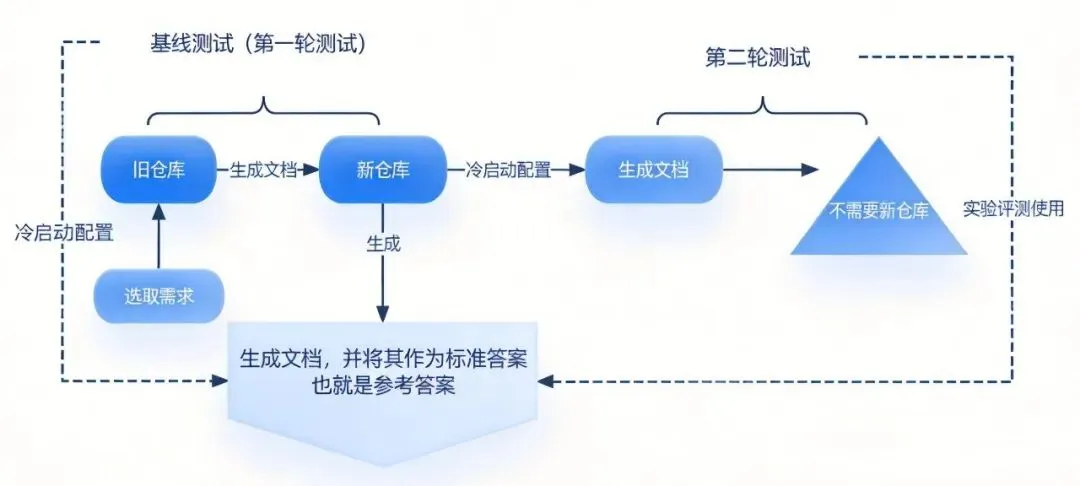
一句话:参考答案可以由 Agent 生成,但必须有代码级锚点。锚点不存在,评测就是两份幻想互相打分。
PART 03
综合均分,是一场精心包装的骗局
评估环节最反直觉的发现在这里。 这里我们采用了4个自定义评估器,两两配对,同一个 Case 我们跑两遍评估:
正序:AET 在前、参考在后;
逆序:参考在前、AET 在后。 理论上裁判只看内容,两次判断应当一致——但 LLM 裁判有位置偏差,这是被反复验证的系统性现象,不是噪声。所以真实胜负只能看配对方向,不能看算术平均。 用这个标准回看四轮测试,结论和直觉完全相反:
荒诞之处在于:按综合均分,第四轮远好于第三轮;按配对规则,第三轮是真赢,第四轮是废局。 综合均分把真实结果完全排反了。 教训只有一句:分数的结构比分数本身重要。一个不能反映信号方向的指标,再科学的外表也是伪科学。
顺带一提:那次暴跌,锅不在 Skill
第二轮那次 42.3 的暴跌,排查后真相完全出乎意料:评估平台看不到 trace 里的中间产物,AET 生成了文档却没显式交付,评估器拿到的输入只有一句“将提交文件”。 评估器只能看见喂到嘴里的东西。
PART 04
因果闭合:三条链都立住,才算证明
指标从 36 涨到 51.8,就等于 Skill 变好了吗?我们把论证拆成三条独立的链:
链 A:Skill 真的被改了
证据不依赖文档分数——平台对 Skill 本身的六维评估上升,版本历史每一版都有采纳记录。
链 B:改动导致了文档改动
指纹级对应:把“内联五原则”改写成“复用并扩展现有模块”之后,新文档恰好用真实代码的关联过滤替代了那个虚构函数。改哪条规则,文档就变在哪个点。
链 C:文档改动导致分数上升
评估器最初的扣分理由逐字点名——“检索参数写成 q、设计了不存在的助手函数”——这些扣分条目在改后文档里被逐条消除。
三链合璧
最有说服力的不是“分数涨了”,而是:扣分项 = 被修复的文档项 = Skill 优化项,三者同源。
PART 05
所以,能不能行
诚实地说:能行,但行的是一条窄门。
✅ 它行的场景:回归验证
已有可信参考答案时,确认“这次改动没改坏”“那个点确实修好了”。尤其抓 Skill 诱导的幻觉——q参数那种模型一本正经虚构的东西,人眼 review 容易漏,评估器对着代码一比就现形。
❌ 它不行的场景:绝对质量仲裁:
更根本的边界
这套体系最大的单点故障,是评估器本身。正逆序配对、三档锚定,都是在驯服 LLM 裁判,而不是消灭它的不确定性。评估器定义了“好”,所以它自己必须被持续校准——一个没有终点的循环。
PART 06
结语:链在,结论站得住
回到开头的问题:Skill 的质量能不能被度量? 能——但不是打一个绝对分,而是“代码锚定的参考答案 + 方向性配对 + 三链闭合”这条组合拳。 度量的本质不是测量,而是建立一条每一环都有独立证据的因果链。 链在,结论站得住;链断,再漂亮的分数也只是噪声。 如果你也在做 Agent Skill 的工作,我的建议只有一句:
前者是手艺,后者是科学——而这个领域现在缺的,恰恰是科学。
AET项目网址:https://gitcode.com/openeuler/agentic-engineering-team
Agent-insight网址:https://gitcode.com/openeuler/agent-insight
提交issue:https://atomgit.com/openeuler/agentic-engineering-team/issues/44
PS:
最后,做个小小的推荐,目前正在进行的项目:
Agent Insight:openEuler孵化的项目,旨在让每一个Agent 都可被观测、可被评估、可自我进化。
AET(Agentic Engineering Team):openEuler孵化的项目,全流程 AI 辅助研发底座/引擎,覆盖从需求分析、设计、编码、测试到发布、运维的软件研发全生命周期。
Skill Radar:给Agent Skills技术画一张”活地图”,追踪Skills技术,让Agent能力进化有迹可循。
如果你对Agent Insight、AET感兴趣,欢迎参与进来,一起把它变得更好~~
🔗 Agent Insight:https://atomgit.com/openeuler/agent-insight
🔗 AET:https://atomgit.com/openeuler/agentic-engineering-team
更多Agentic AI技术前沿分享,欢迎扫描下方二维码进入技术交流群(或者添加群助手ID:qstarsky 邀请您进群交流)