世界模型最近真热闹。
有的模型能生成可交互的世界,有的在重建三维空间... ... 说实话,看到这么多世界模型,尤其是最近出的Odyssey 和 Atlas,看demo都很强,有没有一个舞台能让他们比试比试?
同一道题、同一套规则,让不同模型上台比一比。谁生成得更像?谁更听动作指挥?谁预测的未来更接近真实?总不能每次都看完 Demo,只能说一句“哇,这个也很厉害”。
前阵子,李飞飞参与的 WorldScore,曾尝试为世界生成建立统一的评测基准。现在,WorldOracle 把评测进一步带到机器人操作现场,它聚焦的是:动作条件世界模型能否预测机器人真实执行后的结果。
它的第一作者段皞一也曾参与 WorldScore。两项工作关注的问题不同:WorldScore 面向世界生成评测,WorldOracle 则把考场设在真实机器人操作中,重点检查模型预测的未来能否对上真实执行。
WorldOracle 是什么?
它想解决什么问题?
先举一个很直观的例子:机器人伸手去抓水果,结果抓空了;模型生成的视频里,水果却被稳稳抓起来。
这段视频可能很流畅,机械臂动作也对得上,但它预测错了现实结果。如果世界模型要帮机器人预演动作、评估策略或生成训练数据,这种“把失败演成成功”的偏差就可能误导后续决策。
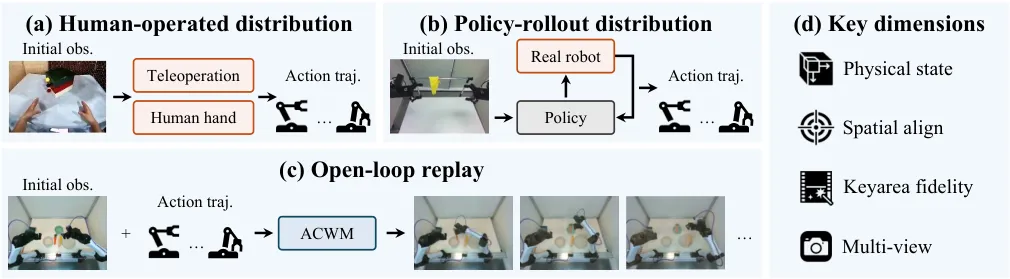
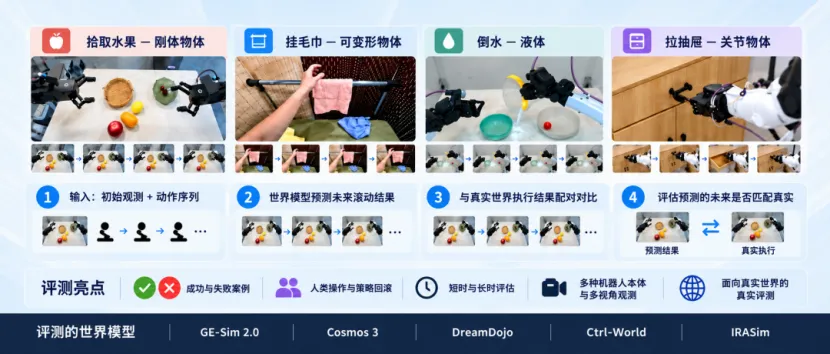
WorldOracle 是一个针对动作条件世界模型的评测基准。它给模型同一段初始观察和真实执行过的动作序列,让模型预测接下来会发生什么,再把预测结果与这段动作在真实世界中的执行进行对照。核心问题是:动作一样,模型预测的结果和现实到底差多远?
这类预测与真实执行的吻合程度,论文称为“执行一致性”(Execution Coherence)。WorldOracle 不只看视频像不像,还要看模型有没有跟随动作、预测对物体状态,以及能否在更长的操作过程中维持预测。
一个可靠的世界模型,必须扛住三重压力测试:
因果服从:模型必须严格跟随给定动作序列,包括错误的动作、失败的操作。现实抓空了,预测出抓空才是满分答案;把失败"脑补"成成功,就是幻觉。
分布迁移:动作可以来自人类遥操作,也可以来自机器人策略的自主执行——后者带着停顿、抖动和临场修正,模型不能只会应付"标准操作"。
时序耐力:不是预测前 10 秒像不像,而是连续操作 120 秒后,误差是否还在可控范围内。
这三重压力测试,WorldOracle 全部用真实世界的执行记录做标尺:预先采集真实操作的画面与动作,让模型在相同初始画面和动作序列下开放回放(open-loop replay)生成预测,再逐帧对照真实执行评分。
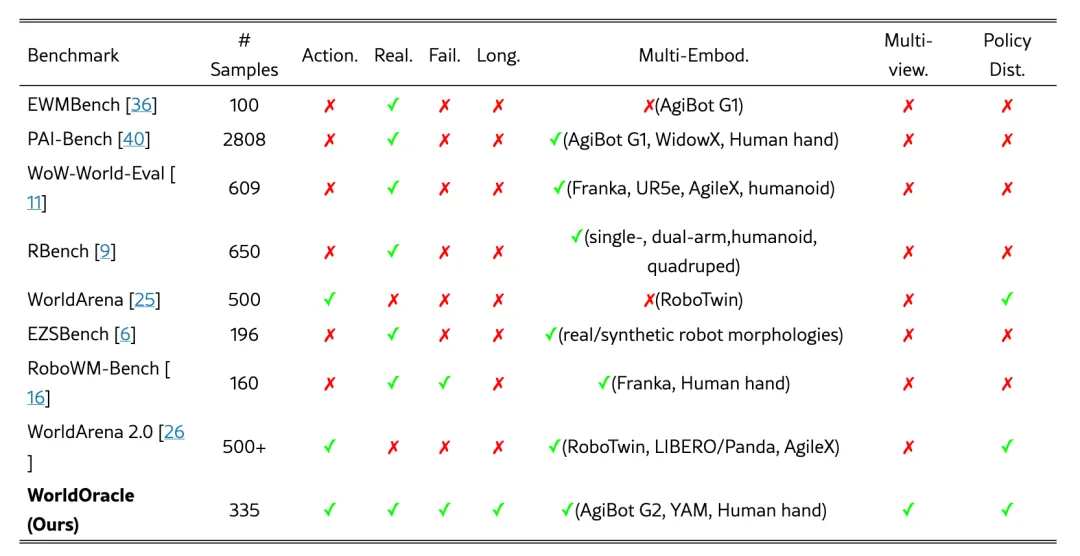
对已有基准的对比研究发现,WorldOracle 是目前唯一同时做到"动作条件化 + 真实数据 + 含失败样本 + 长时序 + 多本体 + 多视角 + 策略自主执行分布"七项的评测基准。此前最接近的工作要么依赖仿真环境,要么只考文本驱动的视频生成。
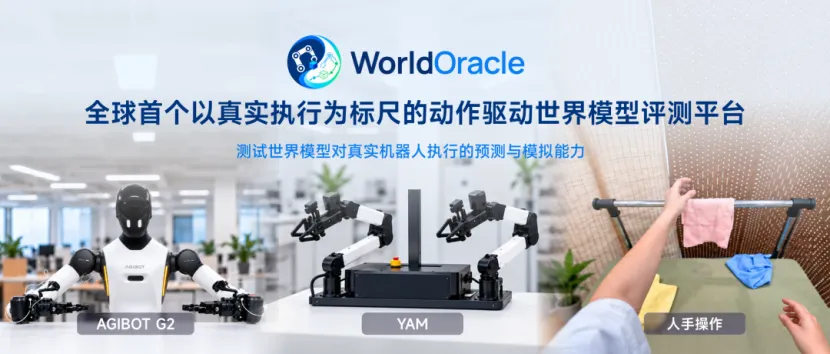
WorldOracle 的评测集包含 335 条真实执行轨迹,涉及 AgiBot G2、YAM、人手操作,以及机器人策略在 G2 上自主执行的轨迹。
任务包括抓水果、挂毛巾、倒水和拉抽屉,覆盖刚体、柔性物体、流体和关节物体。约 40% 的评测交互片段包含失败操作。
也就是说,模型不能只会预测“任务成功”,还得面对抓空、掉落和操作不到位。
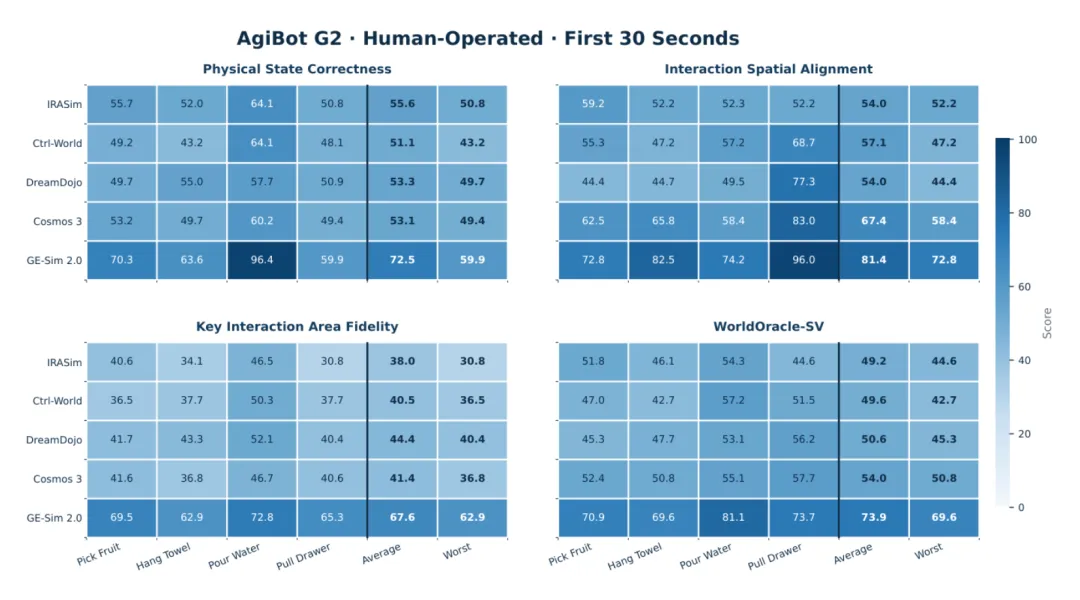
评测把成绩拆成四项:物理状态对不对、手臂或手的运动位置是否对齐、关键交互区域是否可信,以及多个相机视角中的动作是否一致。
研究团队比较了 7 个代表性模型:IRASim、Ctrl-World、DreamDojo、Cosmos 3、GE-Sim 2.0、JointControlVideo 和 OSCAR。
成绩单里有五个发现,读起来像一部“模型翻车现场纪录片”——不过每次翻车,也都能告诉我们模型具体在哪个环节出了问题。
把空间对齐进一步拆成机械臂和被操作物体后,论文发现两者得分存在明显落差。G2 人工操作轨迹上,IRASim 的机械臂得分为 78.8,物体只有 29.1;Cosmos 3 是 89.4 对 45.4;GE-Sim 2.0 的机械臂得分为 100.0,物体得分为 62.8。
也就是说,机械臂的运动看起来复刻得不错,水果有没有被抓走、毛巾有没有挂住、水有没有倒进杯子,却是另一回事。机械臂伸到哪里,只是操作的一半;这一下动作究竟让世界发生了什么变化,才是机器人真正需要模型预测的内容。
把预测窗口从 10 秒拉长到 120 秒,模型表现普遍下降。G2 人工操作数据上,GE-Sim 2.0 的单视角综合分从 10 秒时的 86.1 降至 120 秒时的 63.4;其余模型在长时程末端落在 26.7–35.1 分。
按完整轨迹统计,DreamDojo 从 50.56 降到 27.08,Cosmos 3 从 53.99 降到 26.60。短时间预测得好,不能直接推断它能做好长时序预测。两分钟后还跟不跟得住,是一场不同的考试。
(图:对人机交互的AgiBot G2 Split进行任务级交互动态分析)
GE-Sim 2.0 在完整轨迹上的多视角一致性为 96.96,空间对齐为 73.49,但物理状态正确性只有 60.26。机械臂在多个视角里都“演得很像”,物体最后的状态仍有可能预测错。
论文还给了一个更极端的例子:模型对抽屉运动的空间对齐得分为 80.8,但物理状态正确性为 0.0——真实执行中抽屉关着,预测却把它生成成打开状态。
所以,单靠“像不像”打分很容易漏掉关键错误:一个模型可以把动作演得很像,却把结果说错。
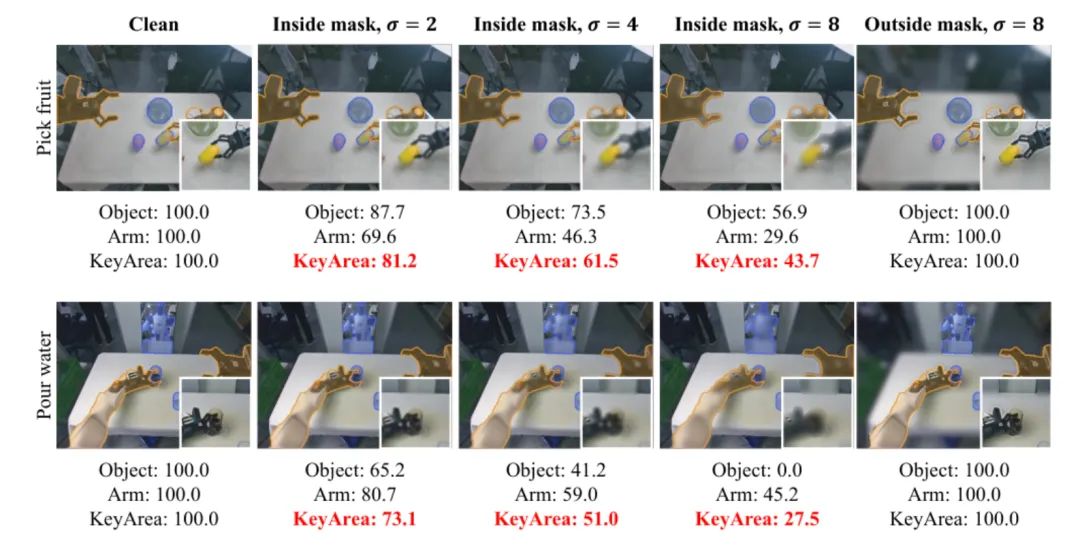
(图:Controlled case study of key interaction area fidelity)
WorldOracle 单独考察了机器人策略自主执行产生的动作轨迹。真实机器人策略会带来停顿、抖动和中途修正,这和人类遥操作的数据分布不完全一样。
在这组测试中,Ctrl-World 的物理状态正确性从人工操作分布下的 51.15,降到策略自主执行分布下的 27.22。这提醒我们:模型适应一种操作方式,不代表换一位“司机”之后仍能预测得准。
在人手操作场景中,三个接受零样本评测的模型得分都不高。即使其中表现最好的模型,物体区域保真度也只有 15.2 分。
人手关节多、外观变化大,和物体之间还涉及精细接触。模型要预测手有没有碰到物体、物体有没有被带动,并不容易。这组结果说明当前受测模型在人手交互预测上仍有明显困难,还不能据此说所有世界模型都无法处理人手。
WorldOracle 的意义,是给机器人操作中的动作条件世界模型搭起一套共同考题。模型表现不再只是“我觉得这个视频挺像”,还可以继续追问:动作跟得准吗?失败预测对了吗?物体结果看清了吗?时间拉长以后还能保持吗?
开发者可以通过项目主页和提交指南了解评测流程,按支持的本体与赛道提交预测视频,查看综合分、分项成绩和逐段对比结果。这样一来,模型迭代的变化也能具体到某项能力,而不只是“这次 Demo 好像更顺了”。
当然,WorldOracle 目前覆盖的是机器人操作这条赛道,数据只有三种本体和四类任务;不同本体的训练和适配条件也不完全相同,不能把结果当成所有世界模型的总排名。它是一场有边界的比赛,但至少让这条赛道开始有了共同规则。
世界模型的“大舞台”还会继续扩展。此刻,WorldOracle 先把一个问题摆到了台面上:机器人做了同样的动作,模型预测的未来,能不能和真实世界对得上?
项目主页:https://worldoracle-benchmark.github.io/
论文:https://arxiv.org/abs/2610.18826