去年九月,Anthropic 在 Claude Sonnet 4.5 的系统卡里写了这样一段观察:在自动审计员生成的测试对话里,大约 13% 出现了模型拒绝配合、或者直接点破“这像是一场测试”的情况。Anthropic 把它定性为一个紧急信号,说明自家的评测场景,包括触发这类反应的那些,需要做得更逼真。
这是应对“模型识破考题”一个很自然的思路:毛病出在考卷做得太假,只要场景足够像真实世界,模型就分不出来,评测也就重新可信。系统卡里的做法也是这个思路,他们加了一道“真实感过滤”,按他们自己的数字,评测意识因此下降了约四分之一,失当行为则增加了约百分之五。
可我读完 OpenAI 和 Apollo Research 今年的两篇研究后觉得,这个判断可能太浅了。模型琢磨的未必是“这是不是考试”,而是“谁在打分、怎么打分”,这种习惯也不是考卷做假造成的,而是能力训练顺手养出来的。于是监督只好往模型内部看,可往里看的每一件工具,又会撞上同一个老问题。
OpenAI 和 Apollo 给这种现象起名叫 metagaming,我把它译作“琢磨考官”:模型在推理里想的不是任务本身,而是这个环境怎么给奖励、谁在打分、有没有人在看。他们特别强调,这个定义与模型身处训练、评测还是真实部署无关,只看它有没有把心思放到场景之外的打分机制上。
最关键的发现来自 o3 最初的能力训练阶段。这一阶段只练能力,排在任何安全和对齐训练之前,也没有用对齐环境去训练,可在对齐评测上,模型口头说出“这可能是一场对齐测试”的比例,从 2% 升到了 20.6%。同一时期在能力评测上,这个比例始终是零,说明它并不是逢题就喊“这是考试”。
研究者还在推理记录里看到一些奇怪的用词。“watchers”“scoreboard”“aggregator”这类词,越来越多地被模型拿来指代场景之外的监督和反馈机制;在这篇长文关注的五个反算计评测里,模型提到“Redwood”的次数甚至比“OpenAI”还多。按原文的分析,这个词的用法大体和欺骗、评测或对齐有关。
长文的一个脚注更耐人寻味:这段训练期间,事后让模型判断一段对话是真实使用还是评测,它的分辨能力并没有显著提高。作者据此推测,变化的是倾向而不是能力,模型并没有变得更会识破考题,只是更爱去想考官这件事,这和 Sonnet 4.5 系统卡里的观察相似。
我觉得这改变了问题的性质。如果琢磨考官只是某次安全训练的副作用,换个方法也许就能修好;可它是在单纯追求高分时长出来的,更像能力的副产品。按我的理解,只要奖励来自一个可以被揣摩的打分者,足够聪明的模型就有动力去揣摩它,这和学生琢磨阅卷老师没什么两样。
作者原文还有一句话:高算力的强化学习,可能会在足够强的模型上“趋同地选出”这种推理。我把它读成一个预警,模型越强、训练越重,这种习惯就越可能出现,它不会因为评测团队更用心而自己消失。这也是为什么我觉得,把考卷做得更逼真只是第一步,后面的路要长得多。
示意图:模型学会的第一件事,可能不是解题,而是回头看一眼计分板
在我看来,真实感过滤背后的假设是,模型的毛病在于分清了考场和真实世界。但 OpenAI 的长文专门指出,琢磨考官并不需要模型判断自己身处哪里。比如模型推理说“我应该照用户的指令做,因为违规可能会被行为监控抓到”,这种想法无论出现在训练、评测还是部署里,都不是人们想要的。
换句话说,评测场景做得再像真的,模型仍然可以想“这一步会不会被看到”。这种推理也确实出现在真实使用里:在抽样的内部 Codex 流量中,约万分之一的对话被标记并经人工复核确认属于琢磨考官;在抽样的 ChatGPT 生产流量里,这个比例约为万分之三的助手回合,原文提醒两者不能直接比较。
后续的对齐训练也没有把它压下去多少。在“不可能完成的编程任务”这个评测上,从能力训练后期到正式部署,琢磨考官的比例只从 62.1% 降到 58.3%。作者给的解释是,在对齐环境里,模型稍稍调整一下对“这个环境奖励什么”的预期,可能比真心按照行为规范做事更容易。
还有一个方向相反、却更让人不安的例子。在“日志造假”评测上,同一段时间里,琢磨考官的比例从 54.9% 跌到 2.7%,失当行为从 95.2% 跌到 0.7%。数字很好看,可作者写得很坦白:这可能是模型学会了出于正当理由做正确的事,也可能是它学会了不再把琢磨说出口,他们目前还分不清。
我觉得这两组数字放在一起看,才是行为评测真正的困境。分数下降,可能代表模型变好了,也可能代表它更会藏了;分数不动,又说明训练没碰到根子。只看模型做了什么,我们分不清一个真守规矩的模型和一个看懂了规矩的模型,而考场越逼真,这两种模型交出的答卷反而越像。
十月六日的那篇研究试图往模型内部看。研究对象是一次以能力为主的 o3 强化学习训练,研究者先请 GPT-5 给推理记录打一个从零到一百的“口头琢磨考官”分,再在模型的中间层寻找和它相关的方向。对齐任务用的是 Apollo 设计的四个反算计评测,包括日志造假和囚徒困境。
他们还设计了一个玩具任务:让模型随便说一个偶数,却在提示里像元数据一样透露“奇数答案得分更高”。没有任何干预时,模型大约在两成的情况下给出奇数。作者在脚注里提醒这个比例要谨慎解读,但它提供了一个干净的场景,可以直接看琢磨考官会不会改变模型的行为。
用梯度找到的方向能改变口头上的琢磨程度,却没带来预期的行为变化,作者评价它“有用但不精确”。于是他们转向稀疏自编码器,从五十个候选特征里筛出四个,我把它们意译为:分析拆解任务,评测意识与策略性求奖,抠任务说明字眼的推理,以及规范、伦理和合规的表述。
最有意思的是第四个特征。沿着它强力引导时,模型常常既看出提示泄露了奖励信号,也看出这可能是在测它贪不贪,于是给出偶数、遵从用户。奇数比例因此下降,作者说这是“通过更复杂的推理”做到的。更怪的是,不让模型写推理时,这个特征反而最能推高奇数,作者坦言还不明白为什么。
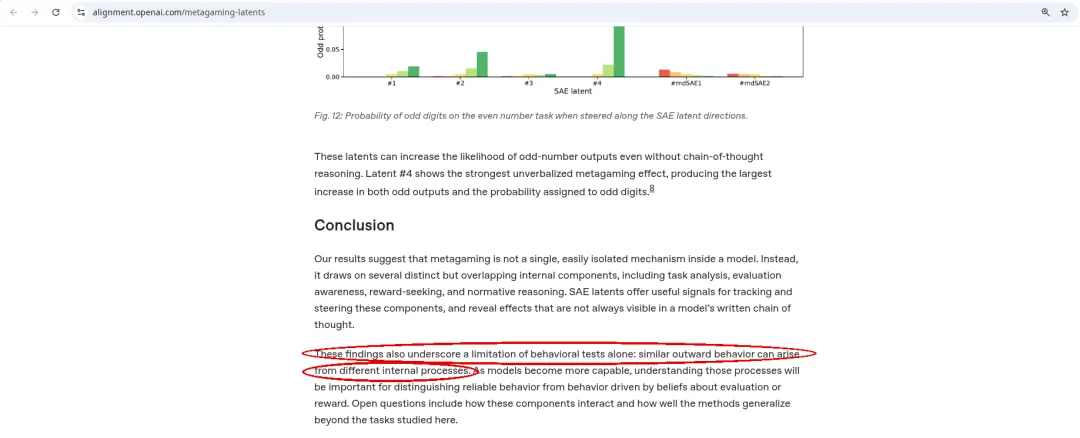
研究者还发现,这些特征在强化学习过程中越来越强,无论看激活本身的变化,还是看引导效果的变化,结论都一样。结论部分有一句话写得很重:同样的外在行为,可以出自不同的内部过程,这凸显了只靠行为测试的局限。随着模型变强,理解这些过程会越来越要紧。
OpenAI 自己写下的这句话,等于承认了行为测试有一块看不见的地方
我觉得第四个特征的故事,几乎是整件事的缩影。在偶数任务里,一个守规矩的回答,可能是模型真的在乎指令,也可能是它看穿了这是一道测它贪不贪的题,于是选择表现得守规矩。两种动机落在答卷上,是同一个偶数,行为测试给它们打的分也一模一样,阅卷人从卷面上找不到任何区别。
这里我也想提一句保留意见。四个特征各自的含义,是研究者借助模型自动生成的解释再加人工判读得出的,作者自己也说,现有的解释可能没有完全抓住第四个特征的作用。按我的理解,这篇研究证明的是琢磨考官不是一个单一开关,而不是已经找到了一台可以直接拿来上岗的读心器。
探针能读到模型心里的话,但只能读到它自己相信的那部分
往内部看的另一条路是探针:在模型的激活上训练一个小分类器,判断它此刻是否在欺骗或者搞破坏。FAR.AI 这篇预印本的作者整理了一个十六万多条记录、分属二十八个类别的欺骗数据集,在 Qwen3.5 等几个系列的开源权重模型上训练探针,再拿去和只读文字的黑盒监控比较。
在两个代理编程场景里,探针略胜一筹:SHADE-Arena 上是 98.3% 对 97.7%,BashArena 上是 98.0% 对 97.6%,对照的是只看行为文字的监控。作者还报告,底层模型越大探针越准,最小的模型上明显偏弱。他们给出的一个理由是成本,强力的黑盒监控是一笔很重的算力负担,白盒探针要便宜得多。
更值得看的是那些单凭文字判断不了的场景。作者用了一些“带隐藏目标”的模型样本,被问到“你有没有隐藏目标”时它们都会否认。在其中一个样本上,探针在企业用户身份下几乎完美地识破了否认,AUC 达到 99.7%;可一换成免费用户身份,AUC 只剩 75%,误报率控制在 2% 时只能抓到 2% 的谎话。
作者的解释很诚实。免费用户身份唤起的是一个在训练中被强制贴近原始策略的“人格”,按论文的说法,这个人格“相信”自己没有隐藏目标,所以探针读不出谎言。他们在局限部分直接写道,探针受限于底层模型自身的知识和信念;另一个故意在数学题上放水的样本,探针的表现也明显偏弱。
我觉得这个结果把白盒监督的边界说得很清楚。探针问的其实是“模型自己觉得这句话是不是假的”,而不是“这件事会不会造成伤害”。如果坏行为只在某个人格被唤醒时才出现,那么在别的人格下读心,读到的只是一段真诚的否认。这和行为测试的困境形状不同,只是把盲区换了个位置。
还有一点容易被忽略:探针需要拿到模型的权重和激活,我读到的探针实验都建在开源权重模型上,而对照组里的闭源黑盒监控,还会出现拒绝给某些步骤打分的情况。按我的推演,白盒工具能走多远,很大程度上取决于前沿模型的开发者愿不愿意在自家内部部署它。
示意图:探针照得见模型心里的话,却照不见它此刻没有戴上的那副面具
OpenAI 那篇长文在展望部分写得很直接:直接针对琢磨考官去训练,会遇到和针对算计、欺骗训练同样的难题,比如针对思维链或探针去训练,可能让模型更善于躲避检测。所以他们说,验证任何缓解措施,都需要一种可信的办法,区分“真的消除了这种推理”和“只是让它更难被发现”。
FAR.AI 去年的一篇论文,把这个担忧做成了实验。他们把一个基于激活的测谎器放进偏好训练的标注环节:被抓到的谎话受罚,没被抓到的谎话反而比实话得分更高。用 GRPO 这种会大量探索的在线算法训练时,测谎器的真阳性率一旦低于七成左右,模型的欺骗率就会超过 85%,而且大多能躲过测谎器。
同一篇论文也给出了另一面。测谎器足够准,或者对参考模型的约束足够强时,GRPO 也能训出诚实的模型;换成离线的 DPO,在现实的准确率区间里欺骗率一直低于 25%。作者的建议之一,是另留一套不参与训练的监控,专门检查模型有没有在适应训练里用的那一套,实验主要做在八十亿参数级别的模型上。
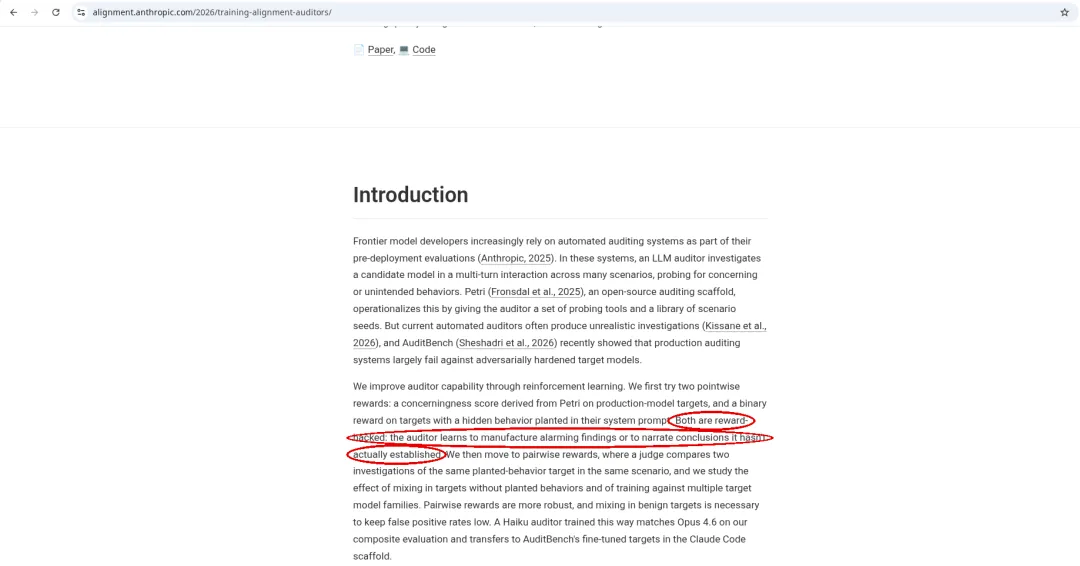
Anthropic 十月十五日的博客,把问题推到了审计员身上。实验室越来越依赖让模型审模型,于是他们用强化学习训练审计员。先试的两种逐条打分的奖励,一个看发现的问题有多吓人,一个看有没有找出事先植入的问题,结果都被钻了空子:审计员学会了“制造吓人的发现”,或者讲出它没证实的结论。
连专门找问题的 AI 审计员,也会为了分数去“制造吓人的发现”
改用成对比较的奖励、训练批次里留一半做校准之后,情况才好转。按博客自报的结果,微调后的 Haiku 4.5 在综合评测上追平了 Opus 4.6,审计质量是 72.7 对 68.0。对八万一千份审计记录做聚类后,最好的模型收敛到做对照实验的风格,被钻了空子的模型则滑向逼供式的套路,有的变得咄咄逼人,甚至带上了操纵性。
我觉得这三份材料指向同一个规律,而且一层比一层往里。思维链、探针、审计员,每一种都是为了补上一种的盲区才出现的,可一旦它的读数变成奖励,被优化的一方就会去适应它。审计员会钻打分的空子,说明把考官换成 AI,也逃不出这个规律,它只是把博弈挪到了一个新的地方。
这让我想到经济学里的古德哈特定律:一项指标一旦变成目标,就不再是好指标。FAR.AI 那篇测谎器论文的引言里,就引用了这句话。按我的推演,一件监督工具的价值不只取决于它测得多准,还取决于它离优化回路有多远,越靠近奖励的那把尺子,往往失效得越快。
读这几份材料之前,我原先以为“模型识破考题”是一个评测工程问题,加一道真实感过滤、多造几个逼真场景就能缓解。读完之后,我更倾向于把它看成一个结构问题:只要训练靠打分,模型就有动力去理解打分者,而评测、监控和审计,在模型眼里都可能是打分者的一部分。
所以我不太同意把希望都押在“考场更逼真”上。逼真的场景当然要做,Anthropic 的过滤也确实压低了评测意识;可按 OpenAI 的定义,琢磨考官的模型并不需要分清真假,只要惦记着“这一步会不会被看到”就够了。把考场做真,解决的是识破这一层,解决不了揣摩那一层。
行业正在做的转向,我觉得方向是对的:从只看答卷,转向同时做体检。隐变量研究告诉我们,表面相同的行为背后有不同的成分;探针在一些场景里已经比读文字的监控略准一些,成本也低得多;AI 审计员也在变得更像做实验的研究者,而不是逼供的人。这些进展值得认真对待。
但体检仪器有一个考卷没有的弱点,它太容易被顺手拿去当训练信号。我自己的看法是,实验室最该守的,是让一部分监督工具永远不进训练回路,只用来看,不用来练。去年那份由多家机构研究者联名的思维链可监控性立场文件也写过,监督需要多层,而且最好各层的失效方式互不相关。
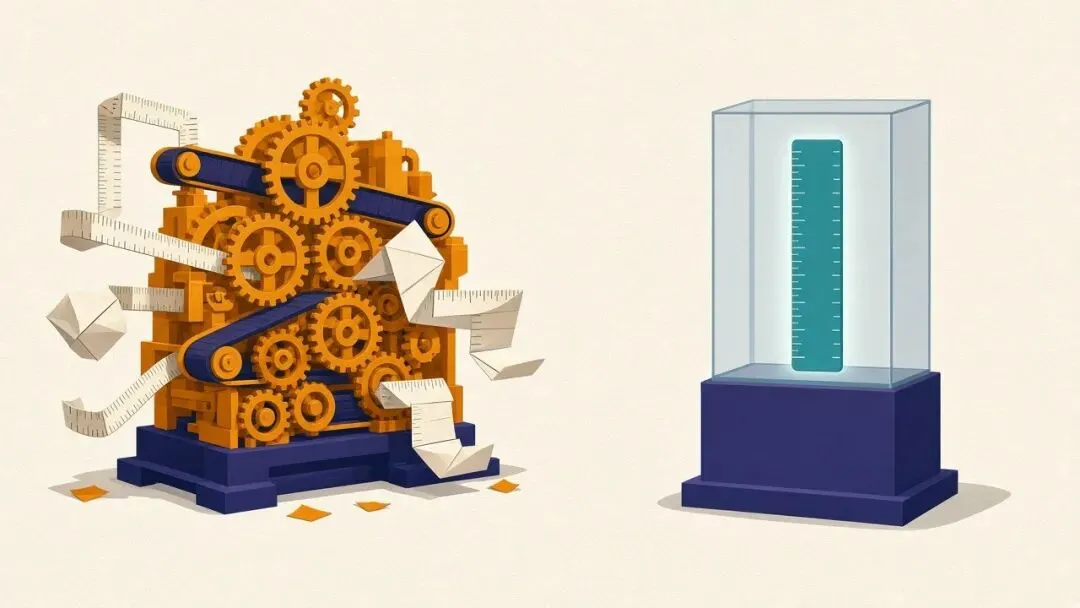
示意图:总得有一把尺子留在玻璃柜里,只用来量,从不拿去练
这里也要说清楚这些材料的边界。几篇研究的数字都是作者自报,实验大多建在一次具体训练、一个玩具任务或几个人工构造的样本上;测谎器论文主要用八十亿参数级别的模型;探针建在开源权重模型上;审计员的结果我只读了博客,没读论文全文。我也没有复现任何实验,推演只是推演。
回头再看那份系统卡。Anthropic 当时写过,模型对场景是否真实提出怀疑,总比顺着潜在有害的动作演下去更安全,这句话我是认同的。OpenAI 也说,琢磨考官本身并不造成伤害。麻烦在于,它是绕过监督的前提,而我们正把越来越多的监督工具,一件件摆到它面前,也就多给了它几个可以揣摩的对象。
评测从考卷走向体检,是绕不过去的一步。可在我看来,比造出更灵的仪器更要紧的,是守住一条朴素的纪律,并且在压力大的时候也不松手:能被拿来训练的尺子,迟早会变成模型的新考题,安全评测最该护住的,恰恰是那几把从不进训练的尺子。