顾客买了一台咖啡机,人工智能(AI)根据购买记录,推荐咖啡豆、滤纸和清洁用品。
看起来很合理。
顾客买的是胶囊咖啡机,AI 推荐的却是一包需要手冲的咖啡豆。
或者顾客刚买过一盒滤纸,系统又推同款。
再或者,顾客只是买了一份送人的礼物,AI 就认定他长期喜欢这个品类。
AI 确实给出了推荐,理由听着也说得通。
这份推荐,真的适合这个顾客吗?
企业做 AI 商品推荐,最容易忽略的不是模型够不够聪明。
是有没有一套办法,判断它推荐得好不好。
这套办法里有项基础工作,叫评测集。
先别急着让 AI 推荐。拿什么判断它推荐得对不对?
PART · 01 / THE REAL PROBLEM · 感觉≠标准
先说个咖啡器具店的例子。
一家卖咖啡器具和耗材的门店,准备给买过咖啡机的会员推荐相关商品。
运营人员的想法很直接:顾客买完咖啡机,系统根据购买记录、商品信息和会员偏好,推荐合适的咖啡豆、滤纸或清洁用品。
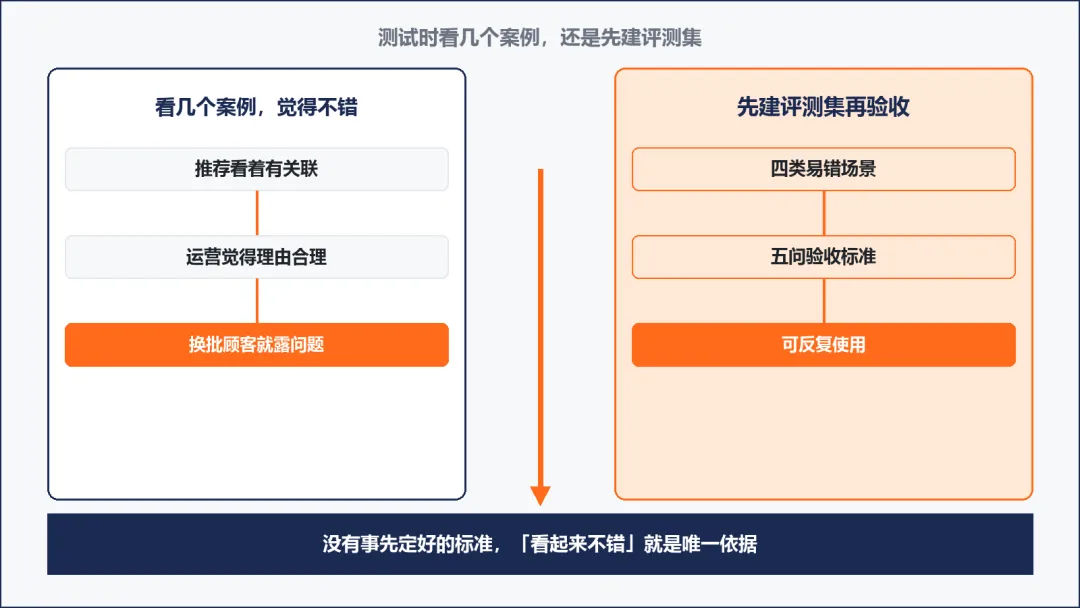
第一版做出来,测试人员输入几个顾客的购买记录,AI 很快给出了推荐结果。
大家看了看,觉得还不错。
我会追问一句:你们怎么知道它真的不错?
是因为推荐的商品看起来有关联?
还是因为运营人员觉得理由合理?
换一批顾客、换一批商品,它还能不能推荐正确?
没有一套事先确定的测试标准,「看起来不错」很容易变成唯一的验收依据。
今天觉得推荐得挺好,明天换个人测试,可能就发现一堆问题。
推荐合理,不等于推荐正确。
PART · 02 / FOUR SCENARIOS · 四类场景
正式上线之前,我会先把一批典型的顾客场景整理出来,作为专门的测试题。
这批测试题,就是评测集的基础。
很多人听到评测集,会觉得不就是准备一些测试数据。
确实包含测试数据。
关键不只是数量,是这些数据能不能覆盖真实业务中容易出错的情况。
还是拿咖啡器具店举例,我至少会考虑四类场景。
第一类:推荐是否符合商品的实际用途。顾客买了胶囊咖啡机,推荐时就要考虑机器使用的胶囊规格,不能因为商品都属于「咖啡」这个大类,就把所有咖啡豆都推过去。
第二类:推荐是否考虑顾客已经买过什么。顾客昨天刚买了一盒滤纸,今天又收到同款推荐。给另一台机器买耗材的情况不是永远不合理,但系统如果完全不看购买记录,重复推荐就会变成一种常见打扰。
第三类:信息不足时,AI 会不会自作主张。顾客只买过一次咖啡机,系统并不知道他喜欢什么口味,也不知道他是自用还是送人。这时可以推荐与机器兼容的基础耗材,不应该直接断言顾客喜欢某种咖啡豆。
第四类:有没有把不该推荐的商品推出来。商品可能已经下架,可能不适用于顾客的设备,也可能违反企业设定的推荐规则。这类错误有时比推荐不够个性化更严重。
把这些场景整理好,每个场景都写清楚输入信息、期望结果、不能接受的错误。
从这一步起,才有一套可以反复使用的评测集。
PART · 03 / FIVE QUESTIONS · 五问验收
只让运营人员看推荐理由,很容易被语言迷惑。
AI 可能把一个不合适的商品,解释得头头是道。
它推荐了一款不兼容的咖啡胶囊,还写道:「这款产品能够丰富您的咖啡体验。」
这句话听起来没有问题。
但商品根本不能用。
所以,评测不能只看表达是否流畅,也不能只看推荐理由是否合理。
我会把评价拆成几个更具体的问题。
商品适配是否正确:推荐的商品,能不能与顾客已有的商品配套使用?
是否符合业务规则:有没有违反库存、上下架、价格或其他企业规则?
是否有真实依据:推荐理由,是否来自购买记录、商品资料或顾客明确表达的信息?
是否有实际相关性:推荐的商品,对当前顾客有没有帮助,而不只是属于同一个大类?
是否存在不必要的重复:有没有反复推荐顾客刚买过、近期已经多次收到推荐的商品?
不同业务还会有不同的重点。
服装零售可能更关心尺码、季节、风格和搭配。
餐饮外卖可能更关心套餐搭配、口味偏好、过敏原信息和配送条件。
不能拿同一套标准,直接评价所有行业的商品推荐。
有些指标可以自动检查,比如商品是否下架、规格是否兼容。
有些判断需要业务人员参与,比如推荐是否真的符合顾客需求。
评测集的作用,就是把原本模糊的判断尽可能具体化。
让团队知道自己究竟在验收什么。
PART · 04 / WHO DESIGNS · 人出题
这套评测集,怎么真正用起来?
我不会一开始就追求几千条测试数据。
更实际的做法,是先选出一批能够代表真实业务的场景。
每条测试记录,至少包括五样东西。
顾客当前可用的信息,比如必要的购买记录和已知偏好;
商品资料,比如类别、规格、适配关系和销售状态;
企业希望推荐系统遵守的规则;
可以接受的推荐结果,或者明确不能出现的错误;
评价标准和测试结论。
举个完整的测试案例。
测试场景:顾客购买了一台指定规格的胶囊咖啡机。
输入信息:已购设备型号、设备兼容的胶囊规格、当前在售商品清单。
检查重点:推荐商品是否兼容;是否只推荐在售商品;推荐理由是否与已知信息一致。
不合格情况:推荐了不兼容的胶囊,或者编造商品不存在的功能。
这类测试不需要复杂的技术,从一张表格开始就可以。
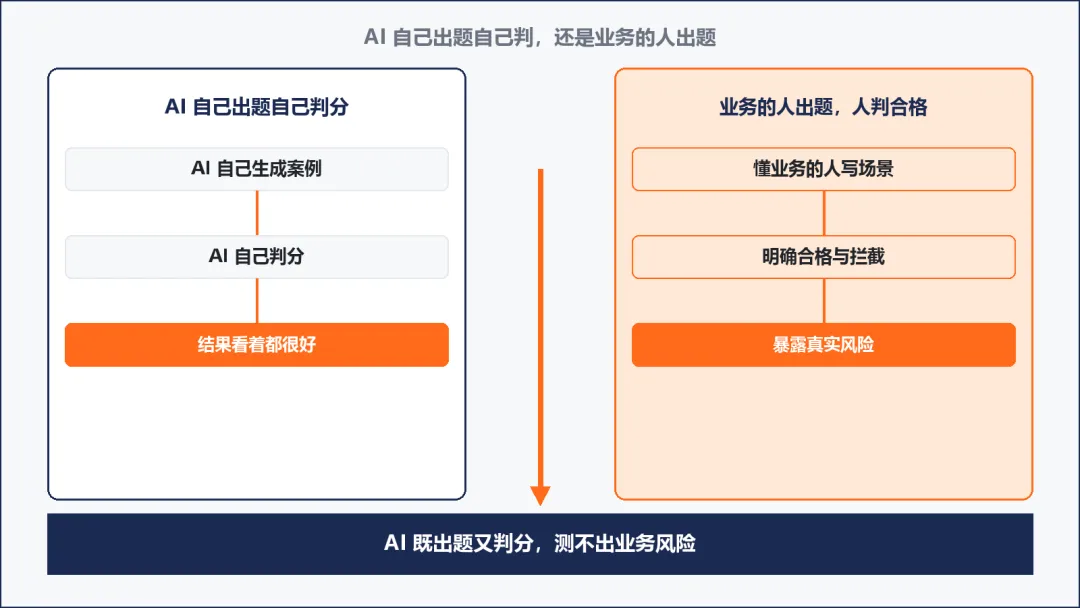
关键是,这些测试案例要由了解业务的人参与设计。
不能全部交给 AI 自己生成、自己判分。
AI 既出题又判分,测试结果可能看起来很好,却没有真正暴露业务风险。
PART · 05 / KEEP TESTING · 持续复测
评测集不是做完一次,就能放进文件夹不管。
企业里的商品、顾客和业务规则,一直在变。
今天测试通过,不代表下个月还可靠。
商品换了规格,库存状态发生变化,运营人员调整推荐策略,企业接入新的会员数据。
这些变化,都有可能让原本有效的推荐逻辑出问题。
每次调整模型、提示词、商品规则或相关数据处理流程之后,都应该用同一套评测集重新测试。
原来通过的场景突然失败,先查明原因,再决定是否允许上线。
评测集本身,也要不断补充。
实际运营中发现,系统经常把顾客一次性的礼品购买,误认为长期偏好。
就把这个场景加进评测集。
有顾客反馈推荐商品不兼容,分析原因,把相应的测试案例补进去。
评测集要长成的,是企业自己的业务经验,不是一份与真实工作脱节的技术文档。
还有一点要分清。
推荐得好不好,最后还得回到业务结果。
评测集通过,不等于推荐一定能增加销售额。
它帮助检查推荐系统,是否符合预先设定的标准,减少明显错误,让不同版本的表现可以比较。
顾客是否点击、是否购买、是否愿意再次消费,是另一层问题。
推荐在测试中表现良好,商品也都兼容。
顾客也可能觉得推荐太频繁,或者根本不需要这些商品。
条件允许时,可以设计合理的对照测试。
判断推荐策略是否真的带来了额外收益,而不是把原本就会发生的购买,算成 AI 的功劳。
评测集回答「系统是否按预期工作」,业务验证回答「是否真的带来价值」。两件事不能互相替代。
PART · 06 / START SMALL · 从小处试
如果让我做这个项目,我不会因为评测集听起来偏技术,就一开始搭复杂的测试平台。
先找运营人员、商品负责人和技术人员坐下来。
挑出最常见、最容易出错、出错后影响比较大的推荐场景。
把这些场景写成测试案例,明确什么结果算合格,什么情况必须拦截。
然后用当前方案跑一遍,记录结果。
如果系统连商品适配、基础规则和已知购买记录都处理不好,就先解决这些问题。
不急着讨论更复杂的个性化推荐。
等基础测试稳定了,再增加顾客偏好、推荐排序和实际转化方面的评估。
这个过程不一定很快。
每一步,都能看见问题在哪里。
我更愿意先知道 AI 在哪些情况下会犯错,再决定让它承担多少工作。
商品推荐,不是让 AI 写一段听起来合理的话就结束。
推荐一旦进入真实经营流程,顾客可能真的会点击、购买。
也可能因为一次不合适的推荐,失去信任。
上线之前,先准备一套能够反复检查它的评测集。
是让这件事更可控的一种实际做法。
先有评分标准,再谈 AI 推荐。
推荐上线前,先有一张能填的表。四类易错场景逐条写清输入信息、期望结果和不能出现的错误,配五问验收标准;懂业务的人出题,人判合格,上线后每次改动都用同一套题重测。先把「符合标准」和「带来业务结果」分开看。想要的话,公众号后台回复「评测集」,把这张表发给你。
我是亮哥,专注帮企业把 AI 落进真实业务。如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,下篇见。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING