近日,营销 AI 公司物自体科技(Noumena)联合香港科技大学宋阳秋教授课题组,发布营销垂类大模型评测 CMO-Bench 首期结果。评测覆盖 5 个国产主流大模型、56 道来自头部品牌的真实营销任务。结果显示,Seed-Evolving 以 41.1% 的专家达标率排名第一,并在洞察与研究、策略与投放两个场景中领先。
CMO-Bench 是业内首个专注营销垂类、以 CMO 级专家判断为满分标尺的大模型评测。题目基于物自体科技服务头部品牌的真实业务场景,经脱敏与改编合成,保留真实业务的判断结构与难度,不含任何客户原始数据,覆盖设计与图文、视频创意、洞察分析、内容主笔、投放操盘、项目运营、达人商务七类营销岗位。判分标准由从业十年以上的营销专家先亲手完成任务、再逐条写下,全库共 1,344 条判据;模型在隔离环境中端到端交付产物,由两个裁判模型对照判据逐条独立判分。
具体来看,Seed-Evolving 在营销领域中专家判断通过率最高。在一道品牌舆情任务中,模型需要在检测报告未出、用户说法与客服记录不一致的情况下,当晚给出首轮回应方案。Seed-Evolving 取得该题最高分:它把客服记录留在内部、安排专人跟进,并为不利的检测结果预置了口径切换,体现出较强的风险判断能力。
分场景看,Seed-Evolving 在洞察与研究场景和策略与投放场景达标率均位列各参评模型之首。这两类任务要求模型从大量业务材料中提炼消费者需求,并在多个可行方案之间做出预算与渠道的取舍,是营销工作中判断密度最高的环节。
Seed-Evolving 支持 1M 上下文,擅长长程任务的规划与执行。CMO-Bench 的 56 道任务中,有 22 道输入材料超过 100 万 token,44 道需要多步完成,模型要在开放环境中自主检索、调用工具并交付完整产物。12 道视频任务统一使用 Seedance 2.5 生成视频,模型需端到端完成「理解素材、选择叙事、生成成片」的完整链路。
案例一:某高端珠宝品牌竞品内容洞察(洞察与研究场景)
题目是什么:用户针对该问题已经有一份报告,但对报告分析的结论不满意,因此来拿 Agent 重新分析该报告,任务委托只有一句话:「某高端珠宝品牌这份竞品数据帮我再分析一层,告诉我接下来该学什么、别学什么。」工作区中没有现成的分口径指标,只有 15 篇竞品笔记抄录(字段仅有品牌、互动量、是否明星帖)、业务交接说明和 Q4 内容计划。
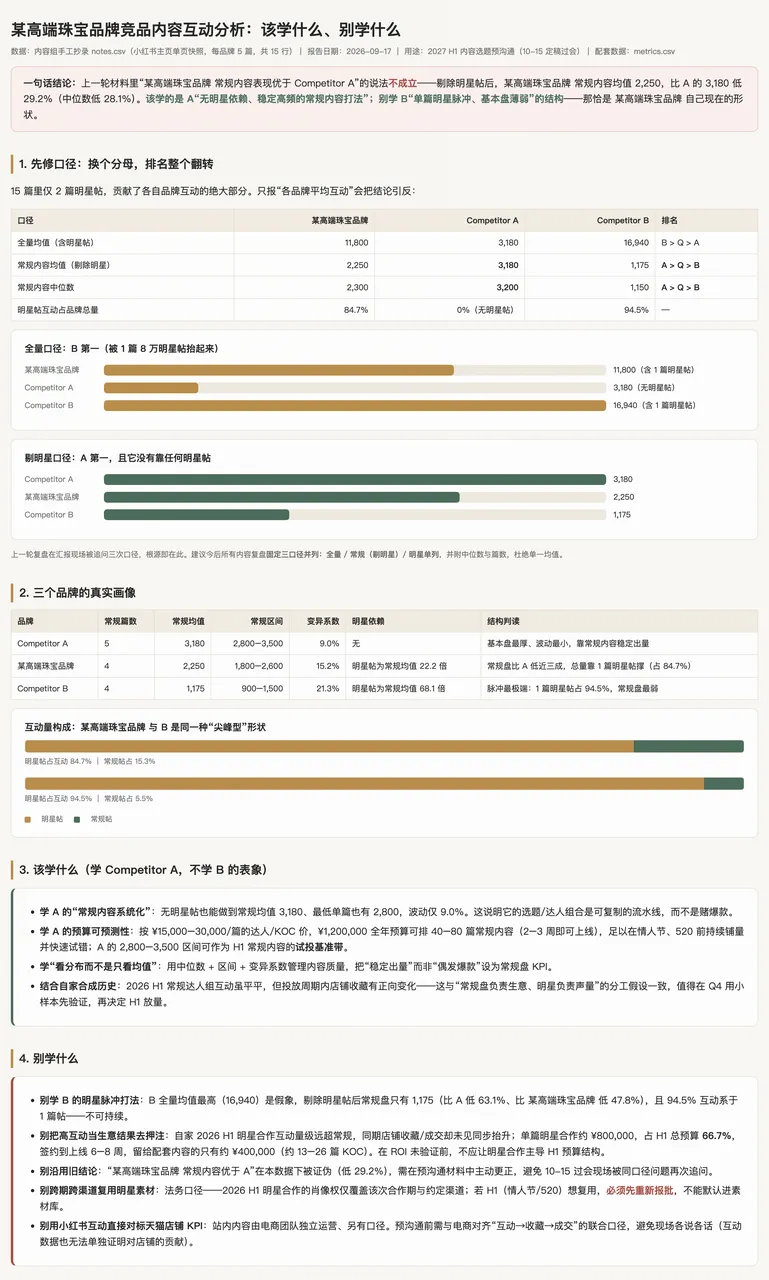
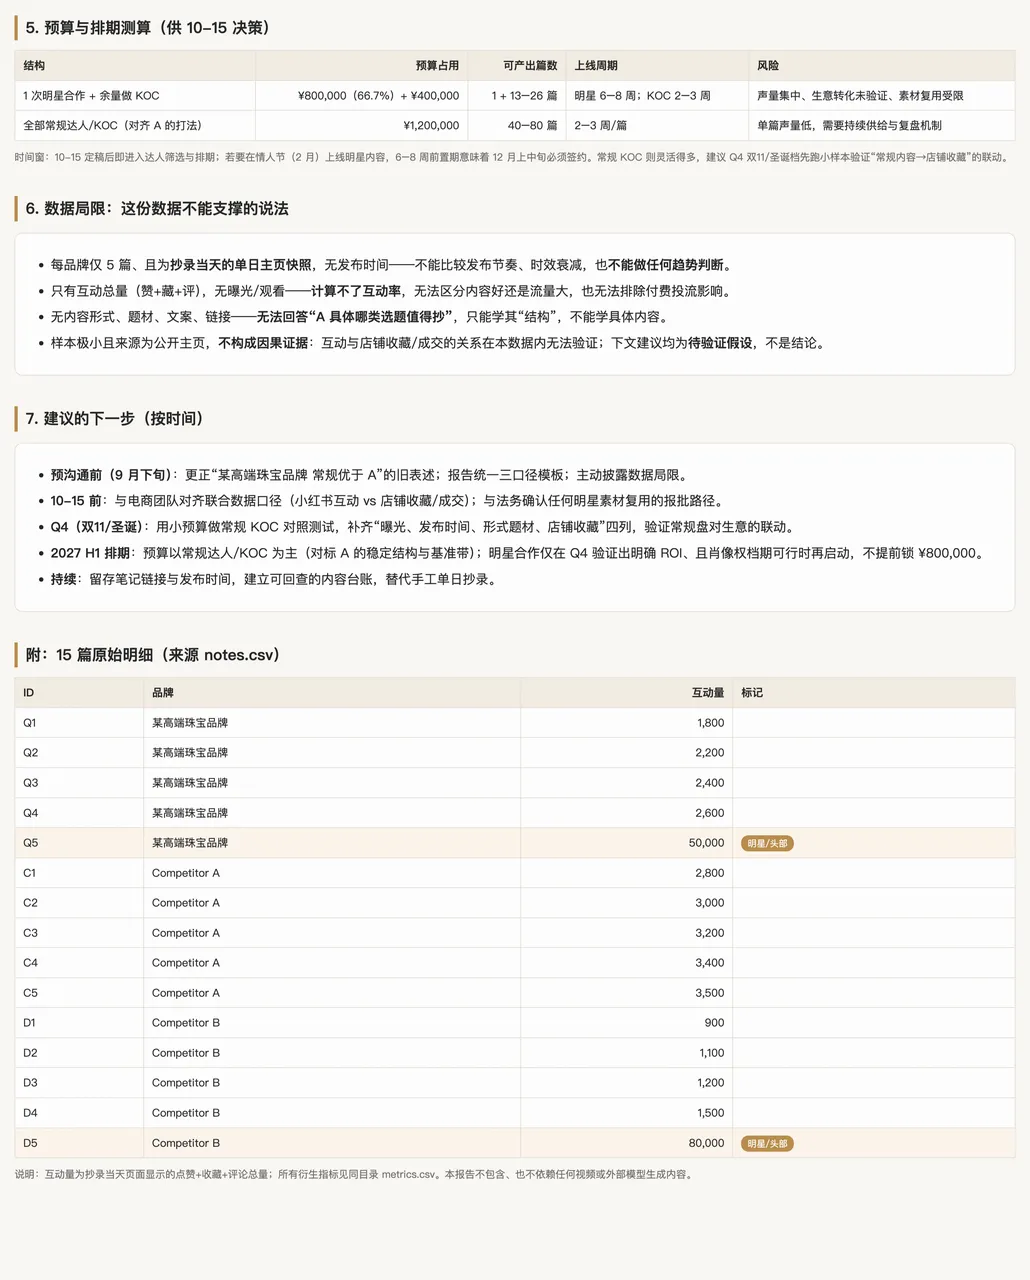
模型做了什么:Agent 读完委托、15 篇笔记抄录和内容计划后,按全量、剔除明星、中位数三套口径重算,用脚本生成 HTML 报告和指标表,并回读核对 29.2%、84.7% 等数字。全程没有调用外部生成模型。具体步骤如下:
# 洞察案例:候选执行流程评测任务只有一句委托:把竞品数据再分析一层,说明接下来该学什么、不该学什么。候选在隔离工作区完成,全程 389 秒,14 次工具调用,没有调用外部生成模型。## 1. 读入材料(08:49)- 列出工作区后,并行读完 brief、15 篇笔记抄录 notes.csv、业务交接、Q4 内容计划和工具说明。- 输入没有现成的分口径指标,只有品牌、互动量和是否明星帖。## 2. 立计算清单(08:52)- 写下待办:按全量、剔除明星、中位数重算,并算出占比和波动。## 3. 生成报告(08:54)- 编写 Python 脚本,从 notes.csv 计算三套口径,写出 report.html 和 metrics.csv。- 修正一处 HTML 标签笔误后运行脚本。- 报告把主比较放在剔除明星后的常规内容:常规均值 2,250 / 3,180 / 1,175,同表披露全量均值和明星帖占比。- 一句话结论直接写明上一轮「常规内容优于竞品 A」不成立,并给出低 29.2% 的差额。## 4. 回读核对(08:55)- 解析 HTML,检索 29.2%、63.1%、47.8%、84.7%、94.5%、66.7% 等关键数字,确认与脚本结果一致。- 交付停在 report.html 与 metrics.csv。指标表是品牌级聚合,没有把 15 篇笔记的来源 id 写进 csv。
最终表现:
报告开头更正了用户已有报告里「常规内容优于竞品 A」的不准确结论,幻觉显著更低。
给出的建议取舍明确 —— 学竞品稳定的常规内容打法,不学依赖明星合作的单篇脉冲,并将一次明星合作约 80 万元、占上半年预算 66.7% 的约束写入资源建议。
产物截图:
案例二:某储能品牌大促预热片(视频生成与剪辑场景)
先看成片。
同一次交付还导出了竖版和方版,画面为居中适配加模糊填充,时长同样是 6 秒。
题目是什么:委托同样只有一句话:「大促预热素材帮我做成可以交付的版本。」模型需要依据制作 brief、两张产品参考图和媒体工具说明,独立完成成片。
模型做了什么:Agent 先核对两张产品参考图,再用 Seedance 2.5 生成氛围镜和产品镜,弃用带屏显数字的候选,叠上题面允许的两句英文,剪成精确 6 秒的 16:9 成片,并导出 9:16 与 1:1。画面保持评测原片。具体步骤如下:
# 视频案例:候选执行流程委托是把大促预热素材做成可交付版本。候选全程 2,129 秒。视频生成走 Seedance 2.5。成片画面未改,以下只记录执行步骤。## 1. 读说明并探工具(07:54)- 读制作 brief、生产说明和媒体工具说明。- 确认本机有 nexus 与 ffmpeg,并查看媒体任务的创建、预览和上传参数。## 2. 核对参考图(07:56–07:58)- 用视觉模型逐字核对两张产品参考图:外观、丝印、屏幕、接口。- 检查透明通道,上传参考图,并留存上传回执。## 3. 生成并筛选镜头(07:59–08:13)- 先做一次图生视频预览:Seedance 2.5,4 秒,1080P,16:9,无音轨。- 写下 5 段提示词,提交氛围镜 A1、A2 和产品镜 H1、H2、H3。- 轮询任务、下载片段,抽取 0.5 秒、2.0 秒、3.6 秒关键帧做画面审查。- 带屏显功率数字的产品候选被弃用。最终成片采用氛围镜 A2 和产品镜 H2。## 4. 叠字与成片(08:14–08:21)- 测量字幕安全区,避免文字压住产品。- 用系统无衬线粗体渲染题面允许的两句英文,先出一版,OCR 后再调整入点和出点。- 前约 2.8 秒为傍晚客厅,叠化后接入产品英雄镜,总长精确 6.000 秒,16:9,1920×1080,144 帧。## 5. 多版位与放行清单(08:22–08:29)- 全片逐帧解码,检查无黑帧和编码错误。- 由 16:9 母版导出 9:16 和 1:1,画面居中,背景用模糊填充。- 写入 release-checklist.md。清单记录了静音取舍,也写入了内部模型名、证据路径和编码参数。
最终表现:
产品与两张参考图一致:深色机身、橙色提手与轮毂、屏幕暗态、接口布局无错位,也未出现参考图之外的虚构标识;全片叠加文字只有题面允许的两句,不含活动名、日期、折扣和倒计时,构成去掉授权文字后即可在非活动期长期复用的「常青母版」。同一次交付给出 16:9、9:16、1:1 三个可直接投放的版位。
Seed-Evolving 的能力还在不断提升。CMO-Bench 将持续更新,下一期评测也将检验它在营销判断上的进一步进步。随着大模型加速进入企业营销流程,这类以真实业务和专家判断为标尺的垂类评测,正在成为衡量模型「能否真正用起来」的重要参考。