列存数据库怎么选:ClickHouse、Doris、StarRocks、Greenplum 的真实差距
很多团队第一次被"列式存储"震撼,都来自一个具体的瞬间:一张几亿行的订单明细表,在 MySQL 里跑一条"过去 30 天各城市成交金额 Top10"的 GROUP BY,几分钟过去还在转圈,连接被超时杀掉;同样的数据导进 ClickHouse,几百毫秒出结果。
SQL 没写错,索引也没少建。真正的差距在更底层——数据在磁盘上是怎么摆放的。
这几年,ClickHouse、Apache Doris、StarRocks、Greenplum 这些名字在技术选型里出现的频率越来越高,外面还有 Snowflake、BigQuery 一类云数仓。它们都叫"列式数据库",但架构取舍、擅长场景和维护成本差别非常大。
这篇文章只讲四件事:列存为什么快、它不擅长什么、四款热门产品各自的真实取舍、一套能落地的选型框架。
01 列存快的根本原因:少读数据、读得紧凑、算得批量
一个常见误解是:列存快,是因为用了什么神奇的索引。其实列存的性能来自存储层和计算层的一整套配合,核心是三个机制。
机制一:列裁剪,只读需要的列
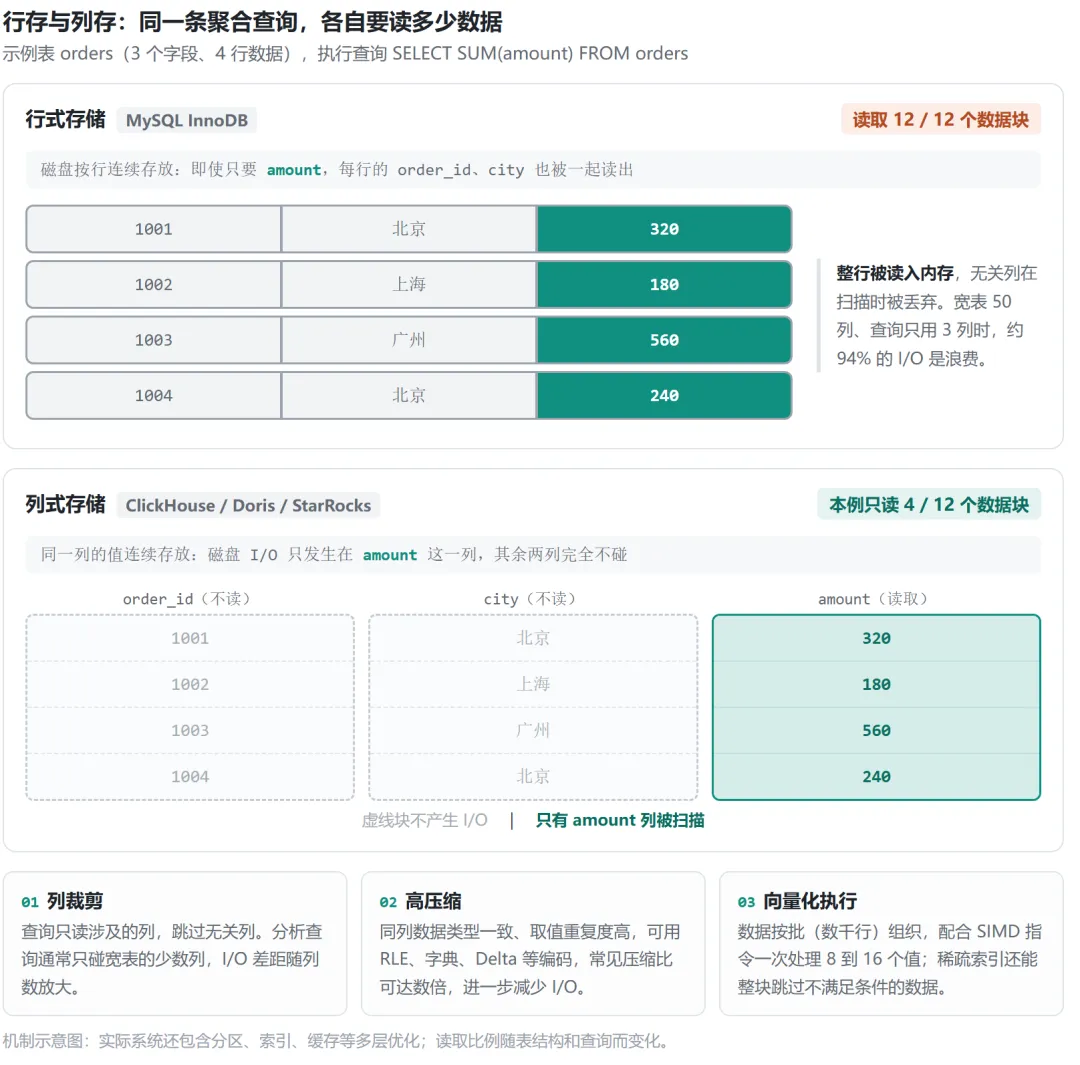
分析查询有个鲜明特征:表很宽,几十上百列,但每条查询只碰其中几列。行存数据库按行把数据连续存放,要读 amount 列就得把整行读进内存;列存把同一列的数据连续存放,查询只读涉及的列。50 列的宽表、聚合只用 3 列,行存大约 94% 的磁盘 I/O 是无效搬运。
机制二:同列数据类型一致,压缩率极高
连续存储的第二个红利是压缩。同一列的数据类型完全相同:订单状态只有几种取值,时间戳单调递增,相邻数值相差很小。这些数据能被行程长度编码(RLE)、字典编码、Delta 编码等方式大幅压缩,再叠加 ZSTD。压缩省下的不只是磁盘,更是 I/O 和内存带宽——在扫描几十亿行时,这一点是决定性的。
机制三:向量化执行,一批一批地算
传统行存引擎逐行调用计算函数,函数调用开销甚至超过计算本身。列存把数据组织成几千行的批次,配合 CPU 的 SIMD 指令(单指令多数据),一条指令就能同时处理 8 到 16 个值。再加上稀疏主键索引和数据块的 min/max 标记,不满足过滤条件的块可以整块跳过,连读都不用读。
这三个机制环环相扣:列裁剪让读取量变小,压缩让读取更便宜,向量化让计算更密集。它们必须从存储层到计算层全面支持,不是在行存数据库上加个开关就能获得的。
同一条 SUM(amount),行存要把整行数据页搬进内存,列存只扫描一列。这就是几百倍差距的来源。
02 列存的三个天生短板:它不是来替代 MySQL 的
列存在分析场景的优势是结构性的,但同样的结构,在另一类场景里就变成劣势。
第一,单行点查慢。按主键查一条完整订单,需要到多个列里分别取值再拼回一行,远不如行存的 B+ 树一次定位。
第二,写入和更新偏爱批量。列存文件按块组织,高频单行小写入会制造大量碎片,主流列存都要求或建议批次写入;对已有行的原地修改代价更高,早期方案普遍依赖后台异步合并。
第三,事务能力弱。高频单行增删改、行锁、强一致的交易流程,是 OLTP 数据库的主场,不是列存的设计目标。
所以业界多年形成的共识是分工而不是替代:MySQL、PostgreSQL 负责交易(OLTP),列存负责分析(OLAP),中间通过 Binlog/CDC 或日志管道把数据同步过去。理解这条边界,比记住任何一个产品名都重要。
03 四款热门产品,逐一拆给你看
四款产品都列存、都向量化,真正的差别在控制面:查询优化器谁来做、更新怎么处理、并发怎么扛、集群有多少种角色。
ClickHouse:单表扫描性能的极致
出身:俄罗斯 Yandex 为自家网站分析服务 Yandex.Metrica 研发,2016 年开源,Apache 2.0 协议。
架构:集群由对等节点组成,核心是 MergeTree 表引擎。每次写入生成一个不可变数据块,排序键同时充当稀疏主键索引(默认每 8192 行一个索引项),所以万亿行的索引也能放进内存。
强项:单张大宽表的扫描、过滤、聚合是标杆级的;编码丰富,DoubleDelta 适合单调时间戳、Gorilla 适合缓变浮点,时序数据压缩极狠;一个二进制就能跑,三节点的小集群一个人就能维护。
短板:多表 JOIN 长期依赖人工宽表建模、字典表和手动选择 JOIN 算法;更新依赖 ReplacingMergeTree,后台合并前可能读到重复版本,查询加 FINAL 又有额外开销;高并发要靠物化视图、预聚合和资源配额自己设计。
最新进展:2026 年 9 月发布的 26.8 LTS 加入了实验性成本优化器(Cascades)和新的 JOIN 算法,短板在补,但官方仍标注为实验阶段。
一句话:追加为主的事件流、日志、时序数据,扫描与汇总场景的首选。
Apache Doris:易用、高并发的实时数仓
出身:最早是百度内部的 Palo 项目(2008 年前后起步),服务广告报表;2017 年开源,2018 年捐给 Apache,2022 年 6 月毕业成为 Apache 顶级项目。
架构:FE(前端节点,负责 SQL 解析、元数据和优化器,Raft 多副本)加 BE(后端节点,负责存储与计算)的 MPP 架构,兼容 MySQL 协议,标准 SQL 直接可用。
强项:成本优化器(CBO)自动在广播、Shuffle、Colocate 之间选择 JOIN 策略,多表关联不依赖提前打宽表;主键模型采用 Merge-on-Write,支持实时 UPSERT 且读性能稳定;高并发点查和亚秒级报表是传统强项;部署运维相对简单。
新能力:4.x 版本把边界扩到向量检索、BM25 全文检索、AI 函数和 Iceberg v3 湖仓读写,不再只是一个 OLAP 引擎。
一句话:要实时更新、要高并发对外服务、要 MySQL 生态无缝对接,选它最省心。
StarRocks:为多表 JOIN 和高并发 BI 重写
出身:2020 年从 Doris 代码分支独立发展(原名 DorisDB),随后重写查询引擎,现在是 Linux Foundation 旗下项目,Apache 2.0 协议。
架构:同样是 FE/BE 的 MPP,但执行层自研了 Pipeline 调度模型——把查询拆成细粒度算子跨核调度,高并发下尾延迟更稳;配合查询缓存复用聚合结果。
强项:星型、雪花模型下的复杂多表 JOIN 是招牌;面向用户的高并发 BI 看板;对 Iceberg、Hudi、Delta 等数据湖的查询加速成熟;4.1 版本加入 tablet 自动分裂,缓解多租户数据倾斜。
参考数据:官方 SSB 基准测试中,StarRocks 整体查询性能约为 ClickHouse 的 1.87 倍。但这是厂商自测、以单表宽表为主的结果,只能作为参考,后面会专门讲怎么看待这类数字。
一句话:复杂报表、多表 JOIN、湖仓一体加速、SaaS 多租户场景,优先看它。
Greenplum:传统企业数仓的老牌选手
出身:基于 PostgreSQL 的开源 MPP 数据库,采用 Master 加 Segment 架构,发展近二十年,是传统企业数仓的代表。
强项:完整继承 PostgreSQL 生态,SQL 支持最规范(窗口函数、复杂查询、各类扩展),事务成熟,在金融、电信、政企有大量存量系统和成熟方法论。
短板:为批量加载时代设计,没有原生 UPSERT,修改数据要 delete 加 insert;新增 Segment 节点需要全量重分布数据,耗时可达数小时;VACUUM、表膨胀治理需要专职 DBA;高并发和实时性明显落后于新世代引擎。
一句话:T+1 批处理、固定报表、已有 PostgreSQL 生态和稳定 DBA 团队的传统数仓,它依然可靠;实时分析不是它的舞台。
另一组选择:全托管云数仓
如果不想自己维护集群,Snowflake、Google BigQuery、Amazon Redshift 代表另一条路线:存算分离、弹性扩缩、按用量付费,几乎零运维。
公开基准 ClickBench(由 ClickHouse 官方维护,需要注意其立场)2026 年的结果显示:BigQuery 在无服务器形态下查询中位数为 544ms、零失败、压缩后数据体积全场最小(8.16 GiB);10 亿行规模的成本对比中,ClickHouse Cloud 跑完约 23 秒、花费约 0.67 美元,Snowflake Large 约 127 秒、0.85 美元。云数仓在极限延迟和单位成本上通常不占优,但换来免运维和弹性,适合团队小、数据在云上、希望快速上线的组织。
04 横向对比:一张表看清差异
维度 | ClickHouse | Apache Doris | StarRocks | Greenplum |
|---|
出身与协议 | Yandex,2016 年开源,Apache 2.0 | 百度 Palo,2022 年 Apache 顶级项目 | 2020 年 Doris 分叉,Linux Foundation 旗下 | PostgreSQL 系 MPP,约二十年历史 |
架构 | 对等节点 + MergeTree | FE/BE MPP | FE/BE MPP + Pipeline 执行 | Master/Segment MPP |
SQL 与接口 | 类 SQL,自有方言较多 | MySQL 协议,标准 SQL | MySQL 协议,标准 SQL | PostgreSQL 方言,SQL 最完整 |
单表扫描聚合 | 极强,业界标杆 | 强 | 强 | 中等 |
多表 JOIN | 历史短板,26.8 实验性优化器 | 强,CBO 自动选路 | 最强档,复杂报表招牌 | 强,SQL 能力完整 |
实时更新 | 弱,靠异步合并 | 强,主键模型 Merge-on-Write | 强,主键模型 | 弱,批量 delete 加 insert |
高并发 | 需配合物化视图建模 | 强 | 强,尾延迟稳定 | 较弱,大查询易互相影响 |
运维成本 | 低,角色少但调优靠人 | 低 | 中低 | 高,需要专职 DBA |
弹性扩容 | 加分片,分片键需提前规划 | 弹性较好,支持存算分离 | 弹性好,tablet 自动分裂 | 重分布数据,可达数小时 |
湖仓与扩展 | 支持外表查询 | Iceberg v3、向量、全文检索 | 湖仓加速是招牌 | 较弱 |
典型场景 | 日志时序、事件流、极致扫描 | 实时数仓、高并发报表、更新场景 | 多表 BI、湖仓加速、多租户 | 批量企业数仓、PG 生态 |
对比表只能给方向,同一格里"强"与"强"的差距,最终要靠你自己的查询集来度量。
05 选型时最容易踩的三个坑
误区一:拿一张 benchmark 榜单当结论。ClickBench 由 ClickHouse 维护,各家对比页上的数字也都由厂商自己跑,测试集、硬件、调优水平各不相同。而且榜单大多是单表场景:Doris 官方称完整通过 TPC-DS 全部查询、ClickHouse 约一半查询无法通过——这不是谁全面碾压谁,而是说明单表扫描和多表 JOIN 本就是两种考题。更稳妥的做法是:导出你自己最慢的 20 条 SQL,用真实数据量和真实并发做 PoC。
误区二:纠结 Doris 和 StarRocks 谁是"正统"。两者确实同源,StarRocks 2020 年从 Doris 分叉,但此后独立演进多年,查询引擎和优化器早已是两套实现;Doris 是 Apache 顶级项目,StarRocks 在 Linux Foundation 旗下,都是 Apache 2.0 开源协议。按工作负载选即可,不存在"分支""山寨"的问题。
误区三:用列存库顶替业务主库。高频单行写入、强事务、按主键查单条,列存全都不擅长。它是分析系统的第二存储,不是交易库的替代品。看到"列存也支持更新"就把订单系统迁上去,大概率会在写入和事务上补课。
06 一套可复用的选型框架
按顺序回答下面几个问题,答案基本就出来了:
数据以追加为主的宽表事件流(日志、埋点、监控时序)?选 ClickHouse。运维最轻、压缩最狠,偶尔的 JOIN 用字典表或反范式化解决。
要实时更新、高并发对外提供分析接口、希望直接用 MySQL 协议对接 BI?选 Apache Doris。
报表以多表 JOIN 为主,或数据已经在 Iceberg 等湖里、想做湖仓加速?选 StarRocks。
传统 T+1 企业数仓、重度依赖 PostgreSQL 生态、有专职 DBA?选 Greenplum。
不想自建、团队小、数据在云上?选 Snowflake、BigQuery、Redshift 等托管服务。
还有一个常被忽视的维度:你的团队能维护多少种组件。2026 年的今天,三个开源引擎的功能清单正在快速趋同,但"最坏的一天"各不相同——ClickHouse 的坏日子是复杂 JOIN 和更新语义带来的意外,MPP 引擎的坏日子是更多节点角色和调优词汇,Greenplum 的坏日子是扩容重分布和 VACUUM。选型本质上是在选你能接受的故障模式。
列式存储从 Yandex 的内部系统起步,不到十年长成了一个庞大的产品家族。热闹背后,真正有效的判断从来没变过:先看查询形态——单表还是多表、追加还是更新、分析师用还是给用户用、自建还是托管。
没有最快的列式数据库,只有最匹配你数据形态的那一个。