大模型修炼手册 · 第 5 篇(共 7 篇)
同样是对齐,为什么 PPO 要四个模型齐驻显存,DPO 只要两个?
差的其实不是两个模型,是一整套训练体系。问题也来了:DPO 更简洁,是不是就该全面替代 PPO?
这篇把两条路线的机制、成本与适用场景一次讲清,文末给一张能直接进方案附录的决策表。
先问一句:你们团队的对齐,现在卡在哪一段?
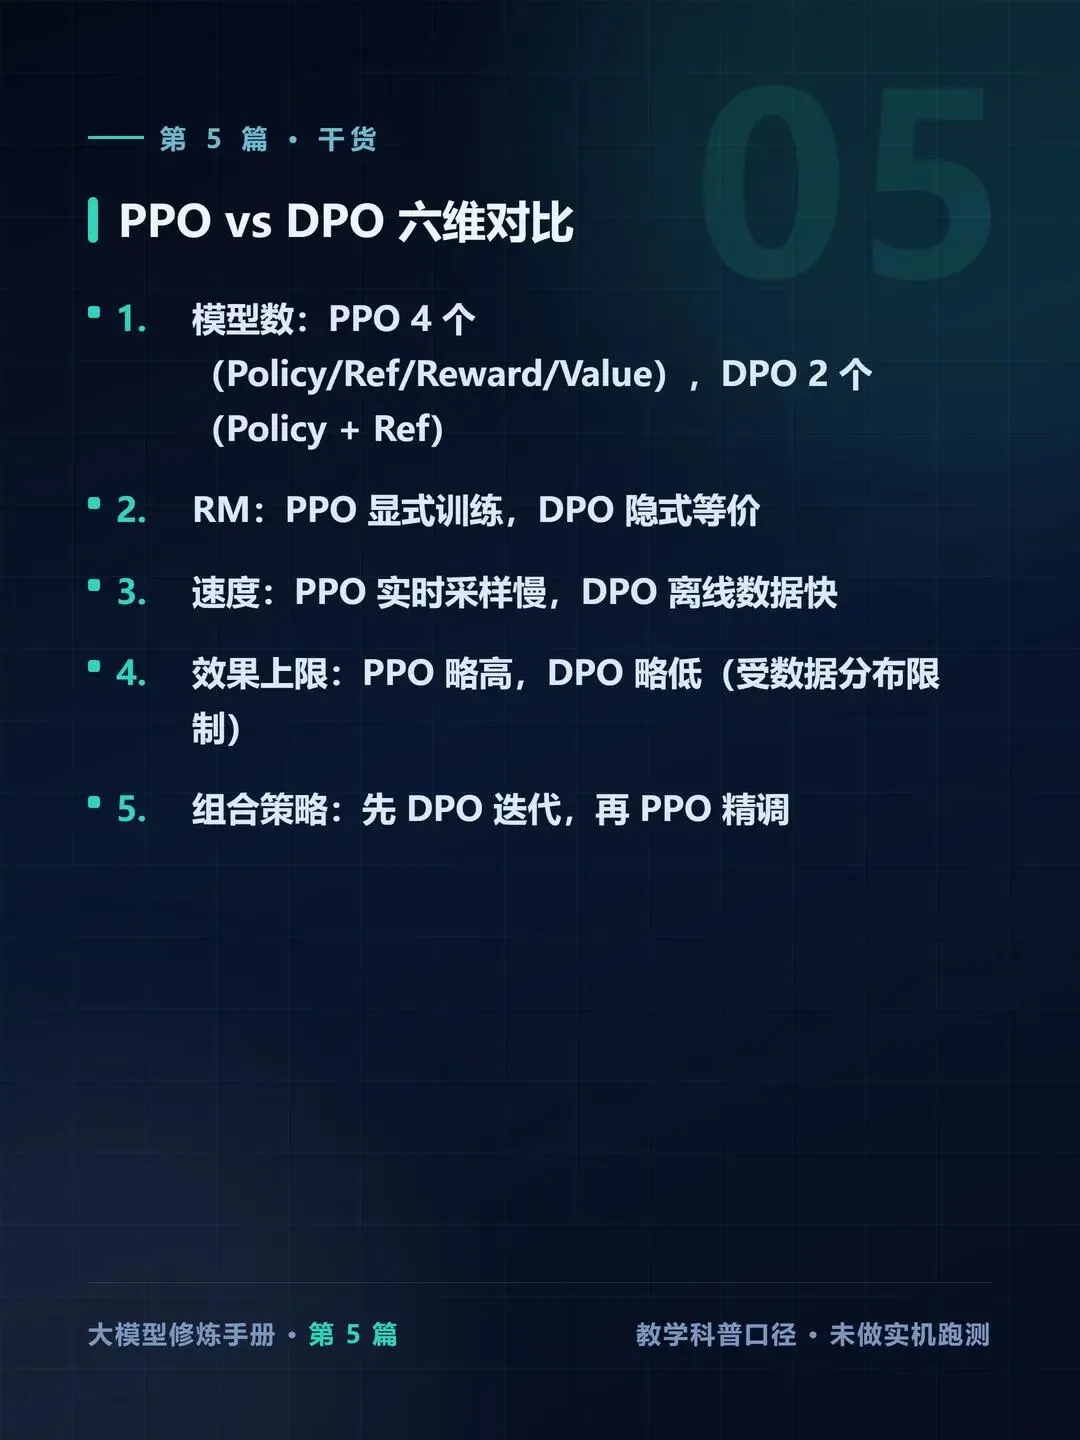
本篇干货卡:PPO vs DPO 六维对比
一、RLHF 三步:先回忆路线
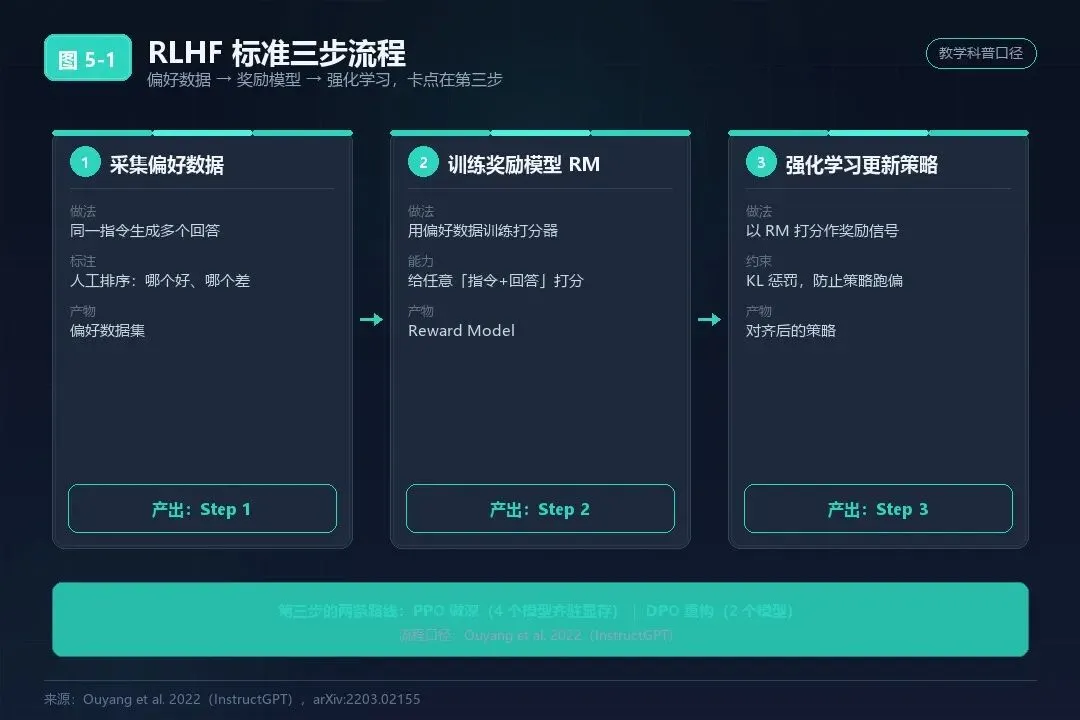
图 1 · RLHF 三步流程图:偏好数据 → 奖励模型 → 强化学习(来源:Ouyang et al. 2022)
第 2 篇讲过,RLHF 是让模型「明辨是非」的阶段。
标准流程分三步,出自 InstructGPT 论文(Ouyang et al. 2022):
- 1. 采集偏好数据:让 SFT 模型对同一个指令生成多个回答,人工标注员给这些回答排序——哪个好、哪个差。
- 2. 训练奖励模型(Reward Model,RM):用偏好数据教会 RM 给任意「指令 + 回答」打分。
- 3. 强化学习:以 RM 的打分为奖励信号,用强化学习算法更新 SFT 模型,让它更倾向于生成高分回答。
难点在第三步。 强化学习本身就难以稳定训练,再叠上大模型的参数量与工程复杂度,这一步成了对齐链路里又难又贵的一环。于是业界分出两条主流路线:一条把第三步做深,即 PPO;另一条重构问题,即 DPO。
二、PPO:经典但复杂
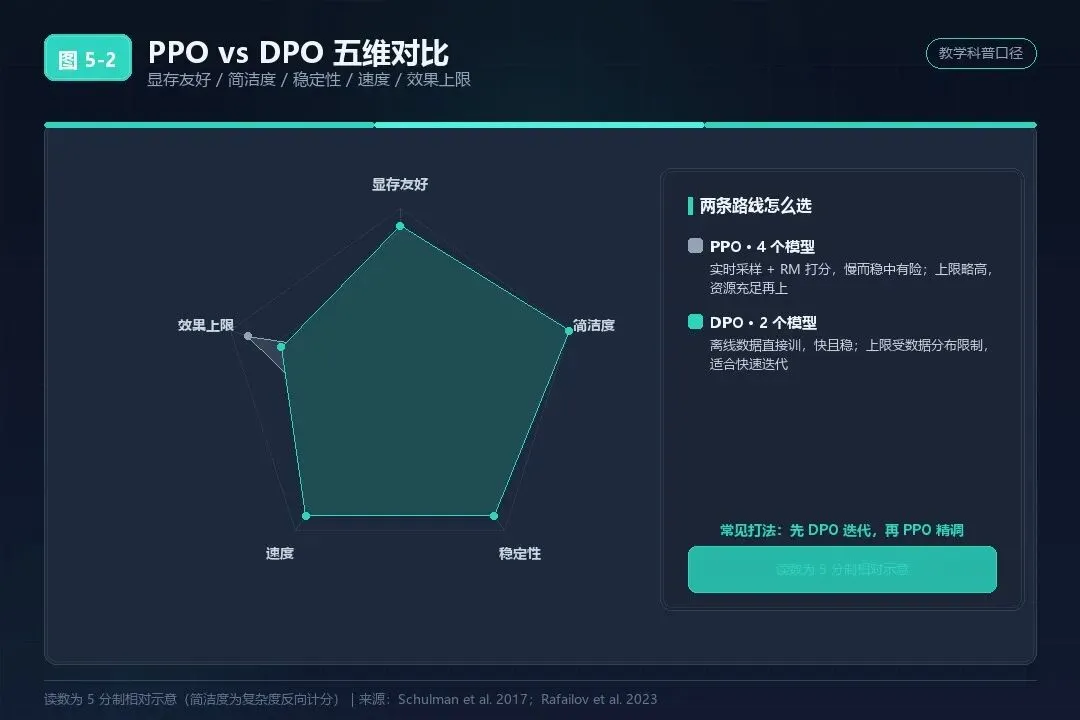
图 2 · 内存中模型数对比:PPO 4 个(Policy/Ref/Reward/Value)vs DPO 2 个(Policy/Ref)
PPO(Proximal Policy Optimization,近端策略优化)的对齐路线,是 Inst
ructGPT(GPT-3.5)论文实证的方案,也是业界主流。
它要求四个模型同时驻留内存,各司其职——这也是显存账上值得关注的一笔:
- Policy Model:正在被优化的模型,负责生成回答,是训练的主角。
- Reference Model:冻结的 SFT 模型,充当「别跑偏」的基准。
- Value Model(Critic):预估当前状态下未来能拿多少分的预测员。
训练流程四步一环:Policy 生成回答 → Reward Model 打分 → 结合 Value Model 的预测计算优势(Advantage)→ 用优势信号更新 Policy。
同时以 KL 散度惩罚,防止 Policy 偏离 Reference 太远。损失函数长这样:
`PPO 损失 = -min(r*A, clip(r, 1-eps, 1+eps)*A) + beta*KL(Policy || Ref)`
其中 r = pi_new(a|s)/pi_old(a|s),是新旧策略的概率比,A 是优势函数。
用少林寺打比方:武僧(Policy)日常练功,方丈(RewardModel)给招式打分,大师兄(ValueModel)预估每个武僧的潜力,戒律院(ReferenceModel)盯着招式是否偏离少林正统。
四个角色缺一不可,训练体系完整,但需要大量寺庙资源——换算成工程语言,就是显存。
这里补一句口径,售前被问到时用得上:PPO 路线有 InstructGPT 论文实证;
GPT-4 未披露对齐细节,两者不能画等号。
三、DPO:简洁优雅的替代
DPO(Direct Preference Optimization,直接偏好优化)是 2023 年 Stanford 团队提出的算法(Rafailov et al. 2023)。
它的核心洞察是一句数学判断:RLHF 的目标可以从偏好数据里直接推导出来,不需要显式训练 RM。
三步并成一步。「训练 RM → 用 RM 打分 → 用 RL 更新策略」的链条,被压缩成「直接拿偏好数据优化模型」。数学上,DPO 等价于隐式学到了一个奖励模型——只是不必把它真的训练出来。
所以 DPO 只需要两个模型:Policy 和 Reference。
损失函数长这样:
`DPO 损失 = -log[sigmoid(beta*(log(pi(y_w)/pi_ref(y_w)) - log(pi(y_l)/pi_ref(y_l))))]`
其中 y_w 是偏好排序中较好的回答,y_l 是较差的回答,beta 是温度系数。
直观理解:抬高好回答的概率,压低差回答的概率,同时用KL项与Reference 保持距离。
用金庸的话说,DPO 像独孤九剑。
令狐冲学剑时,风清扬没有摆出一套复杂剑法体系(不用训练 RM),而是直接告诉他「这一招该这样破」。
大量对拆练习(偏好数据)喂下去,剑意(隐式 RM)自然领悟,趋于无招胜有招。
比少林寺那套庞大体系简洁得多,论文与业界实践里的效果同样能打。
四、对比与选型
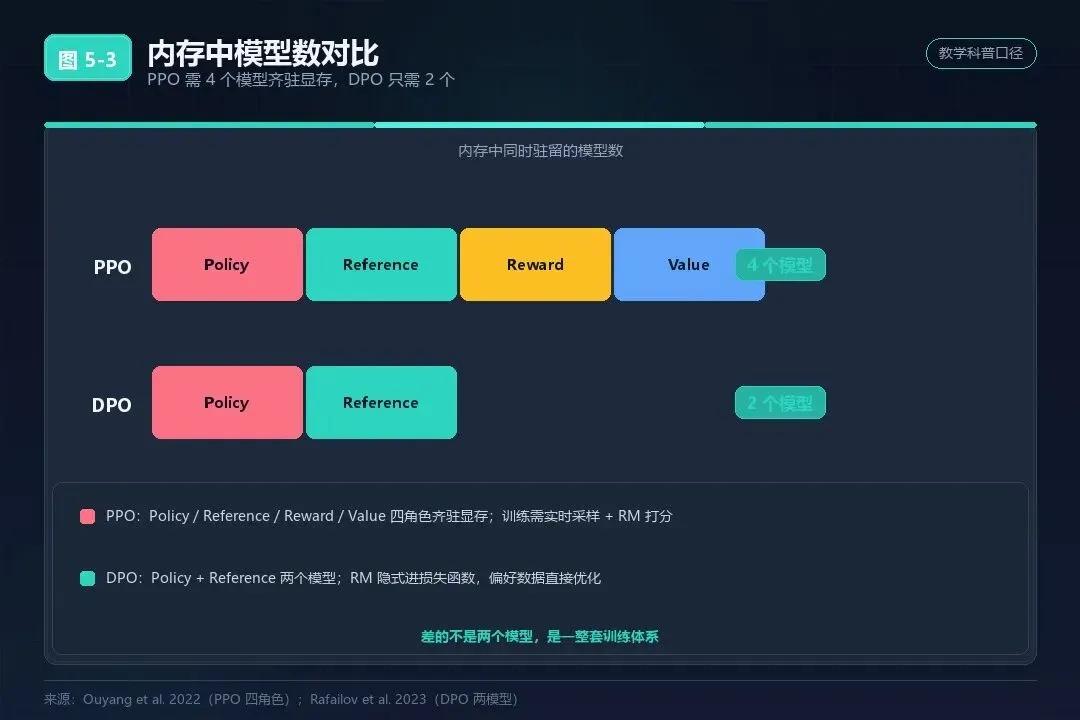
图 3 · PPO vs DPO 五维雷达图(显存/复杂度/稳定性/速度/效果上限)
两条路线不是谁取代谁,先看六行对比表:
实践中的常见打法是把两者组合起来:先用 DPO 快速迭代,再用 PPO 精调。
选型按「阶段-资源-目标」三维来想:
- 阶段:早期实验、方向验证,DPO 起步快,先用它试错。
- 资源:卡多、显存足,才养得起 PPO 的四个模型;预算紧,DPO 先跑起来。
- 目标:冲效果上限,PPO 更占优;要快速交付,DPO 性价比更高。
结论
三个结论先放这儿- PPO 是四个模型的工程:Policy、Reference、Reward、Value 缺一不可,显存与稳定性成本都高;DPO 只要两个模型,把 RM 隐式进损失函数,换来简洁与稳定。
- 组合优于单选:先 DPO 快速迭代、再 PPO 精调,是论文与业界常见打法。
- 口径要稳:PPO 系路线是 InstructGPT(GPT-3.5)论文实证的方案;GPT-4 未披露对齐细节。别把「GPT-4 用的算法」挂在嘴边——客户真去查论文,这句话会变成杠点。
售前落点技术型客户会直接问:你们对齐用什么算法?为什么不用 DPO?一段稳健答法分三层:
- 1. 先问阶段:客户还在早期验证,就答「默认 DPO 快速迭代,省掉 RM 训练与两个模型的显存」;临近上线冲刺,就答「这一版上 PPO 精调,追效果上限」。
- 2. 再讲组合逻辑:不是二选一,是「DPO 迭代 + PPO 精调」的组合。把四个模型与两个模型的成本差摆出来,显存与工期的账客户自然听懂。
- 3. 防杠口径:被问「这不是 GPT-4 用的算法吗」,直接纠正——InstructGPT 论文实证的是 PPO 路线,GPT-4 的对齐细节未披露。把这层讲给客户,反而显得专业严谨。
本篇的六维对比表与「阶段-资源-目标」决策表,可直接进方案附录。
你的项目里,对齐卡在哪一段:Reward Model 不好训,还是 PPO 调不稳?评论区聊聊。觉得有用,点个在看。
