作为测试工程师你会大模型评测吗?这篇文章告诉你怎么落地:从评分标准到AI裁判
大模型评测最难的地方,不是模型多强,而是很多题根本没有标准答案。开放问答、创意写作、多轮对话,怎么评?这篇文章聊聊从评分标准到AI裁判的落地思路。一、问题背景
传统测试有明确的预期结果,对就是对,错就是错。但大模型的输出是开放的,同一道题可以有多种合理答案。如果还用精确匹配,稍微换个说法就判错,评测结果严重失真。可如果全靠人工评,成本高、速度慢、还难保一致。于是评测的核心矛盾变成:如何在没有唯一标准答案的情况下,做出可比较、可复现的评估。二、核心概念解释
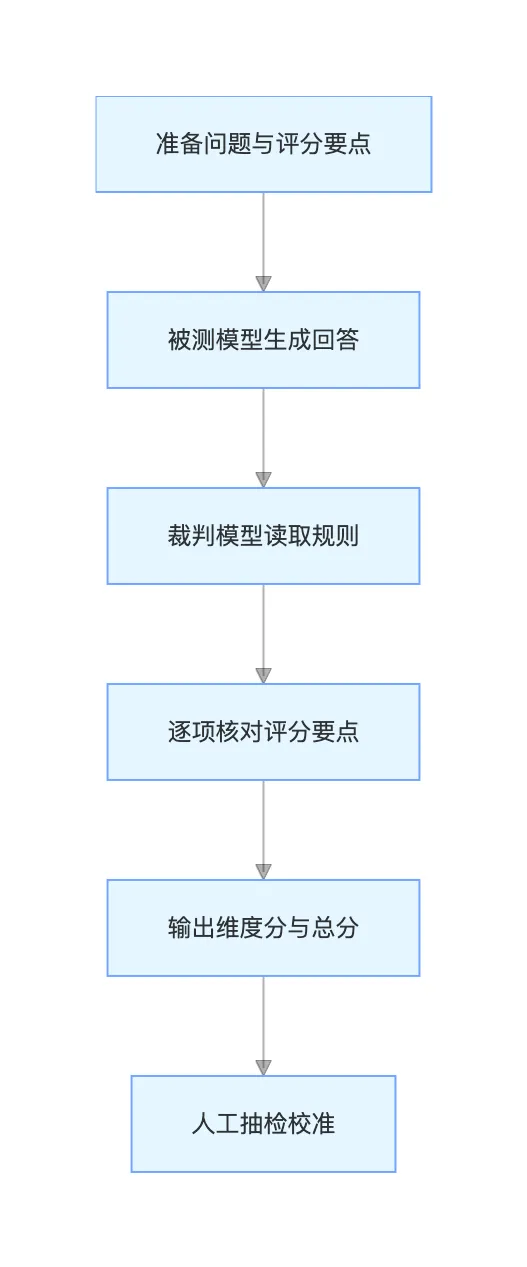
解决思路是引入裁判模型,也就是用一个更强的大模型来评估被测模型的回答。裁判模型不只看最终答案,而是对照人工标注的评分要点,判断被测模型答出了哪些关键点、有没有事实错误、是否偏离问题。评测前要准备三样东西:用户问题、参考答案或评分要点、评分规则清单。裁判模型按规则逐项核对,再给出维度分和总分。三、案例分析
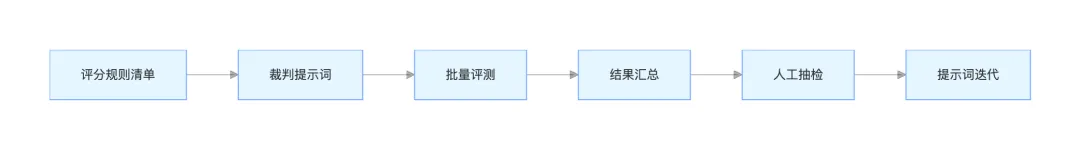
背景:某智能问答产品需要持续评测回答质量,人工评分无法支撑高频迭代。约束是评分标准要贴近业务,且结果要可复现。问题:一是开放答案难以精确匹配;二是人工评分标准不统一,不同人打分差异大;三是评测频率高,人工跟不上迭代节奏。第一步,定义评分规则清单。把业务关注点拆成可核对的条目,比如是否包含关键信息、是否有事实错误、是否回答了问题本身。第二步,设计裁判提示词。让裁判模型先逐条核对规则并引用原文作为证据,再给出准确性、相关性、完整性、流畅性、有用性五个维度的分数。第三步,人工抽检校准。定期抽取裁判结果与人工评分对比,发现偏差就调整提示词或规则,保证评测可信。结果:这套方案能支撑高频评测,把人工从重复打分中解放出来。局限是裁判模型本身也可能出错,必须保留人工抽检环节,不能完全放手。四、实践经验
第一个坑,评分规则太笼统。像“回答得好不好”这种规则,裁判模型无法执行。规则必须具体到可核对。第二个坑,不给裁判模型证据要求。如果不要求引用原文,裁判容易凭感觉打分。要求它引用证据,能显著提升一致性。第三个坑,完全信任裁判结果。裁判模型也会有偏见和错误,必须定期人工抽检,把它当成辅助工具而非最终裁判。可复用经验:把评分规则清单当成测试用例来维护,规则越清晰,评测越稳定。规则变更要有版本记录,方便回溯对比。五、落地建议
第一,先写评分规则清单。把业务关注点拆成可核对条目,这是整个评测体系的地基。第二,要求裁判引用证据。在提示词里明确要求逐条核对并引用原文,提升评分一致性。第三,建立抽检机制。定期用人工评分校准裁判结果,发现偏差及时调整,保证评测长期可信。六、我的观点
我的观点是:大模型评测的瓶颈不在模型能力,而在评分标准的设计。理由一,裁判模型再强,规则不清它也评不准。评分标准的清晰度直接决定评测上限。理由二,评测要可复现才有价值。规则清单加人工抽检,才能让结果稳定可信,而不是每次都不一样。七、总结
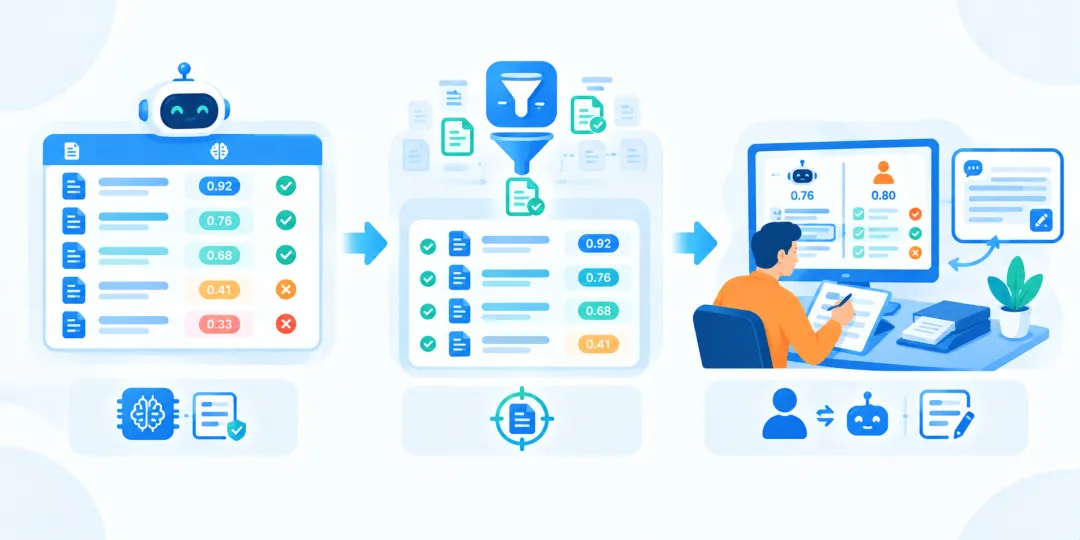
回到开头的问题:没有标准答案怎么评?答案是先把评分标准写清楚,再用裁判模型批量执行,最后用人工抽检校准。评测的核心不是找一个完美裁判,而是建立一套可比较、可复现、可持续迭代的机制。
关注测试开发、AI 测试、Agent 评测与工程实践。希望帮助更多测试工程师,在 AI 时代构建自己的核心竞争力。