一、先给结论
同步复制只做一件事:提交时等几个从库点头。写错组合,挂一台从库就写死主库。
而"等谁、等几个",全写在 synchronous_standby_names 这一个参数里——改一个关键字,就是另一种容错行为。
一句话结论:生产一主两从选 ANY 1,挂一台从库不影响写入;只有业务明确要求"数据必须同时落在两台机器上"时,才用 ANY 2 或 FIRST 2,并且必须接受"任意一台从库故障 = 写入停摆"。
记两个关键字就够了:
- FIRST 认顺序——按名单顺序取前 N 个,第一个活着就得等它,它慢,大家一起慢
- ANY 认数量——名单里任意 N 个回了 ACK 就算数,谁先回应谁作数
二、主库 commit 的时候,在等谁
一次同步提交,主库要走完四步:
- 按
synchronous_standby_names 挑出目标备库,把 WAL 推过去 - 等备库按
synchronous_commit 指定的级别回 ACK
这就解释了同步复制下的一个常见错觉:以为是"从库变慢了",其实主库的每一次提交,都在等从库。从库磁盘抖一下,业务侧感受到的是数据库整体变慢。
两个参数各管一头:
| | |
|---|
synchronous_standby_names | | 空串 / 裸列表 / FIRST n / ANY n |
synchronous_commit | | off / local / remote_write / on / remote_apply |
这篇只讲第一个——"等谁"。第二个"等到哪一步",坑一点不比这个少,留到下一篇单独说。
三、六种配法,六种行为
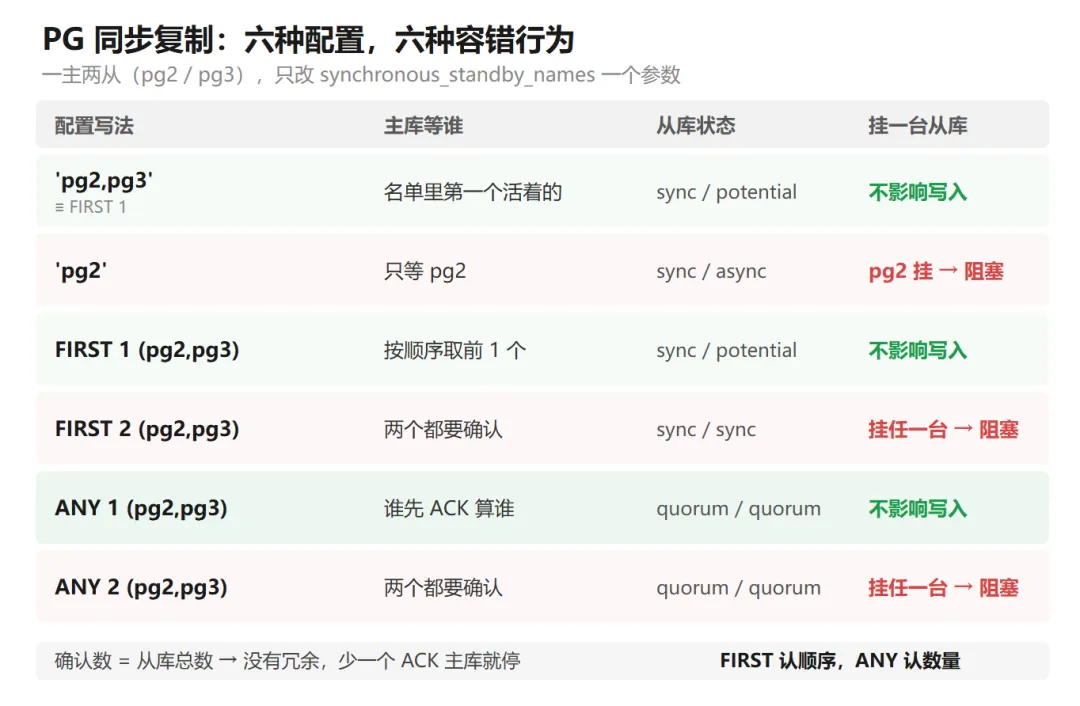
以一台主库加两台从库(pg2、pg3)为例,synchronous_standby_names 的几种写法,对应的行为完全不同:
标"阻塞"的那几行是同一类问题:当确认数等于从库总数时,同步就没有冗余了。 少一个 ACK,主库只能站在原地等,pg_stat_activity 里一排 wait_event = SyncRep,客户端全部超时。
而 FIRST 1 和 ANY 1 的区别只在"等谁":
FIRST 1 认顺序——pg2 只要在名单里且活着,主库就一直等它。它那块盘抖一下,全公司的提交跟着抖ANY 1 认数量——pg2 不响应,pg3 回 ACK 一样算数。天生抗单点,所以它是生产一主两从最常用的配置
一个容易记混的细节:sync_priority 在 ANY 模式下恒为 1,它不排序。要看顺序,只能用 FIRST。
四、sync_state 四个取值怎么读
pg_stat_replication 里有一列 sync_state,判断"现在到底谁在扛同步"就靠它:
| |
|---|
sync | |
potential | 在候选名单里,但本轮没被选中(FIRST 模式特有) |
quorum | ANY |
async | |
看一眼就能回答两个问题:现在是谁在扛同步(sync 那一行)、切换代价有多大(有几个 sync / quorum 候选)。
五、怎么选:三种场景,三种答案
| | | |
|---|
| ANY 1 (pg2,pg3) | | |
| ANY 2 (pg2,pg3) | | 挂任意一台从库 → 写入停摆 |
| | | |
选型原则其实只有一句:先问清楚"这份数据丢一个事务窗口能不能接受"。
能接受,就 ANY 1;不能接受,就 ANY 2 或 FIRST 2——但必须把"从库故障 = 写入停摆"这一条写进运维预案和告警里,而不是只在设计文档里写一句"我们开了强同步"。
还有个写法值得单独点出来:别用 'pg2' 这种只写一台的配置。 它看着像"精确指定",实际是把同步复制的全部风险押在一台机器上——你明明有两台从库,出事的时候一台也赔不上。
六、改配置:两条命令 + 一步验证
synchronous_standby_names 是 sighup 级参数,改完 reload 即可,不用重启实例:
ALTER SYSTEM SET synchronous_standby_names = 'ANY 1 (pg2,pg3)';SELECT pg_reload_conf();
验证是否真的生效:
SELECT application_name, state, sync_priority, sync_stateFROM pg_stat_replication;
这里有个必须提前确认的细节:名单里的名字取自备库 primary_conninfo 的 application_name,既不是主机名,也不是 pg_stat_activity 里的用户名。写错了会怎样?主库找不到任何一个同步备库,所有提交直接挂起。
改之前先在备库上把名字核一遍:
SHOW primary_conninfo; -- 备库执行,注意输出里带密码,别往聊天窗口贴
七、三个坑,每个都能砸出事故
7.1 从库挂了写入卡死:第一反应是降级,不是删配置
FIRST 2 / ANY 2 下从库故障,主库的行为是所有写事务原地等待。这时候有三种止血手段,性质完全不同:
| | |
|---|
SET LOCAL synchronous_commit = off | | |
ALTER SYSTEM SET synchronous_commit = off | | 所有提交不再等备库;切换时可能丢数据,事后必须改回 |
ALTER SYSTEM SET synchronous_standby_names = '' | | |
synchronous_commit 的五个档位,本质是把"等到哪一步"逐级放宽:
| |
|---|
off | |
local | |
remote_write | 等备库收到并写入 OS 缓冲(备库此刻 crash 会丢) |
on | |
remote_apply | |
降级到 remote_write 是最常用的折中:备库还在,事务还等它收到,但不等它落地——写入阻塞能缓解,代价是备库如果在这段时间崩溃会丢几个事务。
降级是应急动作,不是长期方案。
7.2 复制槽会反向撑爆主库
这条比从库挂掉更凶,而且跟同步没关系——用了复制槽就有。
复制槽的语义是"主库承诺为这个备库保留 WAL,直到它确认收到"。于是:
- 备库长期离线 → 主库持续保留 WAL →
pg_wal 无限膨胀 → 磁盘满 → 主库写入全挂 - 这时
wal_keep_size 救不了场:复制槽的保留优先级更高,WAL 不会被回收
先看清楚每个槽落后了多少:
SELECT slot_name, active, pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS retainedFROM pg_replication_slots;
PG 13 起可以给单个槽设保留上限,超限后主库主动废弃这个槽:
max_slot_wal_keep_size = 16GB
要记住的是:槽被废弃不等于没代价——备库得重新做一次 pg_basebackup 全量。这道保护是"两害相权取其轻",不是免费的。
7.3 同步复制不等于高可用
同步复制保证的是数据不丢,不是服务不停。
主库宕机时,它不会自己把从库提上来。原生手段是人工 pg_ctl promote,从判断、决策到执行全在人手里。一主两从加同步复制,只把"数据一致性"这一半做完了;"自动切换"那一半要靠 Patroni + ETCD 这类外部组件。
所以配完同步复制,最该同步落下的是两个告警:从库状态掉了、写入延迟超标。前者不告警,你会在业务已经卡死之后才知道。
八、上线前的检查清单
| |
|---|
| synchronous_standby_names 里的名字与备库 application_name 完全一致 |
| 确认数小于从库总数(留一台余量),除非业务明确要求两份落地 |
| 每个备库一个物理槽,且已设 max_slot_wal_keep_size |
| pg_wal |
| 写阻塞时的处置顺序与执行人(先按事务降级,再考虑全局) |
| sync_state 由 sync / quorum 变 async、或写延迟超阈值要告警 |
| 真停一台从库,确认"是阻塞还是继续写"与设计预期一致 |
最后一行最容易被跳过,也最值钱——同步复制的行为差异,只有真的拔掉一台从库才看得出来。