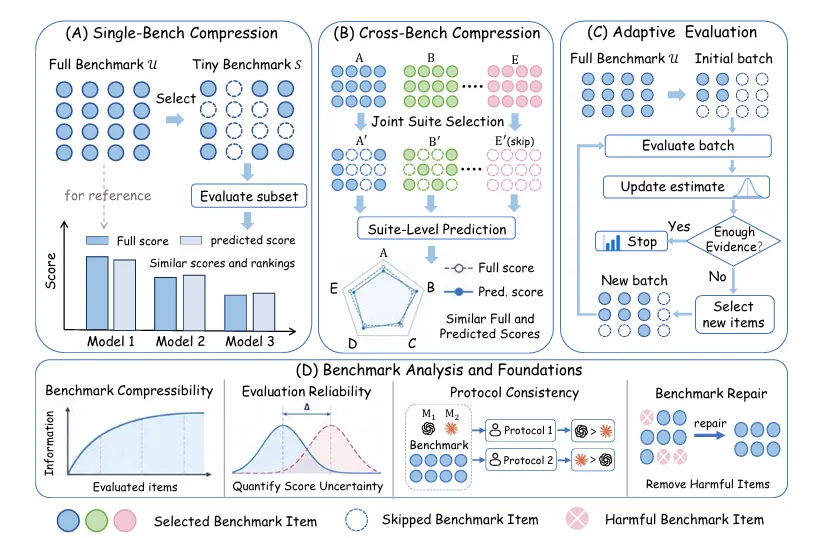
原论文图2|研究框架:单基准压缩、跨基准压缩、自适应评测,以及可靠性基础研究。来源:PDF第2页。少测哪些题,取决于手里有什么信息
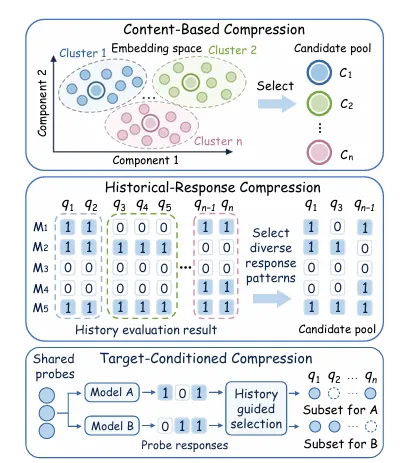
对于单个基准,论文按选题所用的信息,将静态压缩分成三类。这里的“静态”指主要评测开始前固定子集,并不要求所有模型使用同一份短卷。
第一类只利用题目内容或抽样规则。可以随机、分层抽样,也可以按文本表示、技能或推理特征分组,再挑代表题。它不需要先收集大量模型的完整成绩,起步成本较低。不过,文字看起来不同的题,仍可能测同一种能力;很小的随机样本也可能波动很大。
第二类复用历史答题记录。把过去模型的逐题表现排成“模型×题目”矩阵,就能观察哪些题的响应模式相似,再选代表题,或学习从少量答题结果预测完整成绩。tinyBenchmarks、MiniLongBench 是综述讨论的例子。这类方法把成本前置,后续反复评测新模型时才更容易摊薄。
第三类先观察当前模型的廉价信号。例如,先答少量探针题,再寻找行为相似的历史模型,为它定制子集;也可以借助较便宜的裁判辅助选择人工复核样本。子集仍在主要评测前固定,但不同模型可以拿到不同题。
三类方法的信息越来越贴近目标模型,额外成本也需要一起核算。探针、全量输出扫描和廉价裁判调用,只有比省下的测试或人工审核便宜,压缩才有收益。
原论文图4|单基准选题的三种信息来源:题目内容、历史响应、当前模型的低成本探针。来源:PDF第4页。选出短卷之后,怎样还原完整成绩?
选题和计分是两个相连的问题。随机或分层样本可以用均值、组权重估计整体;按非均匀概率抽样时,可以用概率的倒数加权,修正某些题更容易被选中的影响,但权重差异过大也会增加方差。
另一条路线是用历史数据预测未测题的结果,再利用实际抽样观察到的误差进行校正。相应的可靠性依赖抽样条件、预测模型和新旧模型之间的迁移情况。
因此,短卷上的高准确率,不能直接当作原基准成绩。偏向困难题或高区分度题后,题目分布已经改变;如果没有合适的恢复规则,得到的可能是一份新测验。
这个思路还可以扩展到整套基准:利用不同基准之间的能力关联,联合选题,甚至只运行少数完整任务,预测跳过的任务成绩。代价是更依赖跨任务关系。一旦新模型打破历史相关性,部分任务就需要直接评测。
边测边选,也要知道何时停
静态方法先决定测什么,自适应方法则利用已获得的结果,更新分数、能力或不确定性,再决定下一批题。
论文区分了两个控制点:选下一题,是把预算投向更有信息量的样本;决定停止,是判断现有证据是否足以支持所需精度、排名或胜负结论。一个方法可以只做其中一件,也可以同时做两件。
模型差距明显时,提前停止可能省下许多测试;差距很小时,仍可能接近完整评测。固定预算的方法也可能只是重新分配预算,并没有减少总量。部分方法最终只返回胜者或阈值决策,不能拿来与完整分数估计混为一谈。
此外,少调用几次模型不保证更快。批量静态测试容易并行,自适应测试要等待上一轮结果,调用数下降的同时,实际耗时可能上升。提前停止还需要有效的序贯规则,不能看到一次结果有利就结束。
可靠性,要看短卷之外的东西
综述强调,没有适用于所有基准的安全压缩比例。能否压缩,取决于要区分的模型差距、任务覆盖、允许误差和所需结果。保住总体排名,也可能扭曲分差,或颠倒实力接近的两个模型。
因此,验证不能只报排名相关性。估计分数要检查误差与偏差;比较模型要单独看接近打平的情况;报告区间还要看覆盖率与区间宽度。对照也应包含相同预算下的随机或分层抽样,复杂选题器并不必然更好。
历史记录驱动的方法,还要在未参与构建的新模型上验证,必要时留出整个模型家族或更晚发布的模型。完整评测与压缩评测应保持裁判、提示词、解码配置和 Agent 执行框架一致,避免把协议变化误当成压缩效果。
成本也要按完整生命周期计算:构建子集、采集探针、正式测试、恢复成绩、刷新数据与必要的回退检查。题目数、生成调用、裁判调用、人工时间和实际耗时,应分别说明。
压缩与修复,回答不同问题
删掉有歧义、能靠选项措辞猜中或缺乏区分度的题,可能让基准更合理,但成绩和排名也可能随之改变。这属于基准修复,需要作为新基准验证;压缩则以近似恢复既有完整结果为目标。
这篇综述的贡献,是把不同方法的输入条件、计分目标和成本边界放进同一个框架。它没有给出可直接横向排名的统一实验:所综述研究的设置差异很大,主要覆盖截至 2026 年 8 月的工作。
作者认为,压缩适合模型迭代、筛选和重复验证;与既有榜单正式比较时,完整评测仍常常必要。评测效率的改进,最终需要回答一个具体问题:省下这些测试之后,我们是否仍有足够证据支持原本要做的判断?