端砚赋行,评测设界——华为携手书生·端砚,把“专家级”能力带给医生
- 更新时间 2026-10-10 07:21:36
当大模型能力竞赛进入深水区,医学AI的高质量发展,应聚焦于算力底座能否自主创新,专家级能力能否真正交到医生手中,每一次上线是否都有标尺可依,需要一条从算力、能力到评测的全链条体系答案。
近日,第二届医学人工智能大会(MAIC 2026)期间,上海人工智能实验室展示以书生·端砚科学发现平台为基础打造的医学智能全景能力,包括算力适配、能力建设、评测治理三大方向,让专家级发现能力真正走近每一位医生。在这套体系背后,华为AI算力底座提供了关键支撑——实验室医学智能团队以智能体为核心,联合华为等生态企业,构建起贯通医学影像、证据检索、分子设计、公共卫生、临床诊疗多方向的技术体系。
书生·端砚让“专家级”能力走近每一位医生
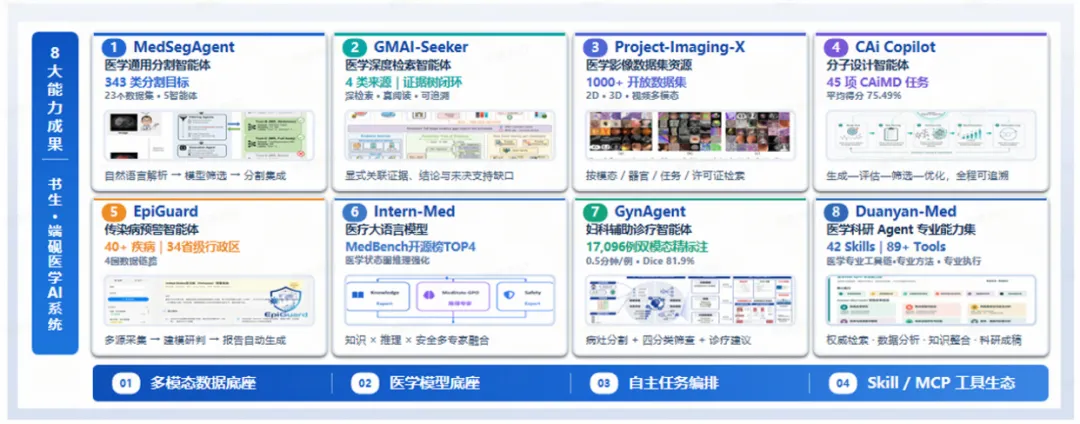
基于书生·端砚,实验室医学智能团队打造了医学通用分割智能体、医学深度检索智能体、医学影像数据集资源、分子设计智能体等系列成果。面向千兆像素全切片分析的病理多模态生成式交互大模型SlideChat有效提升医师诊断准确率与阅片效率,相关成果发表于高水平期刊《Nature Cancer》。在此基础上,实验室医学智能团队结合多模态数据底座、医学模型底座、自主任务编排与Skill/MCP工具生态,构建起从343类医学影像分割目标、1000余开放影像数据集,到45项分子设计任务、40余项科研Skills与80余专业工具的医学AI能力矩阵,将专家级医学发现过程变成“可计算闭环”。
华为算力基座锻造自主创新的新引擎
在算力基座层面,实验室医学智能团队联合DeepLink超智融合算力平台与华为团队协同攻关,率先完成医疗垂类大模型华为NPU全面适配,在百卡级昇腾NPU集群上,支撑起亿级医学数据、百亿参数模型的规模化训练,让安全可靠算力真正站上医学大模型的训练主战场。
从算子到框架、从显存到调度,攻关团队围绕安全可靠、开放创新芯片异构特性开展系统性工程优化。通过多模态序列打包,将影像、文本、结构等多源医学数据在训练管线中高效编排;通过NPU原生融合算子适配,让计算内核在华为AI架构上跑出原生性能;通过分布式显存管理与计算调度优化,让大规模参数在受限显存下稳定流转、算力不闲置。优化成果显示,预训练训练吞吐提升约54.5%,后训练训练吞吐提升约22.9%,训练效率的跃升,直接转化为模型迭代的加速度。在覆盖34项医疗基准的内部评测中,模型综合表现优于基线模型,平均得分提升约17.96%,各项能力在统一标尺下实现系统跃迁,印证安全可靠的算力底座不仅能"跑起来",更能"跑得稳、跑得好"。
端砚为医学大模型训练与推理筑起自主创新、安全高效的算力保障,也为"自主发现"注入源源不断的底层动能。这不仅是算力适配的技术突破,更是自主创新与开放生态的协同共建,让每一份医学数据、每一次科学发现,都能在安全可靠算力的坚实底座上,可复现、可扩展、可持续。
携手为前沿评测体系立起医学AI"中国标尺"
上海AI实验室与行业专家、产业生态正积极打造面向通用人工智能时代的创新开放评测体系司南(OpenCompass),构建覆盖通用大模型、科学智能、安全可靠、具身智能、AI计算系统、行业应用等方向的“六位一体”全景评估范式。从上海起步、向全国输出,MedBench5.0领衔国内原生医疗垂直评测体系,率先在上海先行先试,以"8+1"标杆架构将医疗AI的全生命周期嵌入闭环,让医学AI应用安全稳定推广。该体系首创医疗原子技能评测范式与Agent-as-Judge智能体评测引擎,覆盖63项细分临床评测任务、近100万道高精度专业评测试题、细分专科过百,联合钟南山、葛均波、范先群等院士团队深耕呼吸、心内、儿科、眼科、中医等专科赛道,把百余项应用场景测评铺进三甲、县域与公卫一线,赋能落地上千的真实临床场景。评测为发现设界,端砚为能力赋行,生态为成果加速——MedBench正由评测平台升维为由院士与顶级专家团队、权威机构、AI产业力量与一线医生共同铸就的国家级医学AI可信生态。
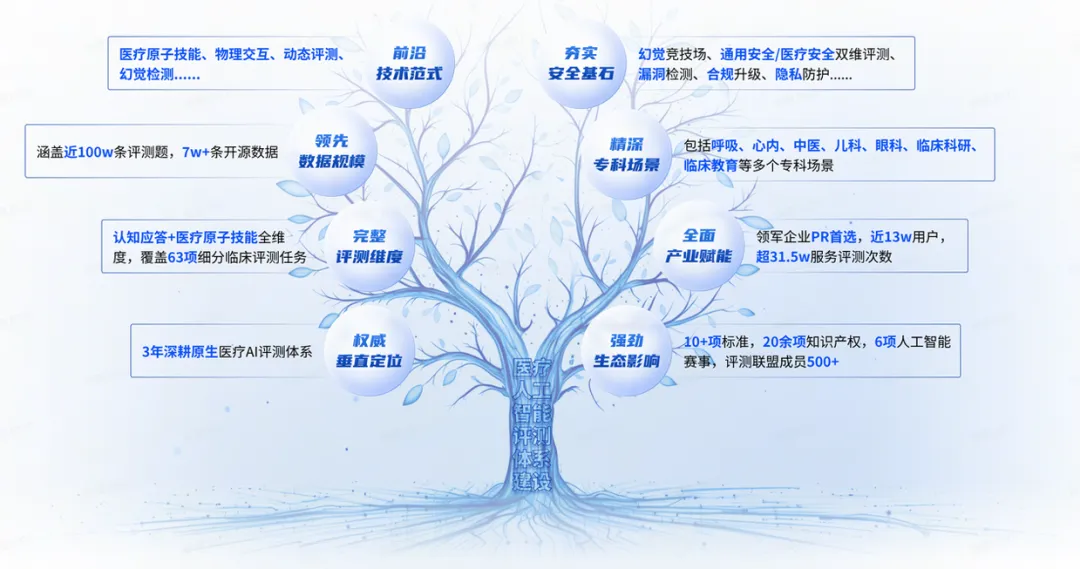
从算力适配到能力建设再到评测治理,端砚将医学AI高质量发展的命题逐项落地,让"算力自主创新、能力直抵一线、评测立起标尺"的体系图景渐次成型。上海以端砚自主发现引擎激活创新动能,以司南MedBench中国标尺校准可信边界,让医生成为超级合伙人、让科学家专注真发现,持续夯实算力、语料、评测、平台四大底座,推动医学AI从单点技术突破迈向体系化、规范化、普惠化发展新阶段,奋力开创为人民健康服务的人机共生新图景。
从算力基础设施到评测治理,从科研智能体到临床部署,华为正在成为医学AI“中国标尺”从研发到落地全链条上不可或缺的底座力量。
你的每一次“在看”,我都看得见!