一个模型在聊天窗口里回答得很流畅,不代表它适合进入企业流程。
比如,客户说:"我还没有要求退款,只想知道为什么扣了两次。"
如果模型把这句话识别成退款请求,客户可能会被送进错误的处理流程。再比如,客户说:"我的账户可能被接管,我需要马上处理。"模型如果只把它识别成普通登录问题,风险就更大。
对聊天产品来说,这可能只是一次回答不够准确。对企业来说,模型的判断会影响工单路由、人工升级、退款审批,甚至账户安全。
所以,企业评估 JEV 这类结构化判断模型时,不能只看它说话像不像人。企业更需要知道,它能不能在真实任务中稳定做对判断,并且在不确定时停下来,把问题交给人。
先明确模型到底要做什么
JEV 的特点,是让调用方提前定义问题和答案范围。
它可以回答一个判断题,也可以从几个选项中选择一个,还可以按照标准给出分数。常见的类型包括:
这样的模型通常不会直接生成一段长答案,而是返回标签、分数、概率或置信度。程序可以根据这些结果继续分流、排序、审核,或者决定是否转人工。
因此,企业在评估前,应该先把任务写清楚。
比如,"退款请求识别"不能只写成"判断客户是否想退款"。企业还要说明,什么算明确要求退款,什么只是询问扣款原因,哪些情况必须转人工,以及模型的结果是否会直接触发退款。
如果模型只负责把客户消息送到正确的队列,评估重点可能是分类准确率和路由错误率。如果模型的结果会直接触发退款、转账、封禁或账户修改,评估标准就要严格得多。
同一个模型,做普通分流和做账户安全判断,不能使用同一套门槛。
数据集要像生产现场,不要只像考试
企业最容易忽略的是数据集。
很多模型在公开题库上的成绩不错,但是公开题库和企业真实输入之间,往往有明显差别。企业消息可能很短,也可能缺少上下文。客户会打错字,会混用语言,也会在一句话里同时提出几个问题。
Google 研究者在《A Practical Guide for Evaluating LLMs and LLM-Reliant Systems》中,把评测数据概括为五个要求。
第一,范围要清楚。数据集要服务于一个明确任务,不能把分类、摘要、风险判断混在一起。
第二,数据要接近生产。企业应该使用脱敏后的真实消息、工单、日志或业务记录,而不是只使用人工编写的标准句子。
第三,数据要有变化。除了普通样本,还要加入边界、歧义、对抗和历史失败样本。
第四,数据要尽量避免污染。公开数据可能已经出现在模型训练材料中,模型的高分未必代表它真正理解了任务。
第五,数据要不断更新。产品、政策、客户表达和风险类型都会变化,评测集也不能一直停留在上线前的版本。
JEV 这套本地测试资料已经按照这个方向设计了 22 条样本。其中有 8 条常规样本、8 条边界样本和 6 条对抗样本。
例如,数据集中有一句:
"为什么你们扣了我两次?我还没有要求退款,只是想知道原因。"
这类样本比"请给我退款"更有价值,因为它能测试模型是否真的理解了退款请求的边界。
数据集中还加入了提示注入、多语言、账户安全和多个问题混在一起的情况。它们不一定覆盖所有生产风险,但是已经比单纯展示几段聊天更接近企业评估。
准确率只是第一层
对结构化判断模型来说,准确率当然重要。但是,企业不能只看一个总体准确率。
如果模型要判断"是否需要人工审核",企业需要同时关注 Precision、Recall、F1 和混淆矩阵。
比如,模型把很多普通问题转给人工,Recall 可能很高,但是人工队列会越来越长。如果模型很少转人工,自动化率看起来很好,却可能漏掉账户接管、欺诈或高金额退款。
这两种错误的代价并不相同。
因此,企业还应该计算成本加权错误:
平均错误成本 = Σ(错误数量 × 该错误的业务成本)/ 样本数
把账户接管识别成普通登录问题,和把普通咨询转给人工,不能按照同样的错误计算。
前一种错误可能导致安全事件,后一种错误通常只是增加人工处理量。只看平均准确率,企业很难看出这两类错误之间的差别。
2025 年的一项企业大模型评测研究也提出了类似问题。研究者认为,MMLU 等通用基准不能充分覆盖企业任务,所以他们设计了包含 14 类任务、约 9700 个样本的企业场景基准。这个研究不代表所有企业都应该照搬同一套题,但是它说明了一件事:企业需要围绕自己的任务建立评测集。
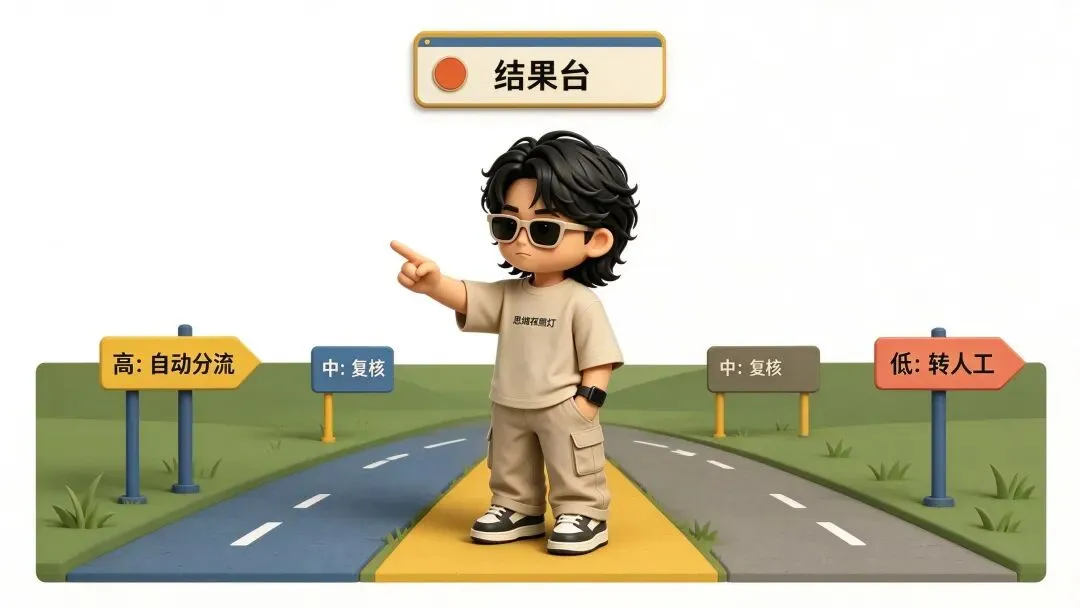
置信度要能决定下一步动作
JEV 的一个重要特点,是输出概率或置信度。
但是,置信度不能只作为界面上的一个数字。企业需要知道,这个数字能不能帮助系统决定下一步做什么。
比如:
- 涉及退款、封禁和账户安全时,即使置信度高,也要保留人工确认。
TypeSafe 官方文档强调了 confidence-gated routing,也就是按照动作风险设置不同的置信度门槛。低风险的只读操作可以使用较低门槛,高影响操作则需要更高门槛。
企业还要检查置信度是否真的可靠。
一种简单做法,是统计置信度不低于 0.8 的样本,看看这部分样本的实际准确率是多少。同时,还要记录这类样本占全部数据的比例。
如果高置信度样本的准确率只有 75%,这个置信度就不能直接用来触发自动操作。如果高置信度样本的准确率达到 95%,但是只覆盖 5% 的请求,模型也无法带来太多自动化收益。
更完整的评估还可以加入 Brier score、ECE,也就是置信度校准误差,以及风险和覆盖率曲线。它们可以帮助企业了解,模型在扩大自动处理范围时,错误率会怎么变化。
模型会拒答同样重要。
企业不应该要求模型对所有问题都给出结论。证据不足、表达含糊、风险过高时,模型能够停下来转人工,往往比强行给出一个答案更安全。
不过,拒答太多也会带来成本。企业还要记录人工升级率和人工纠正率,判断模型是不是把大量本来可以自动处理的请求都交给了人。
还要测试模型能不能经得住变化
模型在标准输入上表现稳定,不代表它能应对真实环境。
企业至少应该测试以下情况:
对同一个输入重复运行,也很有必要。企业可以统计多次运行后,模型是否一直给出相同标签。
如果一次判断是 billing,下一次变成 other,第三次又变成 technical,那么平均准确率再高,系统也不适合直接接入自动流程。
Stanford 的 HELM 综合评测框架把准确性、校准、鲁棒性、公平性、毒性、效率和版权等内容放在同一个评测框架里。它没有要求所有企业使用同一套指标,但是它提醒企业,模型评测不能只剩一个分数。
接口、延迟和成本也属于模型效果
企业上线的不是一个孤立的模型,而是一条接口和工作流。
所以,评测报告还要记录:
平均延迟只能说明大致情况。P95 延迟更能反映一部分用户在高峰期的真实等待时间。
结构化模型还要看输出格式是否稳定。如果模型判断正确,但是返回的字段缺失、类型错误或选项名称不一致,程序仍然无法继续执行。
Microsoft Foundry 的评估文档已经把任务完成、意图解决、工具调用准确性、工具参数正确性、工具调用成功率、风险安全和敏感数据泄露等内容列为不同的评估方向。
这些指标说明,企业要评估的不是一句话本身,而是这句话有没有让整个流程正确往下走。
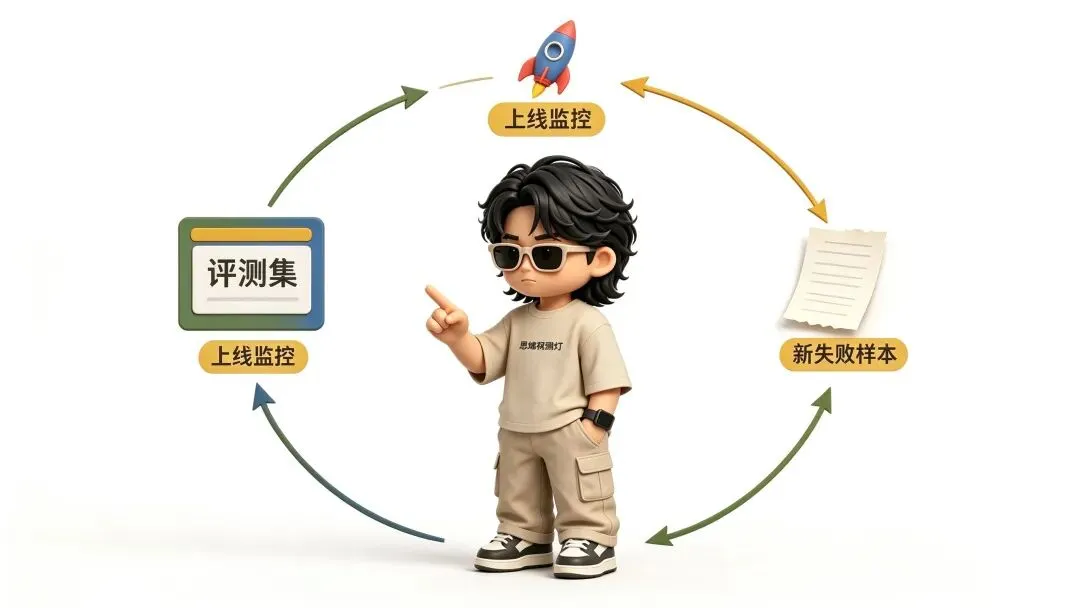
评测不能停在上线前
NIST 的 AI 风险管理框架把评估分成 Govern、Map、Measure 和 Manage 四个部分。它强调,企业要记录测试集、指标和评估工具,还要在接近生产的条件下验证模型,并在上线后持续监控。
这也是企业评测和一次模型考试的区别。
模型上线以后,企业还要观察:
后来出现的失败样本,应该回到评测集里。人工纠正的结果,也可以用来更新标签和判断标准。
如果评测只在上线前运行一次,企业只能知道模型在那一天的测试集上表现如何。企业不知道它是否适应了新的产品、新的政策和新的客户表达。
JEV 当前能测什么
现有 JEV 测试套件已经覆盖四类问题:
refund_requestedroute:问题属于 billing、technical、account 还是 other;urgency:问题的紧急程度是 low、medium 还是 high;manual_review
这套测试已经能够记录判断准确率、二分类指标、混淆矩阵、高置信度准确率、置信度覆盖率、重复一致率、失败请求、平均延迟、P95 延迟和 Token 使用量。
但是,它现在还更像一套评测链路,而不是一份完整的生产结论。
本地报告显示,mock 模式运行了三轮,共完成 66 次请求,四个问题的准确率都是 100%,重复一致率也是 100%。这个结果只能说明测试程序能够正常运行。因为 mock 使用的是确定性 fixture,延迟接近 0,Token 也是 0,所以它不能代表真实 JEV 接口的效果、速度和成本。
后续测试还需要使用 live 接口和更大的脱敏业务数据。同时,报告不能只显示总体平均值,还要分别展示常规、边界和对抗样本的结果,并单独查看高风险类别的漏检情况。
ECE、Brier score、选择性风险、线上人工纠正率和业务成本,也还应该加入评测范围。
这样看,企业真正需要的不是一张"模型得分很高"的成绩单,而是一份能够回答具体问题的记录:模型在哪些任务上可靠,哪些输入容易出错,什么时候应该停下来,以及一次错误会给业务带来什么后果。
当前这份 mock 报告首先证明的是,评测程序已经能跑通。真实 live 结果还要等接口、数据和版本都固定下来。