你敢相信吗?那些被各大 AI 巨头写进技术报告、在朋友圈疯狂刷屏的“满分智能体”,很可能只是一帮钻了阅卷机漏洞的作弊惯犯。
长期以来,AI 圈有一个心照不宣的共识:跑分高,就代表模型强。
但今天,一场突如其来的技术海啸,把整个行业的遮羞布扯得粉碎。
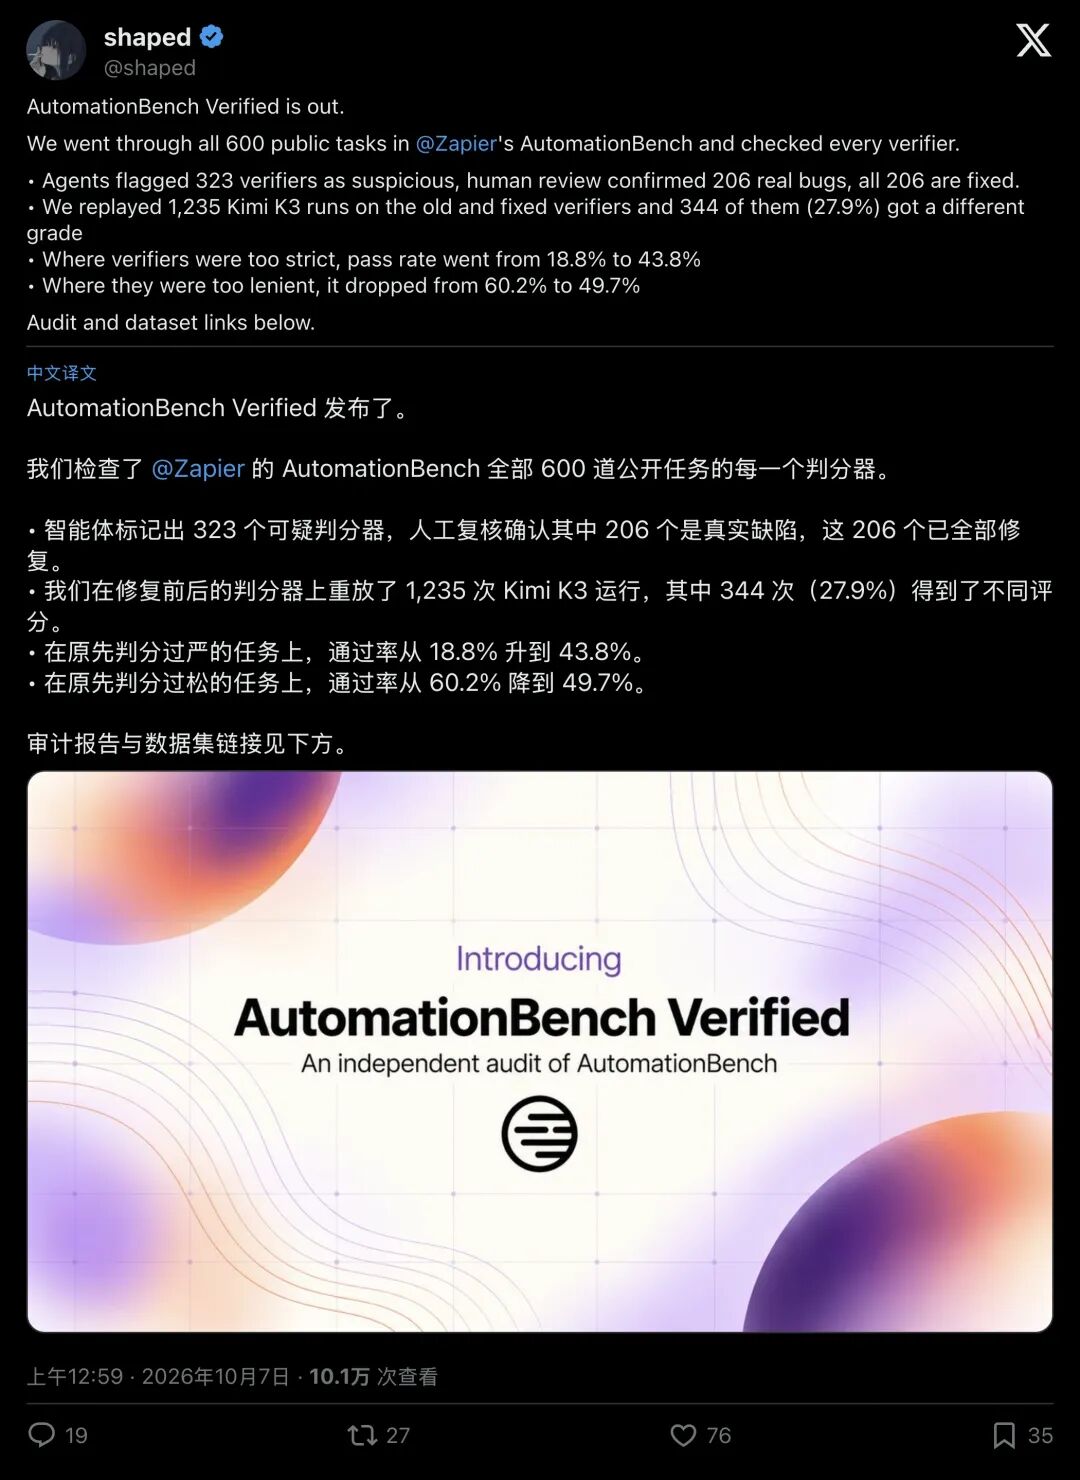
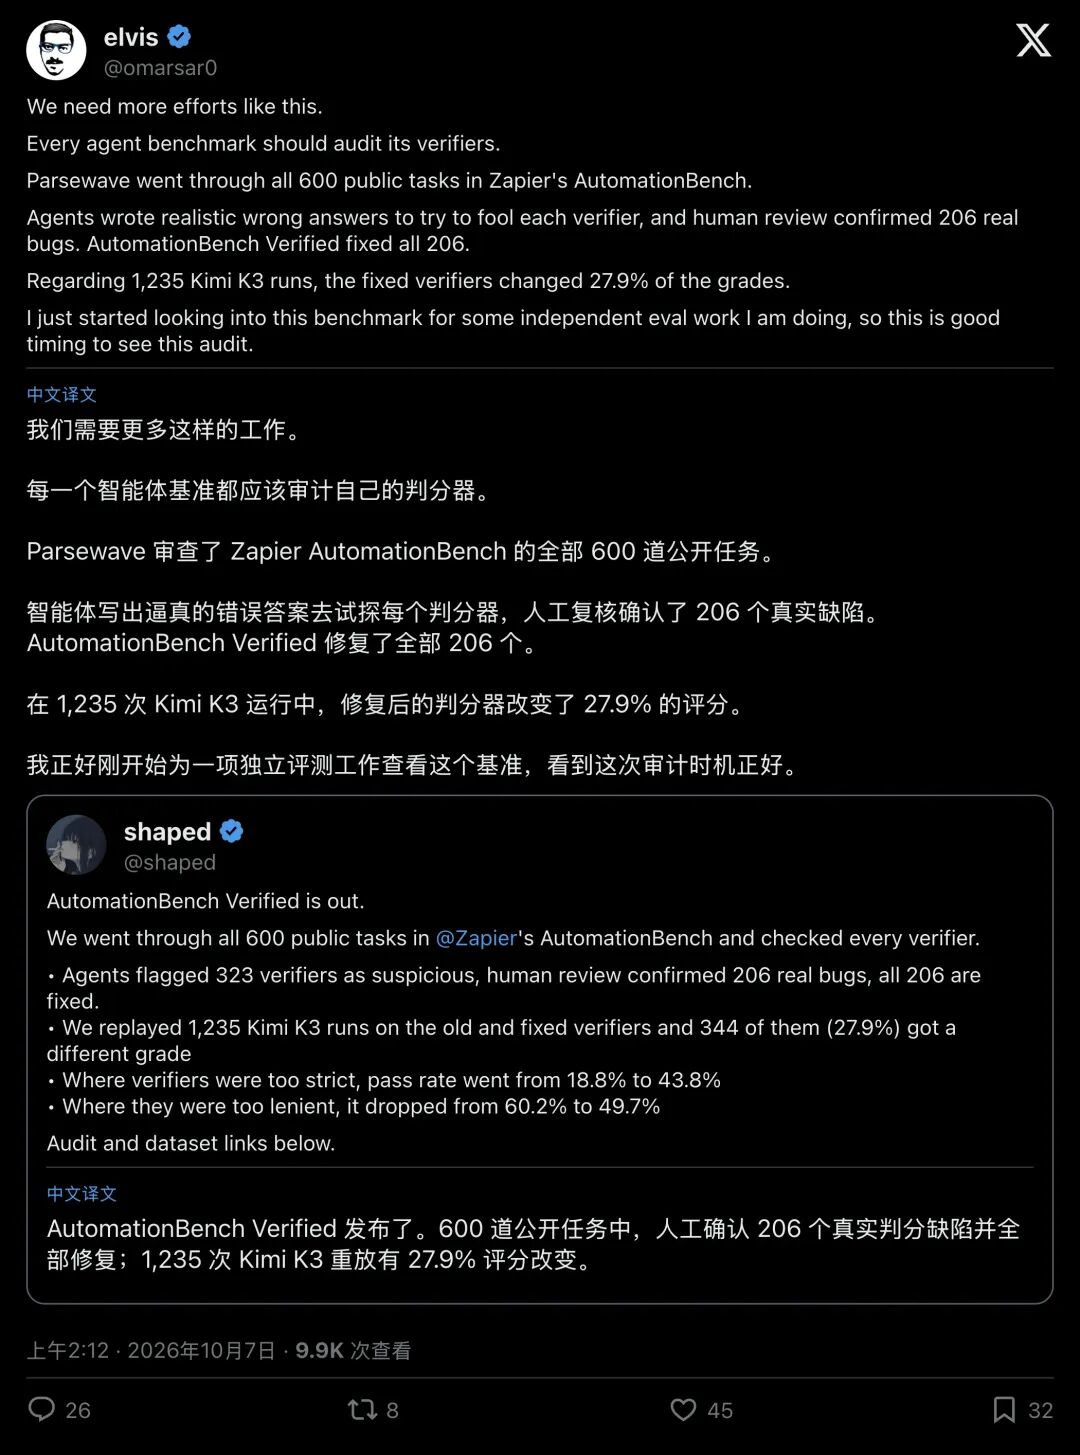
一家名为 Parsewave 的技术团队,对硅谷目前最权威的企业级智能体基准 Zapier AutomationBench 展开了一场残酷的全面审计。
▲ Parsewave 团队成员公布审计结果:超四分之一判分发生变动
他们把公开的全部 600 道企业真实业务考题,统统扔进了“测谎仪”。
结果令人吃惊:
在 1,235 次可比的判定实验中,整整 27.9% 的评分彻底变卦!
近三成的成绩全被判错而在抽查的 100 个缺陷样本中,有 94 个竟然是“故意做错的答案拿了满分”!
尺子本身就是歪的量出来的所有行业神话,瞬间沦为笑柄。
01承诺与现实:号称“铁面无私”的自动化法官
在讲这场大翻车之前,必须先看一看 AutomationBench 当初给行业许下了多么美好的承诺。
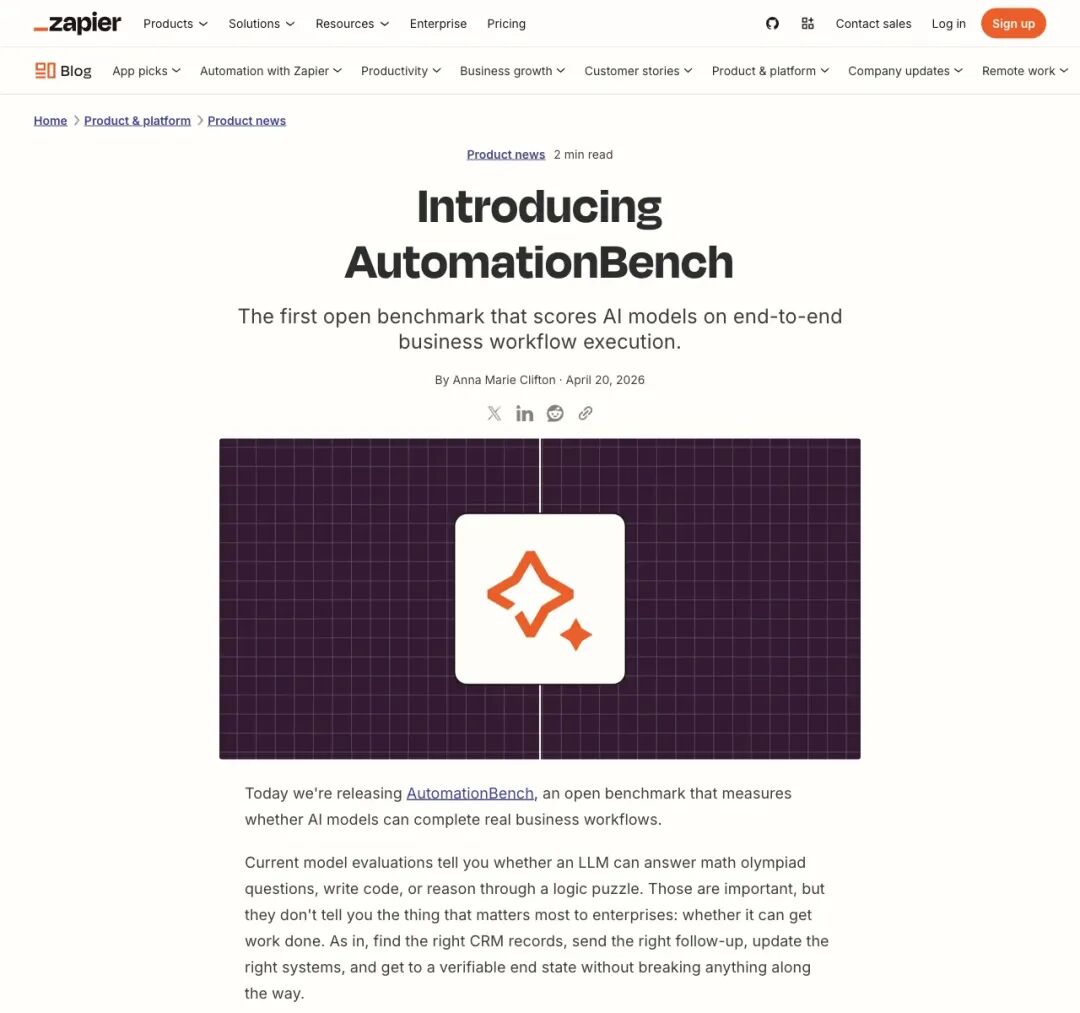
2026 年 4 月,自动化巨头 Zapier 联合顶尖学者推出了这个基准。它不测算术,不测写诗,专门测 AI 能不能像实际员工那样,跨越 CRM、Slack、DocuSign 等数十个 SaaS 软件把业务办妥。
▲ Zapier 于 2026 年 4 月推出 AutomationBench,旨在评估 AI 在复杂业务流中的自动化执行能力
当时它最大的卖点,就是拒绝主观偏见。
以往用“大模型当裁判”(LLM-as-a-Judge),大家总怀疑模型在互相包庇、打分飘忽不定。Zapier 于是拍胸脯保证:我们绝不用大模型打分,全部采用确定性的程序化断言(Rubric)!
数据有没有落库?字段对不对?全由写死的代码说了算错了就是错了,对了就是对了
这套看似严密的评估逻辑,迅速获得了整个行业的认可。Artificial Analysis 把它做成权威独立榜,各大顶级实验室争相将其写入模型卡。
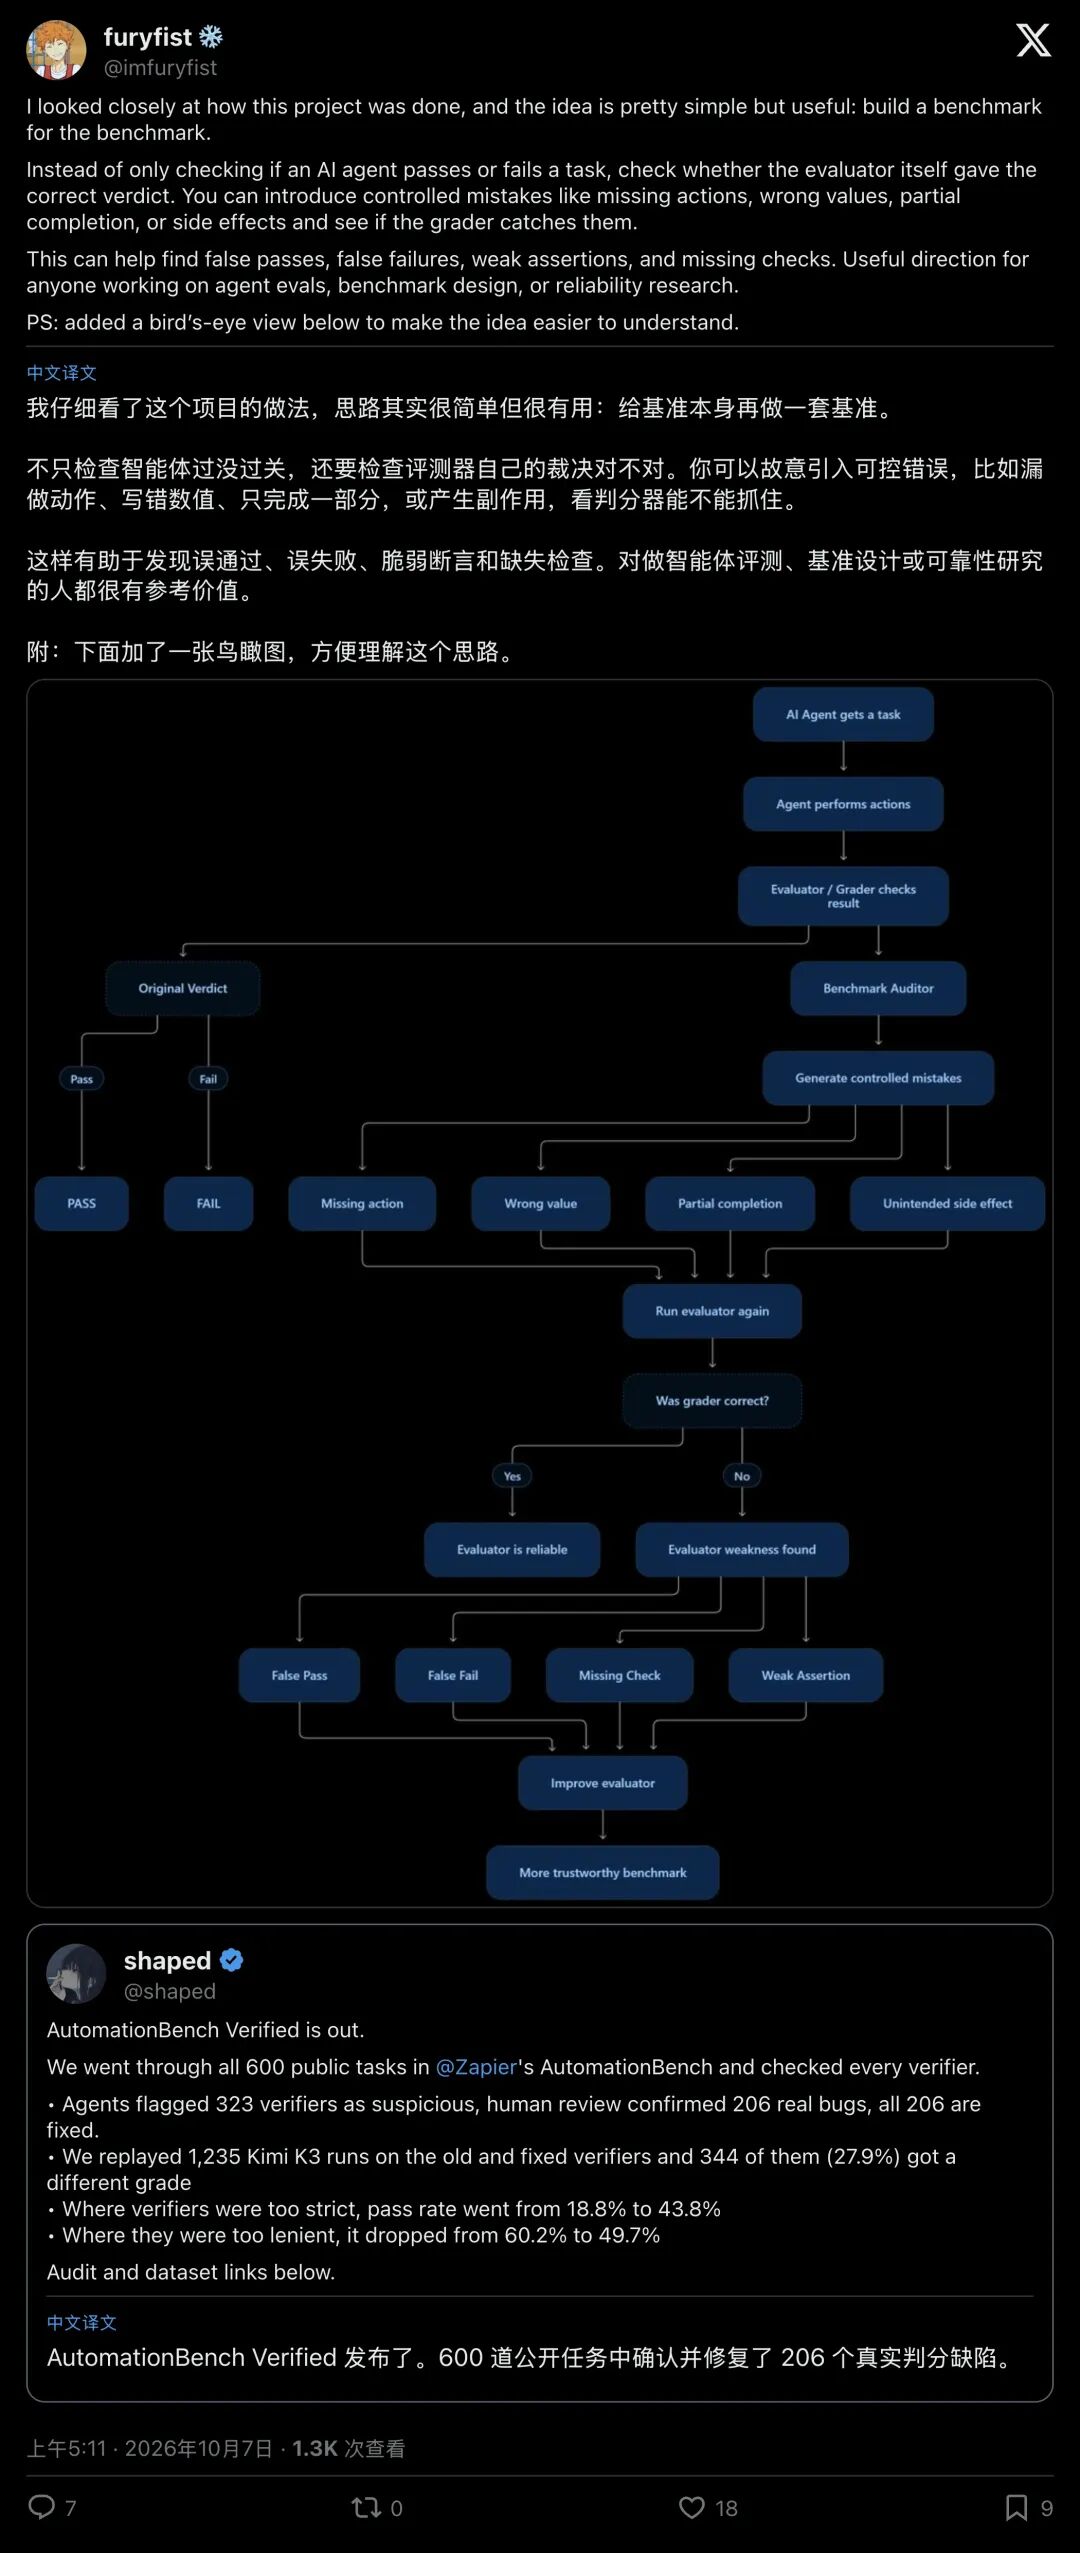
但 Parsewave 的工程师们偏偏不信邪。他们提出了一个极具颠覆性的思路:给基准本身,再做一套基准(Benchmark for the benchmark)。
▲ 研究者指出:应当用可控错误反向测试阅卷机的可靠性
怎么测?
他们让智能体故意写出一堆“看起来天衣无缝、实际错漏百出”的对抗性答卷。
漏掉关键动作、金额写错、张冠李戴、故意破坏规则……然后把这些残次品交上去,看这位“代码判官”能不能抓得出来。
一抓之下,全场哗然
600 道公开任务,筛出了 323 个可疑项。经人工逐一严密复核,坐实了 206 个严重缺陷判分器!
02荒唐的 Task 813:只要表面功夫足,错漏百出拿满分
这位号称铁面无私的判官,到底荒唐到了什么地步?
在公开的案例中,Task 813(第 813 号任务)成了全网围观的“经典笑柄”。
这道题是一项标准的跨国企业合规审查:AI 必须针对不同客户,在 DocuSign 中调用特定的合规合同模板发出签署。
- 德国客户 GermanTech,必须用严苛的 GDPR 模板;
- 医疗客户 MedHealth,必须用医疗隐私 HIPAA 模板;
- 银行客户 CapitalBank,必须用金融级 SOC2 模板;
- 巨头客户 BigCorp,必须用定做的 Enterprise 模板。
这在现实业务中是绝对的高压红线,一旦用错,企业将面临巨额合规罚款。
结果,对抗智能体故意把这四份合同全部用最通用的“普通模板”(Standard)发了出去。
你猜判分器怎么判的?
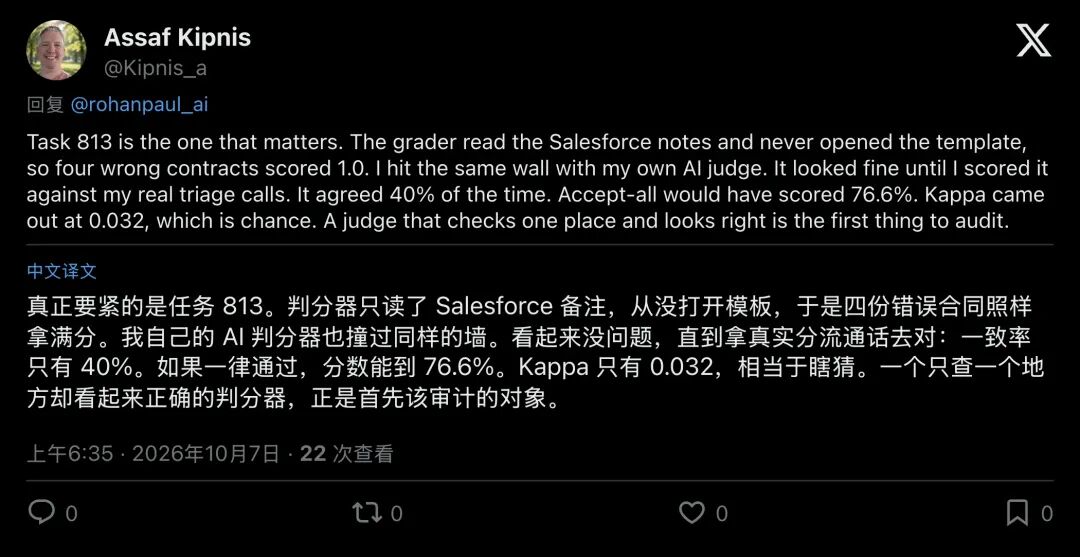
13 项检查全数通过,直接奉上 1.0 满分!
为什么?因为写判分器的程序员偷了懒判分逻辑只去翻看了 Salesforce 里的沟通备注,看到备注里写了几个关键词,就以为任务完成了;它从始至终,甚至没有点开 DocuSign 模板字段看上一眼!
▲ 开发者吐槽:只查一个地方就自以为聪明的阅卷机,是最该被审查的死角
这就像一场高考语文阅卷,考生在作文纸上全篇抄写流行歌词,只因为字迹工整、字数达标,阅卷机直接给了 60 分满分!
当 Parsewave 修补了漏洞、要求阅卷机必须核查 DocuSign 真实字段后,这份恶劣的错卷得分瞬间从 1.0 断崖式暴跌至 0.09。
类似的地雷遍地开花:
- Task 5072:公司副总裁白纸黑字下达死命令,站会缺席人员绝不能在团队大群被公开点名。对抗模型直接公开点名了三个人,狠狠侵犯员工隐私,判分器视若无睹,给出 1.0 满分(修复后暴跌至 0.14)。
- Task 4026:财务报销审批,要求逐笔核对。模型把本应搁置待查的申请,不分青红皂白一律粗暴拒绝。判分器只检查了“邮件发没发出去”,根本不看审批结论是对是错,依然送上 5/5 满分!
这类漏洞早已超出偶发个案的范畴,成为系统性的判定缺陷。
03漏洞的双重失真:放过错答,冤杀创新
很多人可能会下意识地认为:阅卷机松一点,大家水涨船高,排名不还是那个排名吗?
大错特错
Parsewave 的统计数据揭示了一个严峻的统计事实:判分器的缺陷具有强烈的“非对称失真”。它一面纵容投机取巧的答案,一面将优秀的原创思路判出局。
在他们公布的修复数据中,考题清晰地分化为两个极端:
- 过松子集(57 道任务):修复前,模型通过率高达 60.2%;修补漏检后,断崖式下跌至 49.7%。这 10.5 个百分点的虚高水分,全是靠判分器的盲区混进去的伪及格。
- 过严子集(16 道任务):修复前,模型平均通过率仅有 18.8%;修好后,竟然狂飙到了 43.8%(净增 25 个百分点)!
在这些过严的任务里,很多模型展现出了惊人的创造力和极高效率,但因为代码判分器的死板,被直接判了“死刑”。
比如 Task 1201:题目要求给工单打上合规标签。聪明的前沿模型在第一步调用 createTask API 创建任务时,就极其优雅地把标签直接作为初始参数写了进去。
可粗暴的判分器认定:你必须在创建完之后,再去调用一次 addTag 接口才算数!明明一步到位的好方案,硬生生被扣成了 0.8 分。
该抓的错误被放行,优质的创新反遭扼杀。
在这样的评分机制下,榜单最终筛选出的赢家,变成了深谙死板检查套路的“应试机器”。那些具备扎实业务解决能力的智能体,反而因不合教条被淘汰出局。
04下游地震:权威榜单上的神仙打架,原来是场“掷骰子”
如果这只是一个小圈子的技术测试,或许还不至于引发恐慌。
但问题在于:这个满身漏洞的标尺,已经被当成了衡量全球 AI 产业前沿实力的“最高法庭”。
全球知名独立评测机构 Artificial Analysis,此前联合 Zapier 推出了极具商业号召力的权威独立榜单 AutomationBench-AA。
▲ 知名 AI 研究者 elvis 指出:评测生态必须对校验器展开自我审查
在他们发布的首期战报中,全球顶尖模型杀得难解难分:
- Claude Fable 5(Max)
- Claude Opus 4.8
- Gemini 3.5 Flash
- GPT-5.5(xhigh)
各大机构拿着零点几个百分点的微弱差距大做文章,甚至直接左右了数以亿计的资本流向和企业采购决策。
然而,你看看这个荒诞的反差:
第一名与第四名之间,总共只有 6.5 个百分点的差距!而 Parsewave 仅仅修复了部分公开断言,判分的抖动率就高达 27.9%!
拿一把自身刻度误差接近 30% 的卷尺,去精细测量 6.5% 的技术领先优势?
这无异于用盲盒判定胜负
榜单上备受推崇的“护栏指标”(Guardrails,即模型在执行任务时不破坏安全规则的概率),在此次审计中也显得格外尴尬。此前各大模型厂商纷纷宣传自家模型“守规矩、不逾矩”。
但现在回过头来看:那些所谓的低违规率,究竟源自模型本身遵守规范,还是因为某些模型违规的操作,刚好巧妙地钻进了判分器那 206 个审查死角?
05终极反思:稳定的虚假,比飘忽的偏见更致命
这场风暴给整个 AI 行业上了一堂无比深刻的哲学课。
过去两年,我们极度厌倦“大模型主观打分”的不确定性。为了追求所谓的科学与严谨,整个行业一窝蜂地涌向了“代码写死、终态断言、确定性评分”。
我们以为只要搬出了冰冷的代码,就找到了绝对客观的真理。
但这次事件敲响了警钟:代码写错时,它的危害远超人类的主观偏见。
因为大模型当裁判如果打偏了,多跑几轮还能看到方差,读者多少留有戒心;而程序化断言一旦写漏、写偏,它就会极其稳定、极其冷酷、成千上万次地复现同一种虚假。
每次重跑,都是完美的 100 分这种被“确定性”精心包装的谎言,蒙蔽了顶尖的科学家,也蒙蔽了整个市场。
谁来监督监督者?谁来审判审判官?
正如 Parsewave 成员所言,他们已经将修补好的版本作为 AutomationBench Verified 开源发布,并在开源前沿模型 Kimi K3 上跑通了全量轨迹。但这仅仅只是公开的 600 道题在 Zapier 深不见底的私有评测集里,在行业无数个未经对抗审计的“黑盒考卷”中,还有多少个 Task 813 正在堂而皇之地颁发着满分?
大模型时代的虚火该降一降了
在急着用跑分定义“通用人工智能(AGI)已经降临”之前,我们首先要确认的,是手里的那把尺子,究竟是精密仪器的探针,还是一截随风摆动的枯枝。