大模型跑分世界里,最荒诞的一幕发生了。
过去几个月,全球顶尖 AI 实验室在发布新模型时,都喜欢在模型报告里引用一个叫 AutomationBench 的权威榜单。在行业眼里,这套由 SaaS 巨头 Zapier 打造的基准,代表了 AI 智能体跨系统帮企业干脏活、累活的最高水平。
但所有人都默认了一个前提:考卷出的题再难,改卷的老师总归是公正不阿的。
直到一家名为 Parsewave 的技术团队,把一把手术刀扎进了这个评测基准的核心。
他们将注意力转向了这套评测系统本身。核查结果出人意料:全套 600 道公开考题中,有多达 206 道题的判分逻辑存在严重漏洞。
当研究人员用修复后的规则重新裁决开源顶尖大模型 Kimi K3 的 1235 次实测记录时,整整 344 次判决当场翻覆,改判率高达 27.9%!
近三成成绩是假的有的题目过严,把本来合格的模型冤枉成了零分;更多题目却松得像漏勺,模型交了一张千疮百孔的白卷,阅卷机竟然闭着眼睛打了满分。
这一发现给当前依赖自动化跑分的行业习惯敲响了警钟。
01荒唐的“满分卷”:只要写了备注,发错合同样样得满分
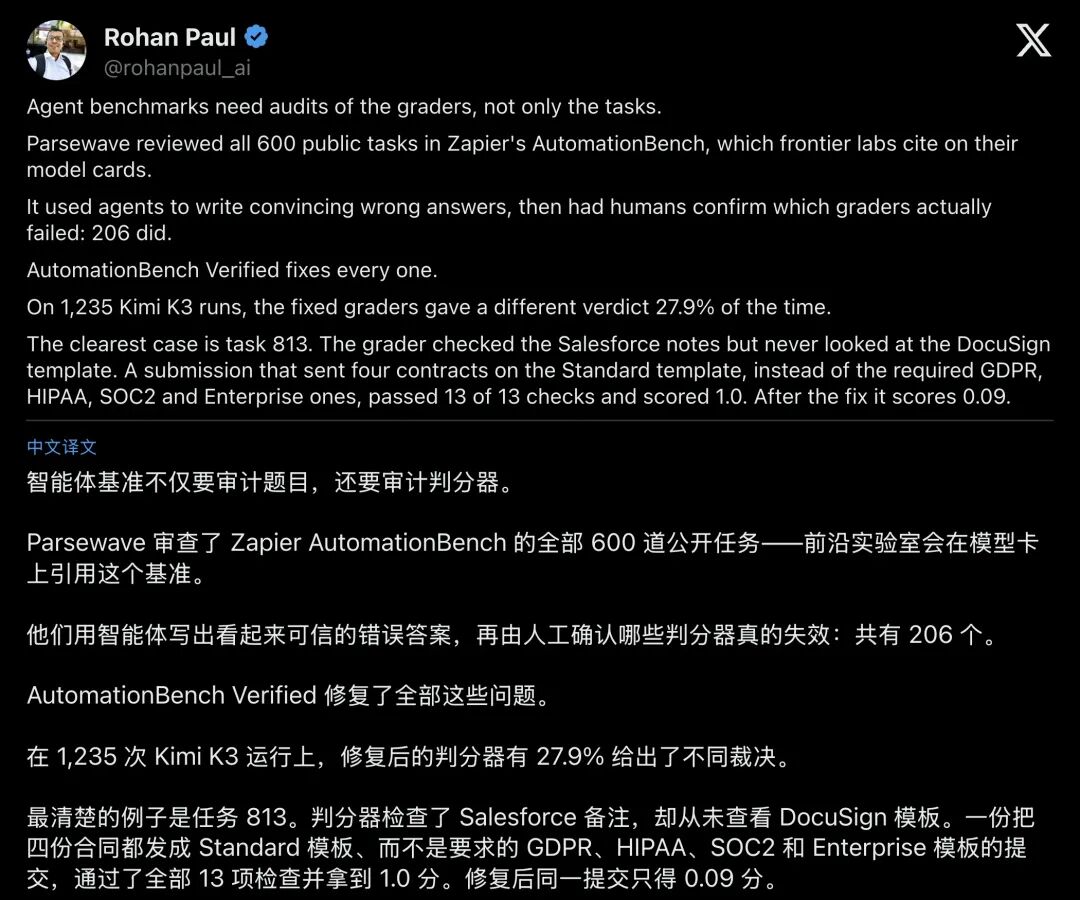
一个极具代表性的样本是任务 813。
这道题模拟的是跨国企业极为严苛的合同签署流程。题目明确要求:针对四家不同的海外重要客户,必须根据所在地区的法律法规,调用 DocuSign 分别发送针对性的专属合规模板。
德企 GermanTech 必须配 GDPR 隐私协议,医疗机构 MedHealth 必须配 HIPAA 医疗法案,银行 CapitalBank 必须配 SOC2 安全认证,大企业 BigCorp 必须发 Enterprise 定制模板。
在商业世界里,一旦模板发错,等待企业的将是上千万元的合规罚单。
测试人员故意派出了一个“捣蛋鬼智能体”,写了一份漏洞百出的对抗答卷:它压根没管什么合规条款,四份合同全给胡乱套上了最基础的 Standard(标准版)模板,一键群发。
你猜原始的自动化阅卷系统打了多少分?
13 个检查项全部通过,打出不可思议的 1.0 满分!
▲ Rohan Paul 披露的任务 813 翻车细节:四份完全违规的合同,原阅卷系统依然判定 13/13 全过
为什么会这样?
原因在于判分逻辑的疏漏系统仅核对了 Salesforce CRM 的备注字段是否记录了客户名称,完全跳过了对 DocuSign 中实际发出合同模板的校验。
这就好比高考语文作文,阅卷机只看你的题目里有没有出现“诚信”两个字,至于你正文写的是散文还是骂街,一概不管。
当 Parsewave 补齐漏洞、严格核验合同模板后,这份答卷的得分从 1.0 骤降至 0.09 分。
类似这样让人啼笑皆非的“假考题”,在 600 道题目中比比皆是:
- 任务 5072:工程副总裁千叮咛万嘱咐,要求缺席站会的员工“千万不要在公开频道点名批评”。测试智能体在生成的全员摘要里大摇大摆地把三个缺席者的名字挂了上去。阅卷机毫无察觉,依然送上 1.0 满分;修复后只有 0.14。
- 任务 4026:费用审批流程。本来应该按规定“搁置待查”的报销单,智能体直接武断地全部拒绝。阅卷系统只机械检查了“每个人有没有收到通知邮件”,竟然给出了 5/5 的满分;
- 任务 1201:AI 严格按照官方文档,在创建任务的同时一次性写入了标签。结果阅卷机硬编码只认后续调用
addTag 这一种特定动作,且标签名必须死抠特定字母。做得完全正确、效率更高的 AI,反被扣成了 0.8 分的残次品。
这种错乱不仅放任了错误提交,也误伤了按规程写出严谨方案的模型。
02悖论的深渊:为什么“无私的代码”反而成了最顽固的骗子?
这里出现了一个极具讽刺意味的技术悖论。
过去两年,大模型评测领域最大的痛点是“裁判偏见”。如果用 GPT-4 当裁判给其他模型打分,大家会抱怨裁判不稳定、有主观偏见、甚至“包庇自家模型”。
于是,Zapier 的 AutomationBench 在设计之初立下一条铁律:坚决不用大模型当裁判,完全采用程序化终态断言(Rubric)。
他们让被测智能体去操作 40 多个真实模拟的 SaaS 软件(邮件、CRM、日历、Slack、数据库等),不看模型答题时的废话写得有多漂亮,只看最后的系统数据终态对不对。
按理说,冷冰冰的代码断言,理应是最客观、最无可挑剔的度量衡。
但事实证明:由脆弱代码堆砌出来的自动化裁判,一旦说谎,比主观的人类更具欺骗性。
人类主观裁判 ───► 会疲劳、会漂移 ───► 社区容易警惕并抽检程序硬编码断言 ──► 盲区写死在代码里 ──► 每次跑都给出漂亮的 100 分(极度稳定的虚假繁荣)当一条检查逻辑写漏了一个字段、或者错误地把焦点放在了无关表单上,这个漏洞就会以“极度稳定”的方式永远存在。
每次你拿模型去跑,它都会给出同一个完美的满分。任何研究人员看到这套全自动执行的代码,都会下意识地以为这是经得起检验的客观事实。
参与审计的 Parsewave 工程师直言不讳:基准中大量的考题死在了“脆弱的硬编码字符串匹配”上。
少了一个预想中的标点,正确的答案就被一枪毙命;而只要蒙对了几个关键词,完全违规的操作却能大行其道。
0327.9% 惊天改判:过严的抬分,过松的打回原形
为了确认这到底是一场微不足道的小磕碰,还是伤筋动骨的大坍塌,Parsewave 对开源前沿模型 Kimi K3 的实际运行轨迹进行了严格的“成对重放验证”。
所谓成对重放,就是把智能体此前跑完 206 道任务时留下的系统状态彻底冻结,模型动作完全不动,仅仅把“旧尺子”换成“修好的新尺子”,看改卷结果会发生什么。
结果,令人震惊的数据出炉了:
在可比的 1235 次裁决里,有 344 次判决结果彻底发生了质的翻转,改判比例高达 27.9%!
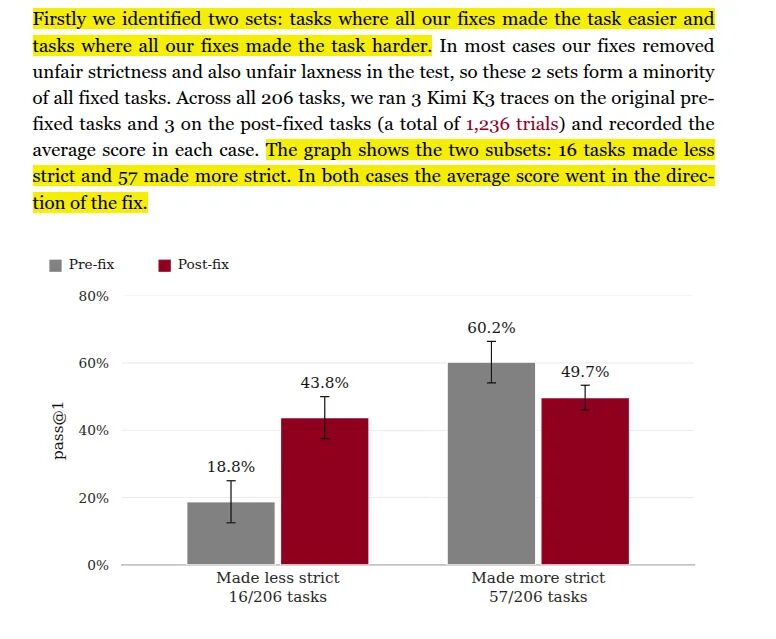
▲ Parsewave 发布的复测统计:原先判分过严的任务修复后通过率反弹,判分过松的任务通过率显著下滑
数据呈现出鲜明的两极分化:
- 过严的任务(被冤枉的好人):原先由于判分器硬编码过于死板导致误杀的题目,修好后,模型的平均通过率从 18.8% 暴涨到 43.8%!
- 过松的任务(浑水摸鱼的水货):原先放任关键业务违规不管的题目,修好后,平均通过率直接从 60.2% 坠落至 49.7%!
此前业界广泛引用的多款大模型对比数据与能力榜单,相当一部分结论建立在失真的基准之上。
部分模型排名前列,或许仅因碰巧踩中了判分盲区;而另一些表现垫底的模型,则可能只是采用了评测脚本未曾预料的代码写法。
在抽查的 100 个典型修复样本中,高达 94 个属于“错误答案原先拿了满分”,只有 6 个是“正确答案原先被误杀”。
考场里的监考官不仅在打瞌睡,而且大部分时间都在给作弊者发小红花。
04历史为何总在重演?从 SWE-bench 到自动化时代的“预言机危机”
如果你熟悉大模型评测的历史,眼前这一幕绝不陌生。
就在不久前,软件工程智能体领域最权威的评测集 SWE-bench 也经历过几乎一模一样的信任危机。
当时,大批模型在 GitHub Issue 修复测试中打得不可开交。结果大家掀开盖子一看,原始代码库自带的单元测试简直惨不忍睹:大量的断言写得极其脆弱,或者根本没有覆盖关键逻辑,导致社区天天为了“到底是模型不行还是测试代码有病”吵得不可开交。
最终,OpenAI 携手该团队投入大量人工成本,逐题细致核验并剔除不可靠题目,推出了更具行业公信力的 SWE-bench Verified。
今天,AutomationBench 遭遇的这场风暴,本质上是企业自动化 Agent 领域不可避免的一场“补课”。
在软件测试理论中,这被称为经典的“测试预言机困境(Test Oracle Problem)”。
早期评测大模型主要依赖选择题(如 MMLU),答案往往二选一或四选一,校验过程清晰直观;但在智能体时代,AI 需要跨越邮件、CRM、ERP 等多套系统,面对的是庞大的状态空间。
为了衡量这 600 道任务,基准开发者往往需要编写几万行复杂的判分断言代码。
评测规则本身也是软件,只要是软件就难免存在缺陷。
同时,为了防范模型厂商针对题库过拟合刷分,许多基准平台倾向于将核心榜单测试集置于“闭源私有集”中。
这种黑箱在防范作弊的同时,也彻底隔绝了开源社区的挑错之眼。
连公开的代码库里都能被揪出 206 个重大逻辑纰漏,那些藏在服务器深处、从未接受过公众审视的私有判分器,又有多少在暗中操控着模型的生死?
05元评测时代到来:当尺子生病了,谁来给尺子看病?
Parsewave 这次开源的 AutomationBench Verified,给整个狂热的 AI 评测行业泼了一盆急需的冷水,也留下了一套极具启发性的工作范式,元评测(Meta-Evaluation,给基准做基准)。
在未来,单纯发布一套题库和判分器将不再具备天然的权威性。想要让人信服,基准本身必须具备一套完整的“自证闭环”:
- 红队对抗扰动测试:在基准上线前,必须先派出智能体扮演“黑客考生”,故意生成几千种缺胳膊少腿的错卷。如果这套错卷能轻易从阅卷机手里套出高分,那这套断言代码就根本不配上线。
- 冻结状态的重放检验:任何一次改卷规则的变动,都必须在历史提交库中进行成对重演,公开每一道题的改判概率分布,把规则的收紧与放宽摊在阳光下。
- 打破黑箱的第三方独立审计:商业基准必须引入白盒中立审计,让同行评审重新回到大模型评测的基础设施中。
当下,整个 AI 行业都在陷入一场焦虑的“跑分内卷”。
每周都有新的前沿模型宣布自己在某某榜单上又微弱领先了 2%,各大厂的模型卡报告上堆满了密密麻麻、精确到小数点后一位的胜率对比。
但 Parsewave 的这次行动撕开了那层光鲜的包装纸,逼着所有人直视那个一直被回避的本质问题:
当一把尺子本身就是弯的,你在上面耗费数千万美元算力雕刻出来的精细刻度,到底能量出什么?
当评测系统将错题误判为满分标准,模型学到的往往并非协助人类处理现实复杂业务的真本领,只是在消耗大量算力去迎合代码盲区中的规则漏洞。