从理论到真实图评测:我们在 NeuG 里实现了 BMSSP
- 更新时间 2026-10-08 19:31:55
受近期最短路理论进展启发,我们在 NeuG 中实现了 STOC 2025 最佳论文提出的 BMSSP,并在公开 Graphalytics 数据上与 frontier 和 Dijkstra 进行了实测。
2026 年 9 月 20 日,Vals AI 发布了《A Faster Shortest Path Algorithm》[1]。他们让 10 个 Claude Opus 5.5 agent 协作搜索新算法,15 小时、733 条消息之后,得到了 C-HD,并用 Lean 完成了形式化证明。对一类稀疏图,C-HD 把理论界又向前推了一步。
这项工作不只改进了渐进界,还展示了一种新的研究工作流:agent 寻找算法,Lean kernel 检查证明。但 Vals AI 也明确说明,他们没有在大型真实图上跑 benchmark,形式化构造的常数也非常大。理论上更快,还不等于已经有了一份跑得更快的工程实现。
我们更关心另一个问题:理论上更优的 SSSP 算法,放进真实图数据库以后,用公开数据和现有后端对比,实际会跑得怎么样?
但我们最后没有直接实现 C-HD。它的理论优势目前只在比本文测试数据稀疏得多的图上得到了证明,现有成果的重点也是形式化验证,不是一套可以拿来跑大图测试的实现。
我们选择先复现去年 STOC 最佳论文里的 BMSSP。它已经过同行评议,论文明确给出了伪代码、数据结构和正确性不变量,又直接处理 NeuG 已经支持的有向非负实数权图。这让它更适合拿来做第一轮工程实验。
01 · 去年那篇 STOC 最佳论文
1956 年,Edsger Dijkstra 为 ARMAC 计算机的一次公开演示构思了最短路算法;论文到 1959 年才发表[2]。1984 年,Fredman 和 Tarjan 在 FOCS 提出 Fibonacci heap[3],把非负实数权重 SSSP 的经典复杂度推进到 O(m + n log n)。此后四十多年,这个界一直是稀疏图上的标杆。
2025 年 4 月,Ran Duan、Jiayi Mao、Xiao Mao、Xinkai Shu 和 Longhui Yin 在论文《Breaking the Sorting Barrier for Directed Single-Source Shortest Paths》[4] 中给出了确定性的 O(m log^(2/3) n) 算法。它处理比较—加法模型中的有向图,边权可以是任意非负实数;对于稀疏图,这是第一次越过 Dijkstra 的 O(m + n log n) 界。论文收入 STOC 2025[4],并获 Best Paper Award[5]。
这项结果在 2025 年引起了不少算法圈以外的关注。清华大学发布了成果介绍[6],Quanta Magazine[7]写了一篇长篇报道,之后又由 WIRED 转载。讨论的核心并不是“又造了一个更快的 heap”,而是一个更基础的问题:求最短距离,真的需要把所有顶点按距离排好顺序吗?
我们把论文中的 BMSSP 思路接进了 NeuG GDS extension,并拿两张 LDBC Graphalytics datagen 图做了验证。结果先放在这里:BMSSP 相比 NeuG 原有 frontier 后端降低了 4.5% 和 13.5% 的耗时;相比 NeuG 当前的 Dijkstra 后端,分别快 13.6 倍和 13.5 倍。
这些数字有明确的适用范围。两张图都走了自适应实现的 frontier fast path,没有进入递归 fallback;NeuG 当前的 Dijkstra 核心路径也是串行的。因此,这组实验说明的是“当前 NeuG 实现之间的差距”,不是对论文理论复杂度的完整复现实验。
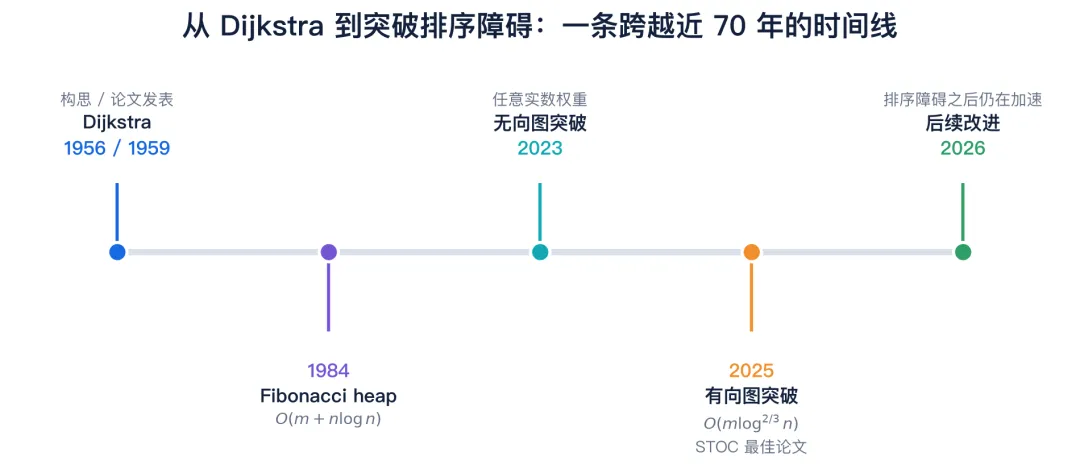
图 1:Dijkstra 于 1956 年构思算法、1959 年发表论文;Fibonacci heap 的会议论文发表于 1984 年。2023 年,随机算法先在无向图上越过排序障碍;2025 年的新算法把结果扩展到有向图,并且是确定性的。
02 · 问题出在“排序”,不只是优先队列
Dijkstra 的执行过程很熟悉:把候选顶点放进最小优先队列,每次取出距离最小的顶点,再松弛它的出边。这个顺序很好用,也带来一个额外结果——顶点按照最短距离依次被确定。
SSSP 本身只要求源点到每个顶点的距离,并不要求输出这份全序。论文利用的就是这一区别。它不再让所有候选顶点争夺“下一个全局最小值”,而是把前沿分成有界的距离层,在层内只维护后续计算真正需要的偏序关系。
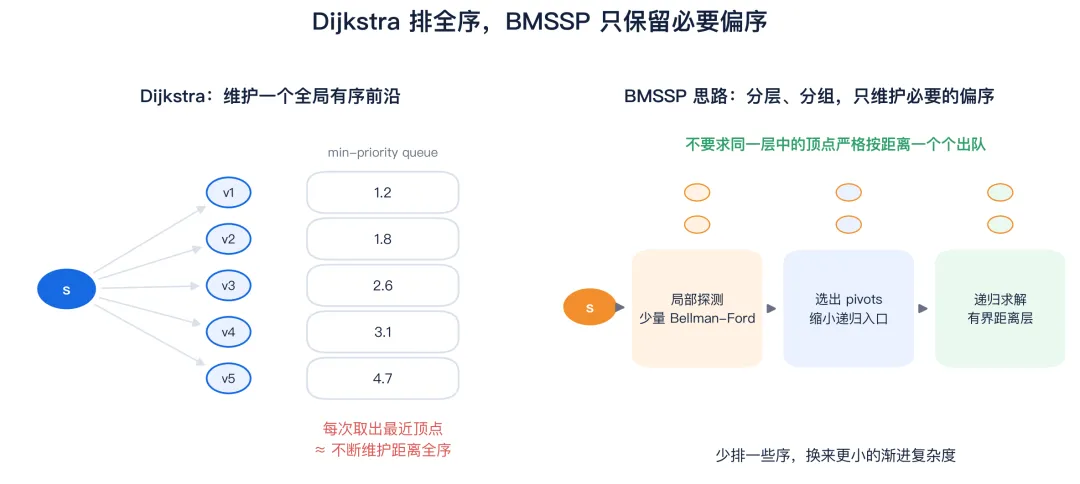
图 2:左侧的 Dijkstra 持续维护全局最小候选;右侧只保留局部探测、pivot 和递归分层所需的顺序。
论文还重新使用了 Bellman–Ford。它不依赖距离排序,但如果在整张图上反复跑到收敛,代价会很高。新算法只做有限轮松弛,用这些结果找出 pivots:能够代表较大一片最短路树的入口。随后,算法围绕这些 pivots 递归求解 Bounded Multi-Source Shortest Path,也就是 BMSSP 子问题。
几个关键步骤可以概括为:
1. 做少量 Bellman–Ford 松弛,得到一片局部可达区域; 2. 从中筛出 pivots,减少真正进入递归的源点; 3. 按距离边界分批取出前沿,而不是逐点完成全局排序; 4. 递归求解每个有界子问题,再合并已经确定的距离。
取 k = floor(log^(1/3) n)、t = floor(log^(2/3) n) 时,论文证明总时间为 O(m log^(2/3) n)。2023 年的无向图结果是随机算法;这篇工作同时给出了有向图突破,并成为第一个即使在无向图上也越过该界的确定性算法。
03 · 在 NeuG 里怎么实现
理论算法默认可以为图建立专用结构,数据库执行器面对的条件不同。NeuG 已经有 CSR、属性列和图投影;如果每次查询都重新构图,额外的内存访问很可能盖过算法收益。论文中的数据结构强调渐进界,工程实现还要考虑 cache locality、原子更新和线程调度。
我们最终采用了两段式执行路径。
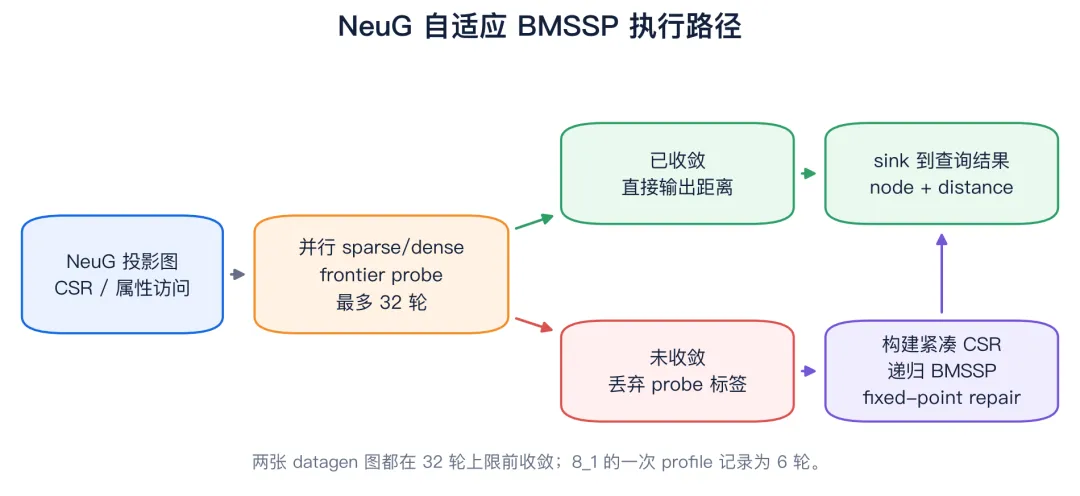
图 3:先在 NeuG 投影图上运行有上限的并行 frontier probe。收敛就直接返回;超过 32 轮仍未收敛,才丢弃 probe 标签、构建紧凑 CSR,并进入递归 BMSSP 与修复阶段。
第一段是最多 32 轮的 sparse/dense frontier probe。活跃顶点少时,从前沿向外推;活跃集合超过顶点数的 5% 时,切换为 dense pull。并行路径使用 concurrency 指定的线程数。probe 收敛后,距离可以直接返回,不需要再物化一份 CSR。
第二段只在 probe 未收敛时执行。实现会先丢弃 probe 的中间标签,重新初始化状态,然后构建紧凑 CSR,执行 pivot、frontier 和 base case 递归。最后的 fixed-point repair 会继续传播仍然有效的松弛,直到没有边能够改进距离。
这层 repair 是正确性保护,也是当前实现与论文算法的重要差异。它保证简化的数据结构不会把部分收敛结果交给用户,但也改变了理论工作量。当前实现不具备论文中的渐进复杂度保证。
两张性能图都在 32 轮 probe 上限前收敛,没有构建 fallback CSR。现有 profile 记录中,datagen-8_1-fb 用了 6 轮。也就是说,本文的性能数据主要测到的是自适应 fast path,递归 BMSSP 目前只有正确性测试,还缺少有代表性的性能样本。
04 · 调用方式仍然是 sssp
这次没有增加独立过程名。调用入口仍是 sssp,通过 algo 选择后端:
CALL sssp('social', { source: '6', weight: 'weight', directed: false, concurrency: 8, algo: 'bmssp'})YIELD node, distanceRETURN node.id, distance;目前支持四个取值:
• auto:默认值;普通距离查询走 frontier,需要谓词或path时走 Dijkstra;• frontier:NeuG 原有的并行 sparse/dense frontier 实现;• dijkstra:支持谓词和路径输出的优先队列实现;• bmssp:本文的实验性自适应后端。
05 · 先把正确性测扎实
最短路的错误通常不明显:一个顶点少松弛一次,结果仍可能看起来“差不多”。因此测试不只比较几个手写样例,而是分成四层。
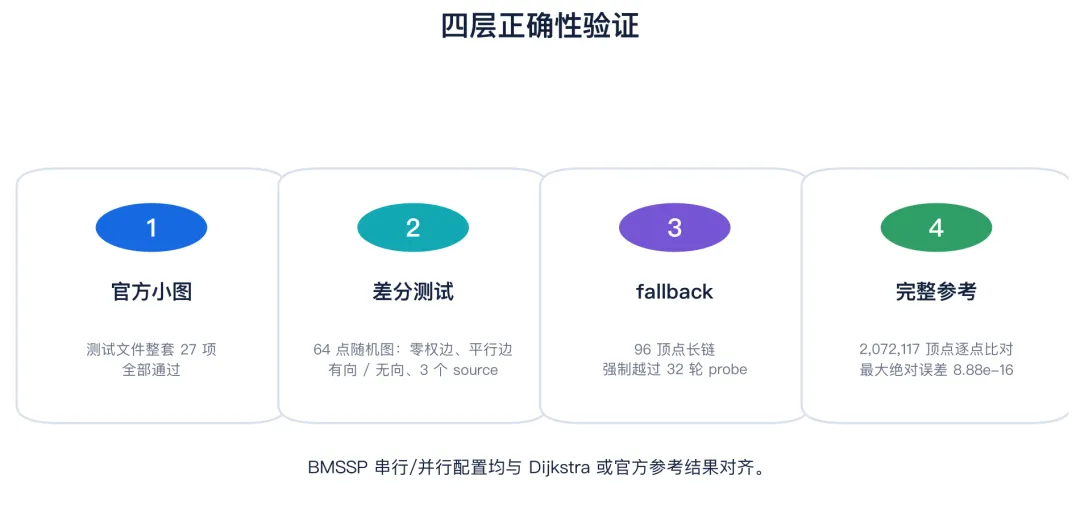
图 4:小图覆盖接口和官方结果,随机图覆盖边界条件,长链强制进入 fallback,完整
datagen-8_1-fb再逐点对照官方 SSSP 输出。
• tests/test_graphalytics.py整套测试结果为27 passed;其中 SSSP conformance 对frontier、dijkstra、bmssp使用同一份官方参考输出。• 固定随机种子的 64 顶点图覆盖有向/无向、3 个 source、零权边和平行边;BMSSP 的 1 线程和 4 线程结果均与 Dijkstra 一致。 • 96 顶点长链会超过 32 轮 probe 上限,从而真正进入 fallback;串行和并行配置均与 Dijkstra 完全一致。 • datagen-8_1-fb的 2,072,117 个顶点全部逐点比较,最大绝对误差为8.88e-16。
最后一个误差的量级接近双精度机器精度,符合不同松弛顺序可能产生的舍入差异。
06 · 性能结果
测试机器是 MacBook Pro(Mac16,8),Apple M4 Pro 12 核(8P + 4E)、48 GB 内存,系统为 macOS 15.7.9 arm64。NeuG 使用 8 线程。每个后端预热 1 次,再计时 5 次,报告中位数。
查询会完整执行 SSSP kernel,但只返回一行计数,避免把数百万行结果序列化到 Python。首次 COPY FROM、图投影和 checkpoint 不计入算法时间。
对照组中,frontier 是 NeuG 原有的并行 SSSP 实现。它只处理上一轮距离发生变化的顶点;活跃顶点少时向外 push,超过全图的 5% 后切换为 dense pull。这种做法接近带活跃集合的并行 Bellman–Ford:容易并行,但一个顶点可能在多轮中被反复处理。
datagen-8_0-fb | ||||
datagen-8_1-fb |
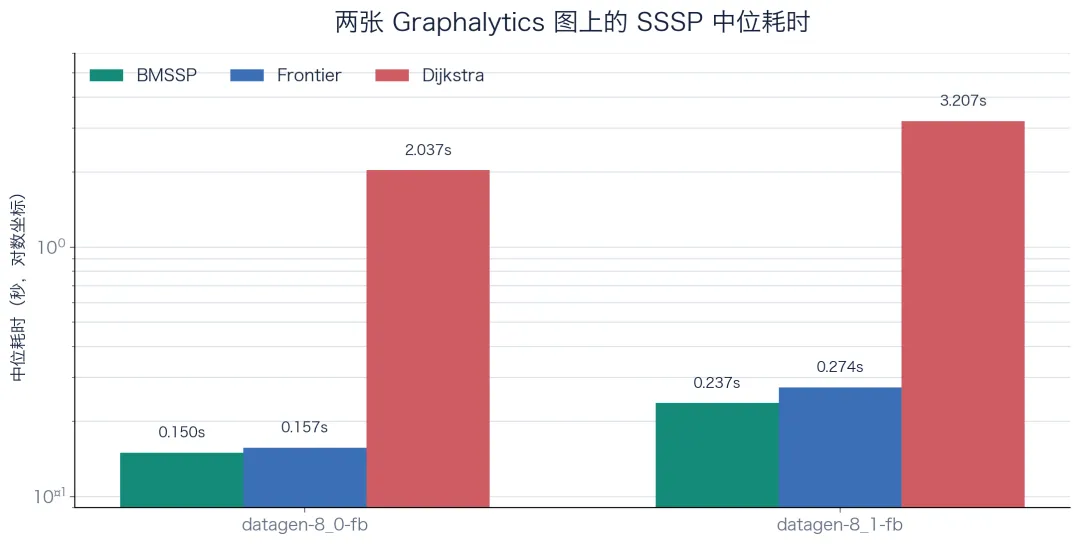
图 5:纵轴为对数坐标。BMSSP 的中位耗时分别是 0.150 秒和 0.237 秒;Dijkstra 分别是 2.037 秒和 3.207 秒。
datagen-8_0-fb | 0.150 s | ||
datagen-8_1-fb | 0.237 s |
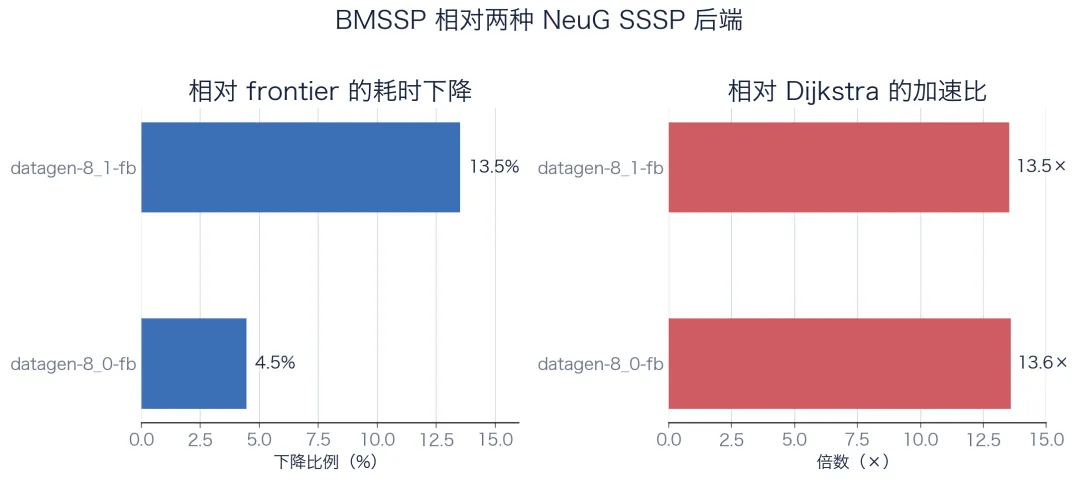
图 6:按 CSV 中保留到毫秒的中位数计算,BMSSP 相对 frontier 的耗时下降为 4.46% 和 13.50%,图中四舍五入为 4.5% 和 13.5%;Dijkstra/BMSSP 为 13.58× 和 13.53×,图中显示为 13.6× 和 13.5×。
三种查询虽然都传入 concurrency: 8,但 NeuG 当前 Dijkstra 后端的核心优先队列没有并行化。因此 13 倍的差距不能外推为“BMSSP 普遍比并行 Dijkstra 快 13 倍”。 更值得观察的是与 frontier 的比较:两者都利用并行图扫描,BMSSP 的 fast path 在第二张图上仍少用了约 13.5% 的时间。
datagen-8_1-fb 保存了五次原始计时:
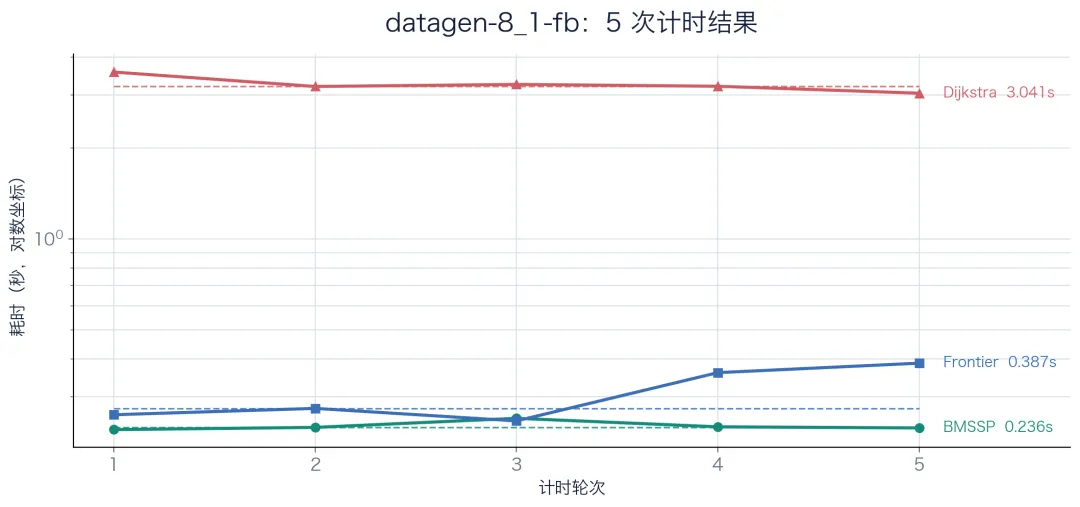
图 7:BMSSP 为 0.233、0.237、0.254、0.238、0.236 秒;frontier 为 0.261、0.274、0.249、0.360、0.387 秒;Dijkstra 为 3.574、3.202、3.252、3.207、3.041 秒。虚线是各自中位数。
第一张图只保留了中位数,没有保存五次逐轮日志,因此原始 CSV 对应的 run_seconds 为空。我们没有用估算值补齐它。
07 · Profile 看到的瓶颈
设置 NEUG_BMSSP_PROFILE=1 后,实现会记录 probe 轮数和阶段耗时。datagen-8_1-fb 的一次接近冷态运行输出为:
BMSSP probe profile: init_ms=5.17579 rounds=6 concurrency=8 compute_ms=283.403这次带 profiling 的查询总耗时约 0.311 秒,高于关闭额外日志后的 0.237 秒中位数,所以它只用于定位阶段,没有放进性能表。日志同时确认该图没有执行 CSR 构建、递归调用和 repair。
下一步真正需要测的是高直径道路网、稀疏有向图和长链。这些图会让前沿长时间保持稀疏,更可能触发 fallback。到那时才能分别回答 CSR 构建、pivot 搜索、递归 frontier 和 repair 各占多少时间。
08 · 当前实现还缺什么
这版后端仍然标记为 experimental,主要有五个原因:
• OrderedFrontier采用“每个顶点保留一个最优 key”的优先队列实现,并不是论文 Lemma 3.3 的完整 block data structure;• 没有执行论文中的显式常数出度图变换,以免每次查询扩大图; • fallback 目前是单线程,并行收益主要来自前置 probe; • fixed-point repair 保证正确性,但不满足论文原始的工作量分析; • 当前仅支持有限、非负权重,以及无谓词投影图上的距离输出。
此外,性能样本只有两张同族 datagen 图。它们足以证明这条执行路径值得继续优化,不足以说明所有图分布上都会领先。
2026 年 2 月,Duan、Mao、Shu 和 Yin 又发布了后续工作[8],继续改进有向 SSSP 的复杂度。排序障碍被越过以后,理论界显然还没有停下来;工程实现也一样,还有很长的优化清单。
09 · 复现实验
基准脚本本身不会编译 NeuG。先按照 benchmark README 的编译说明[9]编译当前 checkout 的 Python binding 和 neug_gds_extension,并设置其中给出的 PYTHONPATH。否则,Python 可能加载环境里已经安装的旧版 neug,测到的并不是刚修改的代码。
两张 Graphalytics 图、官方参考输出、SHA-256 清单和 ETL 脚本已经放到公开 OSS。下载脚本会校验归档、解压,并创建 NeuG COPY FROM 使用的 .csv 别名:
python3 extension/gds/benchmark/fetch_graphalytics_data.py \ --dataset all \ --output ./graphalytics-data然后运行三个后端:
python3 extension/gds/benchmark/graphalytics_bench.py \ --data-root ./graphalytics-data/datagen \ --db-root ./neug-bench-db \ --dataset datagen-8_1-fb \ --concurrency 8 \ --warmup-runs 1 \ --runs 5 \ --sssp-only \ --sssp-algos bmssp,frontier,dijkstra相关文件:
• NeuG 实现分支[10] • 完整技术报告[11] • 原始结果 CSV[12] • 公开数据与校验清单[13]
10 · 小结
这次实验最有价值的地方,不是简单地给 Dijkstra 换掉一个数据结构,而是把论文中的一个判断带进了数据库执行器:最短路需要准确距离,但不一定需要完整的距离顺序。
NeuG 当前的答案是自适应执行。低直径图先走已有存储结构上的并行 probe;只有 probe 处理不了的图,才承担递归 BMSSP 的额外构图成本。现有两张图证明 fast path 有收益,96 顶点长链证明 fallback 能给出正确结果。下一阶段则要在真正触发 fallback 的大图上,把正确性证据补成性能证据。
参考资料
• [1] Vals AI · A Faster Shortest Path Algorithm(2026-09-20):https://www.vals.ai/blogs/faster-shortest-path-algorithm • [2] Edsger W. Dijkstra · A Note on Two Problems in Connexion with Graphs(1959):https://doi.org/10.1007/BF01386390 • [3] Michael L. Fredman, Robert Endre Tarjan · Fibonacci Heaps and Their Uses in Improved Network Optimization Algorithms(FOCS 1984):https://doi.org/10.1109/SFCS.1984.715934 • [4] Ran Duan, Jiayi Mao, Xiao Mao, Xinkai Shu, Longhui Yin · Breaking the Sorting Barrier for Directed Single-Source Shortest Paths(STOC 2025, pp. 36–44):https://arxiv.org/abs/2504.17033 • [5] ACM SIGACT · STOC 2025 Best Paper Award(官方获奖名单页):https://www.sigact.sigact.hosting.acm.org/prizes/best_paper.html • [6] 清华大学新闻网 · 段然团队获 STOC 2025 最佳论文奖(校方报道):https://www.tsinghua.edu.cn/info/1175/118821.htm • [7] Ben Brubaker · New Method Is the Fastest Way To Find the Best Routes(Quanta Magazine, 2025-08-06;后经 WIRED 转载):https://www.quantamagazine.org/new-method-is-the-fastest-way-to-find-the-best-routes-20250806/ • [8] Ran Duan, Xiao Mao, Xinkai Shu, Longhui Yin · A Faster Directed Single-Source Shortest Path Algorithm(2026,[4] 的后续工作):https://arxiv.org/abs/2602.07868 • [9] NeuG GDS benchmark README · 编译说明:https://github.com/longbinlai/neug/blob/codex/bmssp-graphalytics-report/extension/gds/benchmark/README.md#build-the-current-gds-extension • [10] NeuG 实现分支(codex/bmssp-graphalytics-report):https://github.com/longbinlai/neug/tree/codex/bmssp-graphalytics-report • [11] 完整技术报告 · BMSSP_TECHNICAL_REPORT.md:https://github.com/longbinlai/neug/blob/codex/bmssp-graphalytics-report/extension/gds/benchmark/BMSSP_TECHNICAL_REPORT.md • [12] 原始结果 CSV · bmssp_results.csv:https://github.com/longbinlai/neug/blob/codex/bmssp-graphalytics-report/extension/gds/benchmark/bmssp_results.csv • [13] 公开数据与校验清单 · SHA256SUMS:https://neug.oss-cn-beijing.aliyuncs.com/datasets/ldbc-graphalytics/SHA256SUMS
