CSV、JSONL、XML 怎么选?小语种语料库的数据结构入门
- 更新时间 2026-10-08 09:02:05
CSV、JSONL、XML 怎么选?小语种语料库的数据结构入门做小语种语料库,团队经常把时间花在采集、翻译和标注上,直到交付前才发现:客户要的是JSONL,标注平台导出的是CSV,合作高校提供的语言材料又是XML。 格式转换看起来只是技术细节,却可能暴露更深的问题:一句话的方言标签放在哪里?一段音频对应多句转写怎么办?原始文本和译文如何保持对齐?授权范围能不能跟着样本一起流转? 选格式之前,先定义“一条数据是什么”。格式是装数据的容器,数据结构才决定语料以后能否清洗、训练、复核和交付。 先用一张表看区别
CSV常用于表格数据交换,但不同软件对分隔符、引号和换行的处理可能不同;JSONL要求每行是一条有效JSON数据,并使用UTF-8编码;XML则用标记表达文档的逻辑结构,还可配合模式文件校验结构。 一句话选择:简单、固定的表格用CSV;面向训练和多字段记录用JSONL;需要保存复杂文献结构或遵循既有编码规范时用XML。 CSV:先把基础语料管起来 假设企业要建设中文—越南语客服翻译语料库,每条样本都包含相同字段: text 这种数据很适合CSV。译员可以逐行校对,项目经理可以按领域筛选,质检员可以检查哪些记录尚未审核。 但CSV有一个常见陷阱:一行并不总等于“一行文字”。当字段本身包含逗号、引号或换行时,需要按CSV规则正确引用和转义,不能用简单的“按逗号拆分”处理。 CSV更适合以下场景: 当一条客服消息同时涉及“退款”“物流异常”“强烈不满”,你可以继续增加多个字段;但若每条记录的标签数量不固定,还要附上不同证据片段和审核记录,CSV就会逐渐变得难维护。 JSONL:让每条样本带上自己的上下文 JSONL可以理解为“每行一条独立的数据记录”。它很适合小语种语料逐批加工:读取一行,校验一行,处理一行。JSON Lines的基本要求是UTF-8编码、每行一个有效JSON值、用换行符分隔记录;在语料工程中通常约定每行使用一个JSON对象。 同一条翻译语料,用JSONL可以这样表示: text 它还可以容纳数组和嵌套信息,例如一段多轮对话: text 这比把多轮对话硬塞进一个CSV单元格更容易解释。语音数据也可以采用类似结构:在记录里放音频文件ID、语言或方言标签、转写文本、时间戳和说话人匿名ID;大体量音频本身通常另存文件,记录中保存可追溯的引用。 要注意,JSONL格式本身只规定“每行是什么样”,并不替你定义字段。 XML:保留文本“长什么样” 小语种项目并非都以一条句子为单位。有些团队采集的是访谈、口述史、教材、词典或长篇故事,需要保留章、段、说话轮次,以及文字内部的标注。 XML适合表达这些层次。例如: xml 如果一份材料需要更严谨的文本编码,语言学和人文学科项目还常使用TEI等基于XML的约定,描述语料层级、元数据及语言标注。 XML的代价是规则更多、人工修改门槛更高。对于每天新增大量客服问答的企业,不一定值得从XML起步;如果已有合作机构按XML或TEI交付,建议保存其原始结构,再按模型需要转换成JSONL。 小语种语料,更该先定哪些字段? 格式可以换,关键字段丢了却很难补回来。一条可复用的小语种样本,至少要回答以下问题: 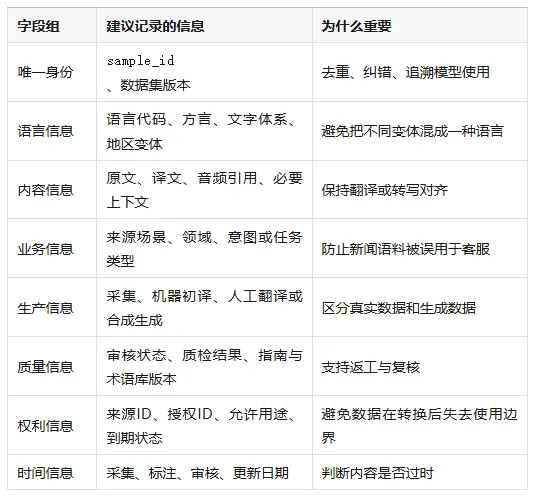
不建议把完整合同、授权书或含个人信息的原始材料复制进每条训练样本。样本中保留受控的来源与授权引用即可;详细证明材料应在单独的台账中管理。 一个容易踩的坑:字符没丢,语言却“变了” 小语种语料特别要注意文字和编码。 JSONL要求UTF-8;CSV应在交付协议中明确使用的编码;XML也应声明并核验实际编码。文件“看起来能打开”并不足以证明没有乱码或字符损坏。 还要留意:某些语言可能有多种书写体系或转写习惯,外观相近的字符未必是同一个字符。清洗、大小写转换或字符规范化可以帮助检索和去重,却不应未经语言专家确认就覆盖原文。 实操上建议同时保留: 这样,即使后来发现某项规范化规则不适合当地语言,也能回到原始内容重新处理。 交付时怎么选? 对多数企业语料项目,一个务实组合是: 例如,一家企业收到XML格式的地方语言访谈,经过授权核验与审核后,可保留XML原件;提取所需话轮生成JSONL供语音识别或问答模型使用;再导出少量CSV供母语审核员复核。三个格式各司其职,无需强迫整个项目只用一种。 结语 CSV、JSONL和XML没有绝对的高低之分。选型最有效的方法,是先确定数据的基本单位、使用者和后续流程:人工要不要审、系统要不要逐条处理、原始文档结构要不要保留、来源和授权能不能一路追溯。 对小语种语料库而言,真正好的数据结构,应该让一条语言样本在采集、翻译、标注、训练和交付之间流转时,仍然说得清:它是什么语言、来自哪里、谁审核过、可以用来做什么。 
点点赞 
点分享 
点推荐 
写留言 我们可以提供的服务 

聚焦 AI 应用与模型落地所需的高质量数据资产建设,我们提供从数据采集、清洗、脱敏、标注、质检、增强到评测集构建的一体化服务。覆盖文本、语音、图像、视频、点云及多模态数据,支持分类、抽取、问答构造、意图识别、实体标注、内容审核、偏好对齐等多类任务。 依托标准化交付流程、专业项目团队与多层质量管理机制,我们帮助客户将分散、非结构化的数据转化为可训练、可调用、可持续运营的 AI 数据资产,为大模型训练、行业模型优化、知识库建设、智能体应用与业务自动化提供稳定的数据底座。 

聚焦企业 AI 战略、场景落地与组织升级,我们提供 AI 战略规划、业务场景诊断、AI 产品与解决方案设计、数据治理、模型与平台选型、知识库建设、智能体规划及项目落地辅导等服务。 我们从企业真实业务目标出发,帮助客户识别高价值、可落地、可衡量的 AI 应用场景,梳理数据、流程、系统与组织协同中的关键问题,制定从试点验证到规模化推广的实施路径。让 AI 不止停留在工具试用和概念展示,而是真正转化为效率提升、成本优化、服务升级与业务增长。 
更多咨询 扫描二维码或搜索号码添加微信 18680021018,添加微信请备注需求
sample_id,source_lang,target_lang,source_text,target_text,domain,review_statuscs_001,zh,vi,您的订单正在配送中,Đơn hàng của bạn đang được giao,logistics,approvedcs_002,zh,vi,如何申请退款?,Làm thế nào để yêu cầu hoàn tiền?,refund,approved双语句对; 术语表; 单轮问答; 文本分类结果; 简单的语音文件索引; 人工校对与批次验收清单。
{"id":"cs_001","languages":{"source":"zh","target":"vi"},"text":{"source":"您的订单正在配送中","target":"Đơn hàng của bạn đang được giao"},"domain":"logistics","labels":["order_status"],"review":{"status":"approved","guide_version":"1.2"}}{"id":"cs_002","languages":{"source":"zh","target":"vi"},"text":{"source":"如何申请退款?","target":"Làm thế nào để yêu cầu hoàn tiền?"},"domain":"refund","labels":["refund_request","faq"],"review":{"status":"approved","guide_version":"1.2"}}{"id":"chat_001","language":"id","turns":[{"role":"customer","text":"Pesanan saya belum sampai."},{"role":"agent","text":"Mohon berikan nomor pesanan Anda."}],"intent":["delivery_issue"],"risk_level":"low"}lang、language和language_code如果在不同批次混用,文件虽然都能打开,合并时仍会出错。<?xml version="1.0" encoding="UTF-8"?><recordid="interview_001"language="vi"><speakerid="spk_01"/><utterancestart="00:00:01.200"end="00:00:03.800"><text>Xin chào, tôi muốn hỏi về đơn hàng.</text></utterance></record>raw_text:原始采集文本;normalized_text:按明确规则处理后的版本;normalization_version:使用了哪一版规则。
CSV供人看。用于试标、术语校对、抽检和项目验收。 JSONL供系统用。作为清洗、标注、训练或检索流水线的主要交换格式。 XML按需保留。对有复杂文档结构的原始资料或既有学术语料,保存XML原件及转换规则。 另附数据说明。写清字段定义、允许值、编码、空值规则、数据版本、来源和授权边界。
- End -
#01-AI数据服务
#02-AI咨询服务
往期推荐
本文来自网友投稿或网络内容,
如有侵犯您的权益请联系我们删除,
联系邮箱:wyl860211@qq.com 。
