给编码 agent 开过自动压缩的工程师,多半撞见过这笔糊涂账:上下文曲线确实压下去了,单次调用的 token 少了一大截,可任务端到端没变快,月底账单也没按同比例缩水。翻监控,每个数都对,合起来却讲不通。
这笔账现在有人算清了。UT Austin 九月二十六日挂上 arXiv 的论文跑了接近三万五千次编码 agent,结论直白:压缩省下的是 token,不是时间和钱——在 Terminal-Bench 上,只用全上下文三分之一 token 的策略,端到端反而慢 20% 到 80%,个别策略的估算成本比不压缩还高。
一揽子买卖的压缩设置
今天主流 agent 的压缩开关是一揽子交易。Claude Code 在逼近窗口上限时清掉工具输出、把历史改写成结构化摘要;Gemini CLI 在窗口用到一半时做类似的事,保留最后三成;OpenHands 把前一半日志换成一段自由摘要。怎么压、何时压、压多少,三件事捆死在一个默认值里。
捆着卖就没法归因。任务变慢,你不知道该怪摘要丢了关键信息、压缩触发太勤,还是被清掉的工具输出里恰好有下一步要用的东西。厂商默认值只在自己标定的那几个模型上调过,换个模型是什么效果,文档不会告诉你。
三万五千次运行,拆开三个决定
论文做的事说来直接——把捆住的三个决定拆成正交轴,分别变。压缩原语八种,从按新旧截断、清除工具输出,到自由摘要、结构化摘要、先清除再摘要的叠加式;触发时机分两种,超过 token 阈值才压,或每执行一步就压;压缩深度取 0.3、0.5、0.7 三档。三轴组合出 65 种策略,放进 Qwen3.5-35B-A3B、Devstral-Small-2-24B、GLM-4.7-Flash 三个开源模型,跑 SWE-bench Verified 和 Terminal-Bench 1.0,每种组合重复三次,同时记录成功率、token、端到端延迟和按缓存一折计价的估算成本。
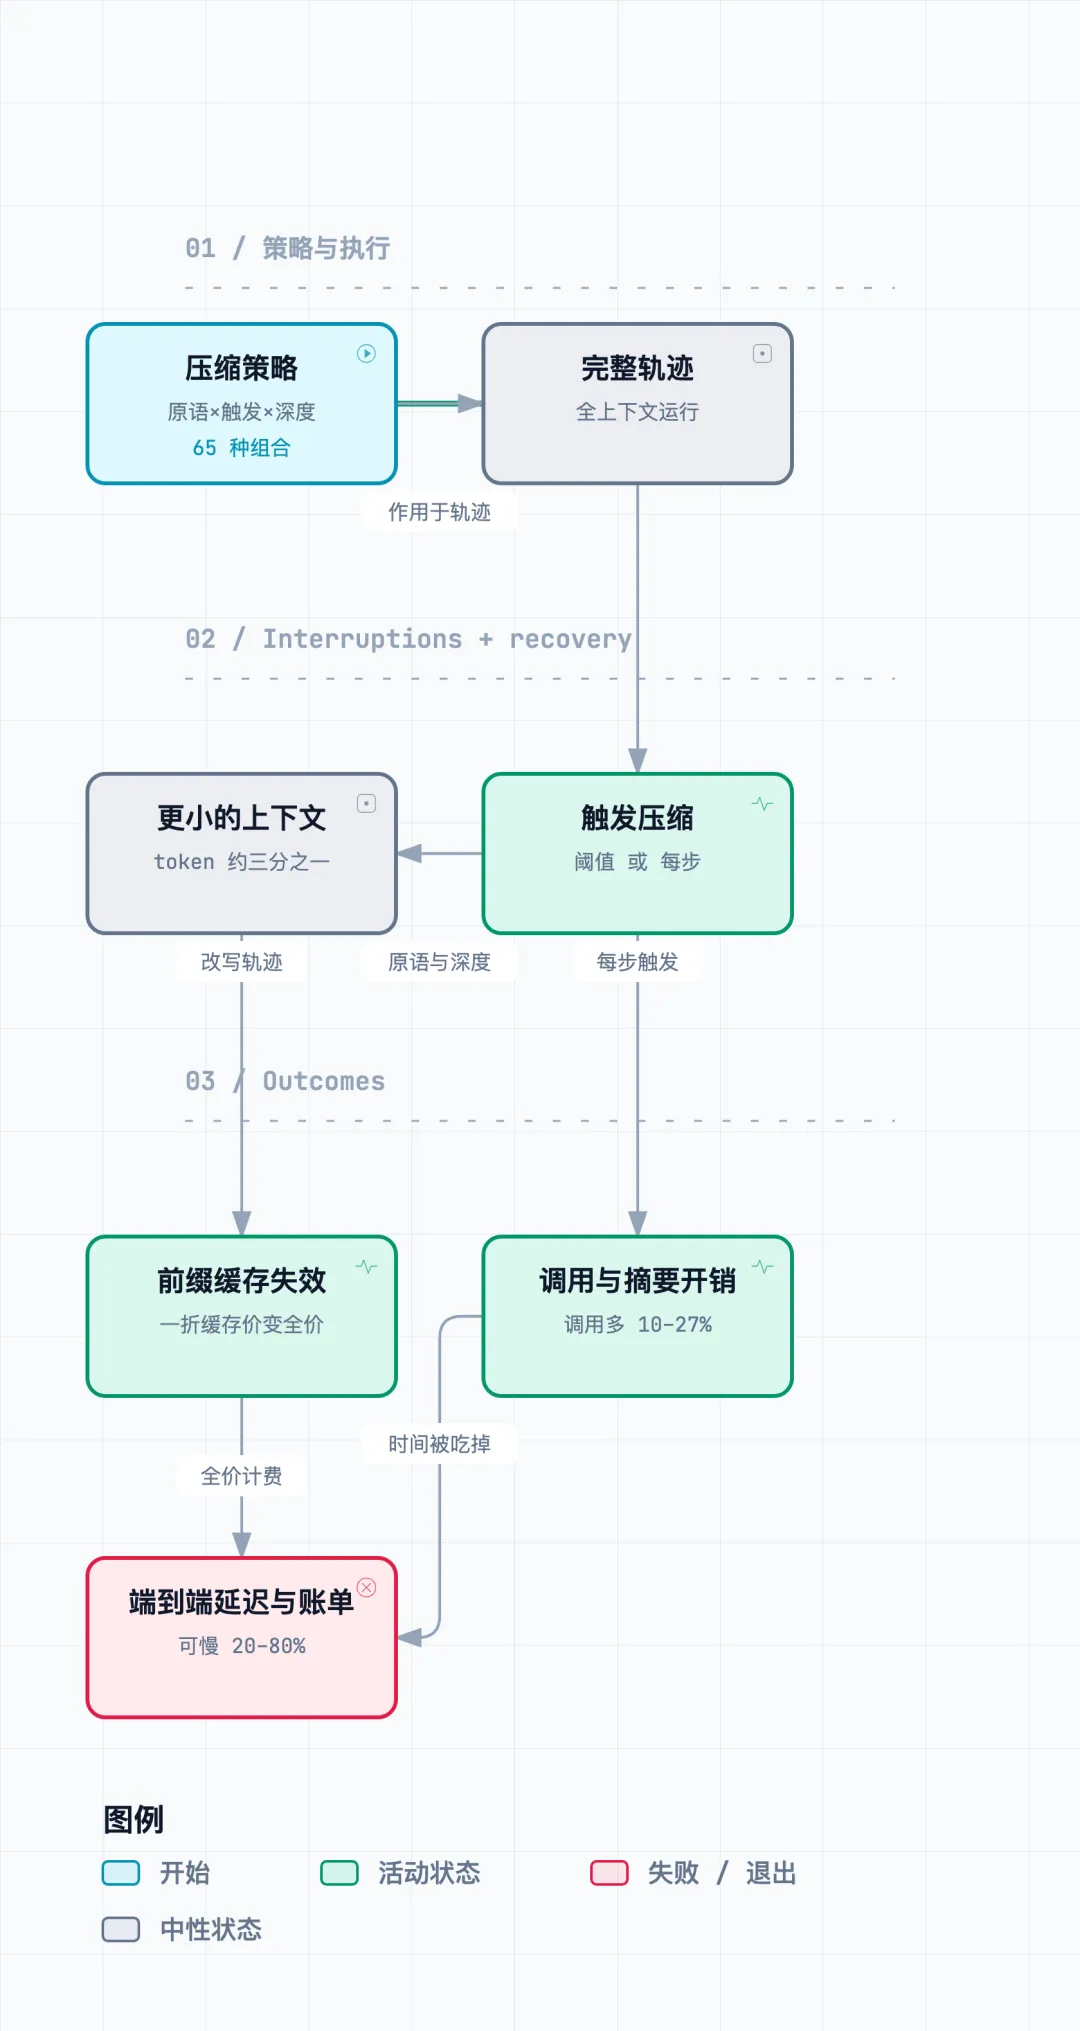
▲ 图一:三轴组合出 65 种策略——token 变小只是中间量,延迟和成本在别处结算
拆开之后,最扎眼的结果不在成功率,在时间和钱。Terminal-Bench 配 Qwen,一批策略只用了全上下文三分之一的 token,端到端却慢了 20% 到 80%;SWE-bench 上同样错位,token 用到 0.6 倍,成本仍停在不压缩的七到九成五,延迟基本追平。
钱去哪了,论文给出两条机制。其一,压缩改写轨迹,前缀缓存大面积失效:省下的 token 里原本有按一折计价的部分,改写之后剩下的都按全价算,省了数量没省单价。其二,压缩本身不免费:每步触发省 token 最凶,却要多出 10% 到 27% 的模型调用;摘要类策略在 Terminal-Bench 上,光摘要调用就占掉解决问题运行的 28% 到 46% 墙钟时间。token 少了、调用多了,两下一抵,账就平了,甚至反超。
同一个策略,换个模型就翻脸
▲ 图二:论文页——接近三万五千次运行量了成功率、token、延迟与成本四件事
论文顺手把已部署系统放进了同一坐标系。OpenHands 是摘要加阈值加半深,Gemini CLI 是清工具输出加结构化摘要加 0.7 深,Claude Code 最激进,接近全清加重写。这些默认值都在各自模型上调过,但跨模型的结果显示没有通用答案:同一种逐步清除策略,配 Qwen 把成功率拉高 7 个百分点,配 Devstral 反而压低 17 个百分点,排名整个反转;三个模型各自的最优策略分别是清工具输出、清完再结构化摘要、逐步清除配部分摘要,无一重合。
任务层面更细:有个策略总数只比全上下文少解一题,52 对 53,但换手了十五题——新解七题、丢掉八题。成功率打平,答的题已经不是同一批。拿"压缩没掉点"当验收标准,量的是总数,看不见这种换手。
触发时机的影响也大。Qwen 在 SWE-bench 上把阈值从 10K 提到 20K,每任务压缩从 4.85 次降到 1.15 次,成功率反而从 50.7% 升到 62.7%,成本从不压缩的 1.10 倍降到 0.92 倍。压得晚、压得少,好过压得勤——与"尽早压缩防溢出"的直觉相反。
token 是最容易骗人的指标
可迁移的判断只有一句:压缩策略不是抄来的配置,是自己模型和工作负载上的经济学题。token 数最好采,也最会骗人——它不区分一折的缓存价和全价,不含摘要调用的开销,不含多出来的轮次。评测压缩,量它换来的执行——延迟、折价成本、成功率,三者一起看,缺一个都会得出错误结论。
谁该现在动手
值得动手的有两类人。一类是在自托管或开源模型上跑长任务编码 agent、延迟或成本占预算大头的团队;另一类是正在给产品挑压缩默认值的开发者,论文的原语/触发/深度坐标系可以直接当实验设计用。任务短、窗口宽、单次调用为主的场景先别折腾,全上下文在多数测量里就是强基线。
今天能做的一步,是给 agent 补上两个观测量——每任务压缩次数和端到端延迟,跑二十个任务,再把触发阈值放宽一档对比。如果你的压缩每任务触发四五次,大概率正落在论文里"压得越勤越亏"的区间。
参考:arXiv 2609.32961
