失败的 AI 产品几乎总有同一个病根——没建起稳健的评测系统。
这是 Hamel Husain 在《Your AI Product Needs Evals》开头下的判断。这篇文章在 GitHub 开发者整理的评测资源清单里,被列为讲评测的标准范本。Hamel 做了 20 多年机器学习工程师,待过 Airbnb 和 GitHub。据他官网介绍,他合开的 AI 评测课,学员里有 OpenAI、Anthropic、Google 这些硅谷一线 AI 公司的人。读完全文,总结起来:
AI 产品的护城河不是模型,而是"快速迭代"的能力;而快速迭代的发动机,是一套低阻力、领域专属、持续生长的评测系统。
我结合自己做 AI 产品的实践,把这篇重新拆一遍。文末给大家准备了一份中文精读手册。
一、核心观点
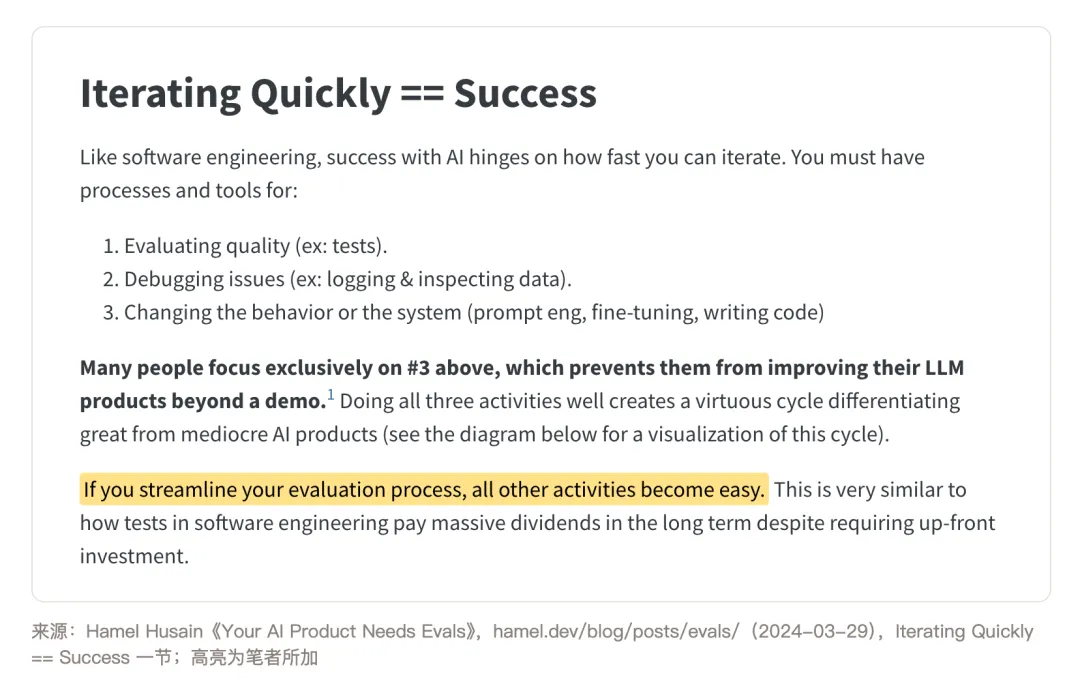
Hamel 把"做好 AI 产品"拆成三件必须同时做好的事:评测、调试、改进。
然后他点出了大多数团队的毛病:很多人只盯着第三件事,而这恰恰让产品永远停在 demo 阶段。
为什么大家都扎堆做第三件?
因为它最有"在工作"的快感。改一句 Prompt、换个模型,输出当场就变了。
可你只看了一两个例子,就觉得变好了。这是幸存者偏差。
那该怎么办?Hamel 的答案只有一句:
把评测流程打磨顺,其它所有事都会变简单。
所以评测不是额外的成本,它是发动机。发动机转得顺,调试和改进才跑得起来。
这个道理,Hamel 用一个真实案例讲透了。
主角叫 Lucy,是房地产 SaaS 公司 Rechat 的 AI 助手。经纪人对它说一句话,它就能查房源、建联系人、排日程,不用在软件里一层层点。
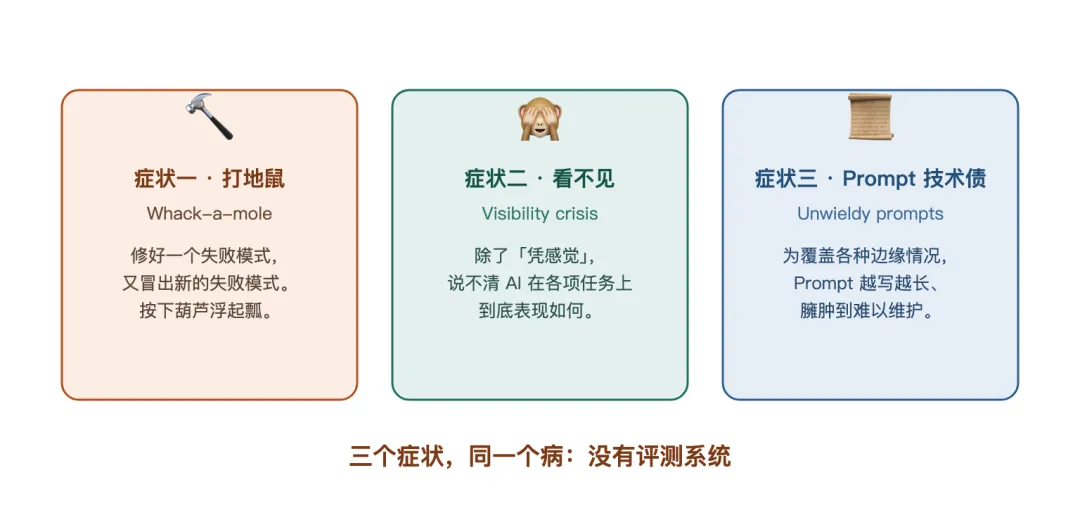
Lucy 一开始效果不错,很快就撞上了天花板,怎么调都上不去。撞墙时有三个症状:打地鼠、看不见、Prompt 技术债。
做过 AI 产品的人读到这里,大概都会心一笑。这三条,几乎每个团队都中过。
评测做了,回归测试(每次改动后,把已有的测试重跑一遍)也跑了,问题都测出来了,可最后我还是回去改 Prompt。每测出一个问题,就往里补一条规则。
Prompt 一层层堆,直到臃肿得没人敢动。打地鼠和 Prompt 技术债,一个没躲掉。
但仔细看会发现,这三个症状其实是同一个病。
没有回归测试,所以打地鼠;没有量化指标,所以看不见;不知道该改哪里,所以只能往 Prompt 里堆规则。
解法也就不在模型上,而在流程上:Rechat 围绕评测,把整个改进流程重新组织了一遍。
那"围绕评测"的流程,具体长什么样?
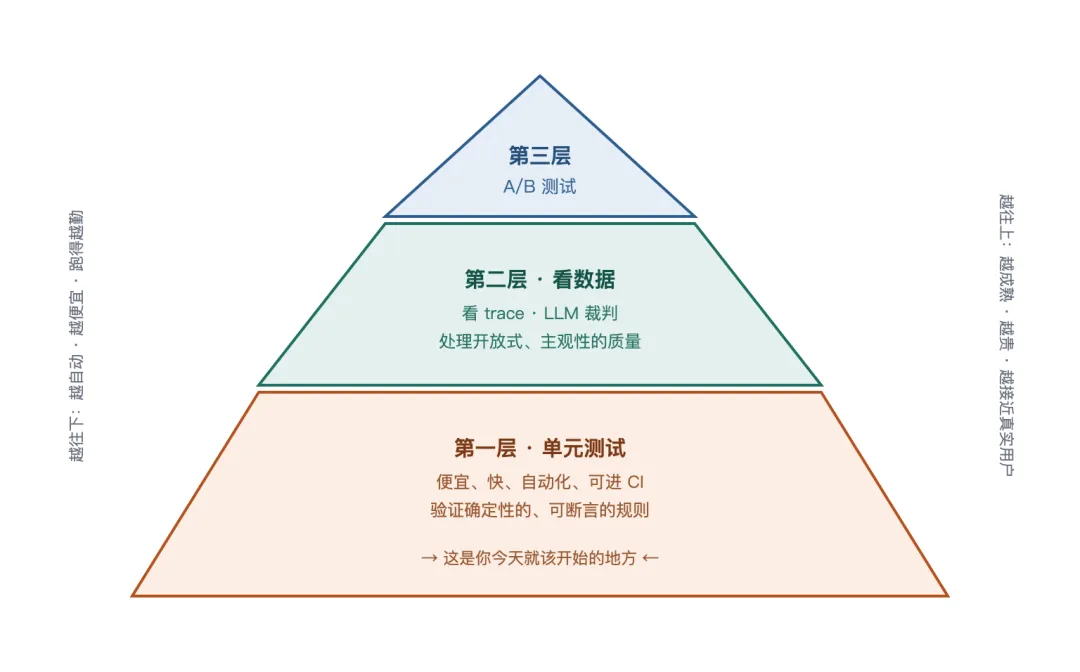
Hamel 给的 AI 评测体系分三层:单元测试、看数据、A/B 测试,由轻到重。
越往下越该多做,越往上越该晚做。新手最常犯的错,就是跳过前两层,指望上线以后让用户告诉你好不好。
而这台发动机一旦造好,还会顺手带动另外两件事:微调和调试。这个留到第五节讲。
下面三节,先一层一层拆。
二、第一层:单元测试
校验规则,就是一行代码能判断对错的检查(工程上叫"断言")。单元测试由一组校验规则构成,是整个体系的地基,也是最便宜、最该马上开始的一层。Hamel 给了三步。
① 拆成"功能 × 场景"
别去测"这个助手整体好不好"——太笼统,根本判不了对错。
要缩小到一个具体功能的一个具体场景,小到一行代码就能判对错。
按功能 × 场景组织测试,还有个好处:失败不再是一条条散点,而是落在某几个格子里。你能看出哪个场景最常出错,按格子修,而不是按条修。
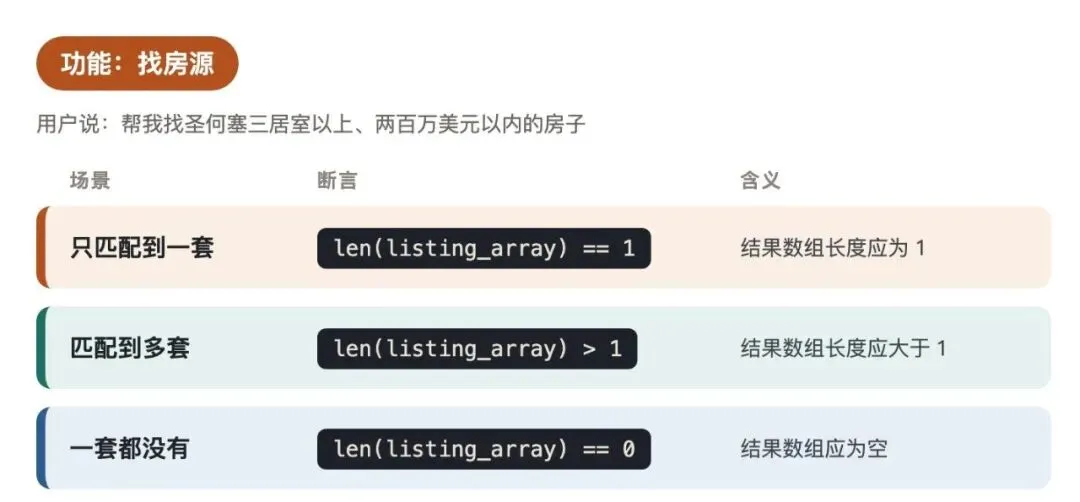
拿 Lucy 的'找房源'举例,三个场景各配一条校验规则。
还有一类较验规则更常用:检查不该出现的东西。
Rechat 的数据里带有内部 ID(UUID),这些绝不能出现在给用户的回复里。Prompt 里当然写了"不要输出 UUID",但 Hamel 还是加了一条校验规则,用正则把每条输出扫一遍。
为什么 Prompt 里写了还不够?
因为 Prompt 里的指令只是"交代",较验才是"验收"。
这一点,是我之前忽略的:LLM 必须做对的事,应该用代码硬规则来写,而不是在 Prompt 里一遍遍叮嘱。
Prompt 臃肿的问题,从这里开始松动。
还有一个反直觉的用法:删掉一条规则,重跑一遍回归测试,测试还全过,就说明这条是多余的。
Prompt 瘦身靠的不是写得更好,是敢删;而敢删的底气,来自回归测试。
② 用 LLM 批量造测试用例
没上线、没有真实数据,不是借口。Hamel 说得很直接:不用等生产数据,你完全可以推断用户会怎么用,让模型帮你造合成数据。
Rechat 的做法很巧:让模型一次生成 50 组"创建联系人"的指令,每组再配一条"查询这个联系人"的指令。
先让 Lucy 创建,再让它查。查出来恰好一条,才算通过。
至于通过率要不要做到 100%,Hamel 的答案是不必,通过率本身是个产品决策。之前拆 Evals FAQ 时聊过,这里不展开。
③ 接进 CI,并且把结果随时间追踪起来
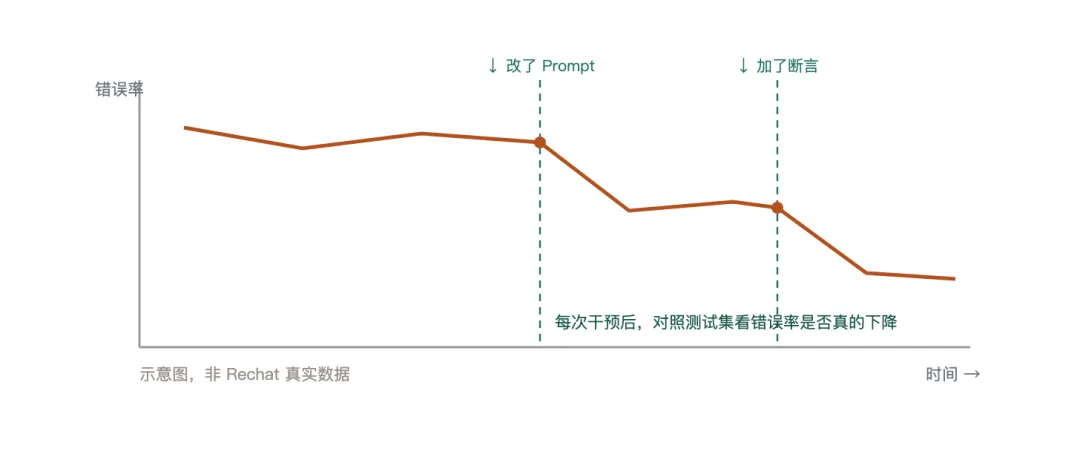
测试结果要随时间记录下来,你才知道自己到底有没有在进步。Rechat 把测试接进现有的 CI,再用开源看板工具 Metabase 持续追踪结果的变化。
这条曲线回答的是一个很要命的问题:这次改动,是真的让某类错误降下来了,还是你只是"感觉"它降了。
回头看 Lucy 的三个症状:有了回归测试,不再打地鼠;有了错误率曲线,看得见了;有了规则兜底,Prompt 能瘦身。
第一层看着朴素,却把三个症状都治了。
三、第二层:看数据
第一层只管得住"能用代码判对错"的东西。
可 AI 产品大量的问题是开放式的:回答得好不好、得不得体、有没有抓住重点。这些没法用一个等号判断。
这就轮到第二层。它分三块:记录 trace、看数据、用 LLM 当裁判。
① 记录 trace(日志)
trace 是一次交互的完整记录。Hamel 的定义是"一组逻辑相关的日志"。
它包括用户输入、AI 回复、系统元数据,以及请求流转中的每一个中间步骤:调用了哪个工具、检索到了什么、做了几轮推理。
很多人记日志,只记输入和输出。但对 AI 产品来说,中间步骤才是调试的金矿。
为什么?
Lucy 答错了,可能是理解错了用户意图,可能是检索到了错的房源,也可能是最后组织语言出了岔子。
这三种错,修法完全不同。只有输入和输出,你分不清是哪一环出的问题,就只能回去笼统地改 Prompt。
测试告诉你"错了",中间步骤才告诉你"哪儿错了"。
至于用哪家工具,Hamel 并不在意。他只强调一点:不管选什么方案,能搜索、能过滤、能阅读 trace,是必备能力。
② 看数据
这是全文 Hamel 措辞最重的一条:必须移除"看数据"这件事上的一切阻力。
通用的日志查看器不够用。他主张按你的业务来渲染 trace,把一次交互需要的所有信息聚合到一屏,不用在几个系统之间来回切。
他给 Lucy 搭的工具,能按功能和场景给 trace 分类。输出还能直接编辑,改好就沉淀成标准答案。用 Gradio、Streamlit 这类轻量框架,一天就能搭出来。
那要看多少?
刚开始尽可能多看,之后可以抽样,一直看到学不到新东西为止。但 Hamel 也把话说死了:看数据这件事永远停不下来,天下没有免费的午餐。
③ 用 LLM 当裁判
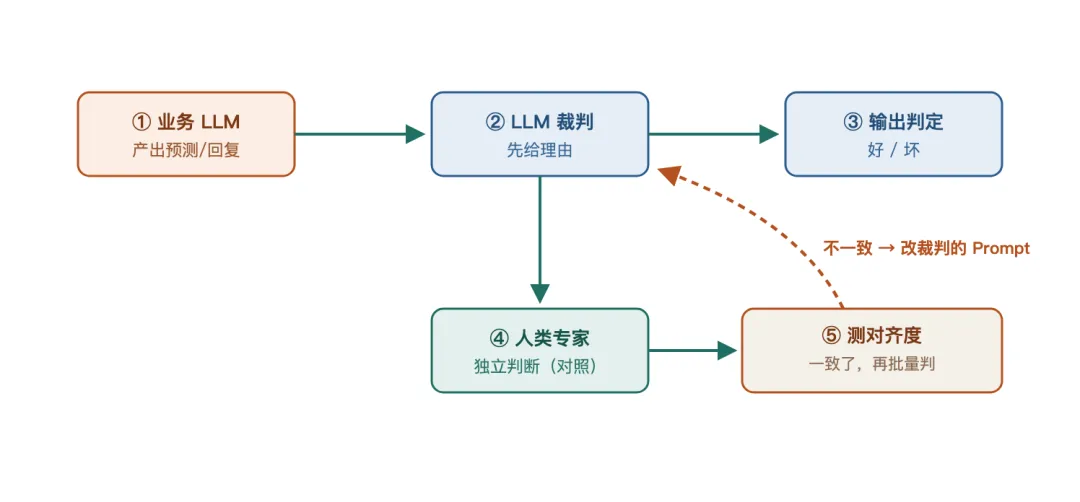
人看数据没法扩展,于是很自然会想:能不能让模型替人打分?这就是 LLM 裁判(LLM-as-Judge)。
Hamel 先泼了盆冷水:很多厂商想卖给你"号称不用人看数据"的工具,别信。
LLM 裁判是用来放大人的判断,不是替代人的判断。
做法很朴素:用一张表格,把 LLM 裁判和人类专家的判断逐行对照;不一致就改裁判的 Prompt,直到两边高度一致,才放手让它批量去判。
这一步我吃过亏。
当时想偷懒,直接让 LLM 当裁判,对齐做得很草率。结果测出来的结果不准,最后还是得人工一条条去复核,反而更耽误时间。
对齐时省下的功夫,最后都会在复核上加倍还回来。
裁判用哪个模型?用你负担得起的最强模型。它只在评测时跑,不在用户面前跑,贵一点、慢一点都没关系。
四、第三层:A/B 测试
到了第三层,评测对象从"输出对不对",升级成"真实用户的行为有没有变好"。做法和其它产品的 A/B 测试没两样:分流用户,比较结果。
但它又贵又慢。要消耗真实流量,要等统计显著,还要拿一个可能不成熟的体验去冒险。
所以这一步可以往后放,等你确信产品足够成熟、能拿给真实用户看了,再做。
顺带一句:RAG 怎么评测,原文明确说超出了这篇的范围,推荐去读 Jason Liu 的文章。常见思路是把"检索"和"生成"拆开,分别评。
五、两个免费超能力
讲到这里,你可能会想:三层评测,听起来是一笔不小的投入。
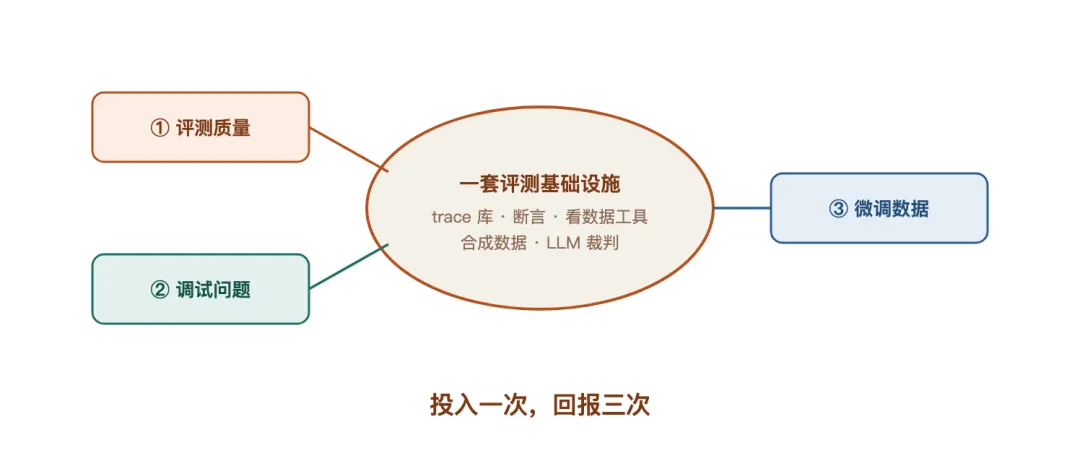
Hamel 在文章后半段,给了一个很漂亮的回报:评测系统建好之后,你会"免费"拿到两项能力。
第一项,是微调。
微调最擅长的,是让模型学会你产品特有的语法、风格和规则;要补上下文和最新事实,靠的是 RAG。别用错药。
而微调真正的瓶颈,不在技术。Hamel 说过:微调 99% 的工作量,都花在组装覆盖产品方方面面的高质量数据上。
而你为评测造的那套东西就是:
造测试用例的 Prompt,拿来批量合成训练数据
较验规则和 LLM 裁判,拿来筛掉低质量样本
看数据的工具,拿来人工精修出最终的训练集
要补一句:原文写于 2024 年。两年过去,多数产品团队已经很少自己做微调了。但你为评测攒下的高质量样本,换模型时可以拿来跑回归测试,也可以挑出来给 Prompt 当示例,一样用得上。
第二项,是调试。
Hamel 说,评测需要的基础设施,和调试需要的,有极大的重叠。线上出了问题,trace 库帮你找到出事的那次交互,中间步骤帮你定位根因,改完马上重跑测试。评测系统是发动机。这台发动机一旦造好,带动的从来不只是评测本身。
六、七条原则
Hamel 在文末,把整套方法压成了七条:
移除看数据的一切阻力
保持简单,别急着买花哨的 LLM 工具,先用手头已有的
如果你没在大量看数据,那你就做错了
别依赖通用的评测框架,为你自己的问题建一套评测系统
多写测试,并且经常更新
用 LLM 给评测系统"解套":生成测试用例、写校验规则、造合成数据、批判和标注数据
把评测基础设施,复用到调试和微调上
回头看这七条,其实就是"把评测流程打磨顺"的标准答案。
模型会越来越强,也会越来越便宜。用不了多久,大家手里拿的,都是差不多的那几个模型。
到那时,拉开差距的不会是你接了哪个模型,而是你的产品一周能迭代几轮。
模型是谁都买得到的燃料,评测系统才是你自己的发动机。
下一期接着聊评测:一份能直接上手的评测表格模板。