聊聊AI agents的评测体系-理论篇
- 更新时间 2026-10-08 08:49:45
聊聊AI agents的评测体系-理论篇这是鼎叔的第一百五十五篇原创文章。行业大牛和刚毕业的小白,都可以进来聊聊。 欢迎关注公众号《敏捷测试转型》,星标收藏,大量原创思考文章陆续推出。 这一两年各个公司都构建了看似强大的AI agents,如何客观全面地评估其效果,并推动它逐步迭代到理想目标? 很多开发者觉得,我们在AI大潮下都快被淹死了,赶紧把产品弄上线才是关键,为何要花大力气做AI的评测系统?其实评测系统才是开发团队的加速器,同时也是一个复利系统。 本文和下篇将从理论到实践来详细聊聊agent评测体系,聚焦最本质的概念和完整视角。 文章参考了Anthropic 的demistifying evals for AI agents,鼎叔从中体会到AI coding先行者对于评测的深刻洞见与极细致的梳理。 参考前篇聊聊AI产品的评测学-Evals。 AI agent时代为什么需要评测 传统软件的质量评估没有那么痛苦,你输入什么指令,就会得到什么确定的输出。 但AI agent更像抽盲盒,为了达成一个目标,agent可能给出很多种解法。这种非确定性,意味着我们不能再用死板的标准衡量它。 如果我们的评测,不能匹配这种灵活性,就会导致大模型产品缺少上线的信心。若修复一个bug,引发了更多新bug,产品就会陷入回归地狱。 当产品进入规模化运营,用户的抱怨越来越多,开发团队却不知道AI变差的根源在哪里,只能被动调试用户投诉的地方,效率也会断崖式下跌。 当我们建立了评测体系,它就可以消除歧义,用测试代码精准判断产品好还是不好;它也可以让大模型的升级更快,能够一键评估升级效果。 评测体系的几个关键概念 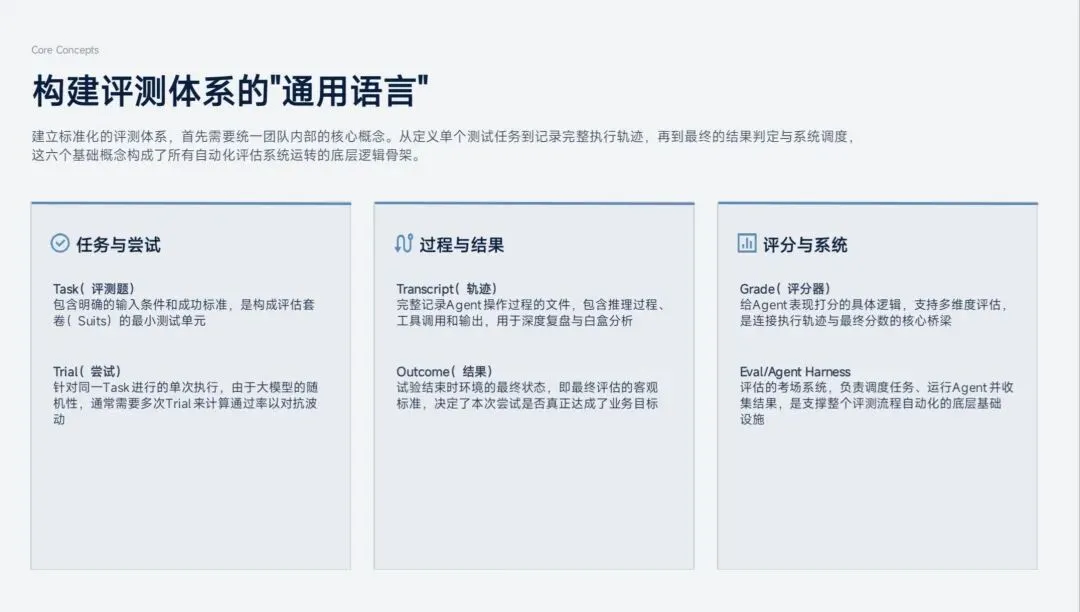
Tiral(尝试):通过多次尝试来评估通过率,来对抗随机性 Transcript(轨迹):记录完整操作过程的文件,用于复盘 Outcome(结果):最终状态,也就是最终评估的标准 Task(评测题):包含输入和成功标准 Suits(套卷):一组task组合在一起就是评估套卷 Grade(评分器):给agent表现打分的逻辑。一个维度可以有多个维度的评分器 Eval(evaluation) Harness: 端到端运行评估的基础设施 Agent Harness: 使大模型能够作为agent长期运行的系统 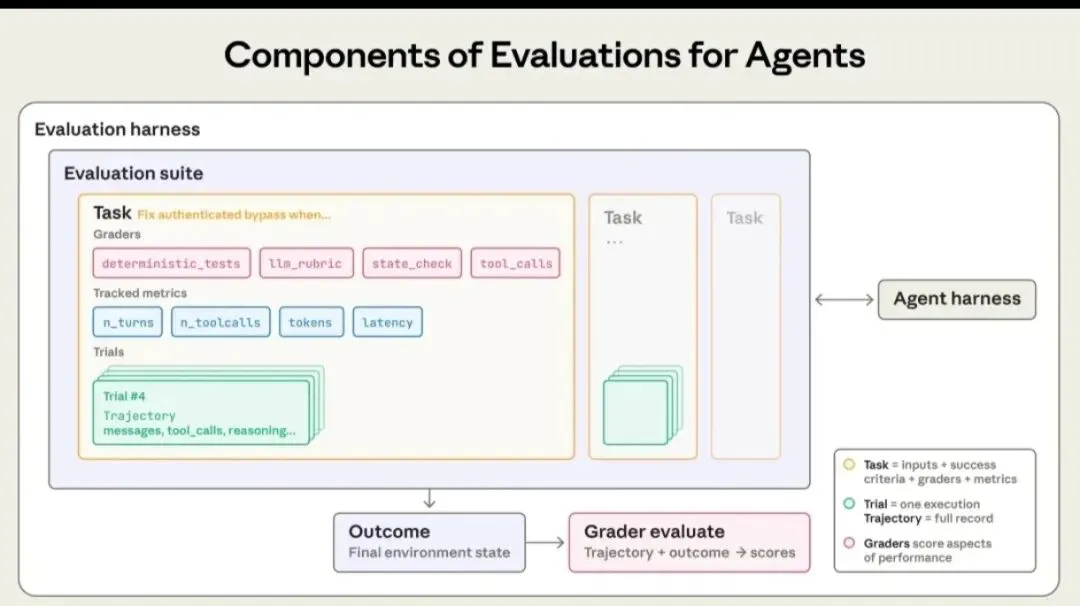
三种评分器 代码评分器 Code-based Grader 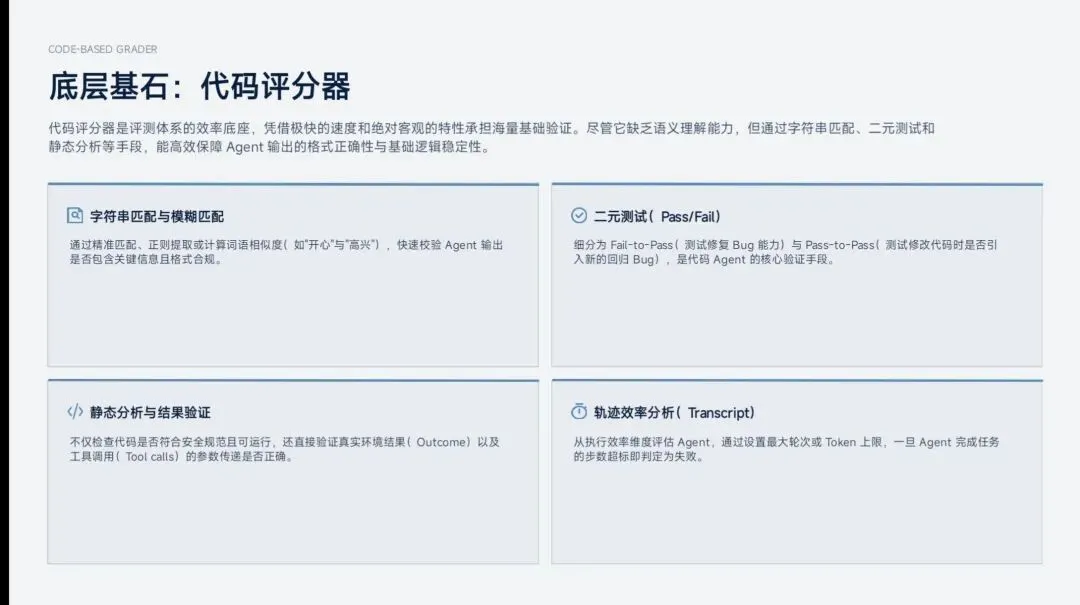
通过代码自动评分,速度极快,成本极低,而且绝对客观。常见的代码评分手段有: 1 字符串匹配,具体又包含三种模式:精准匹配,正则提取(只要能提取关键信息且格式正确就算OK),模糊匹配(如“开心”和“高兴”可以匹配上,两个词语相似度足够高就行)。 2 二元测试,结果只有pass和fail。 具体细分为两个关键逻辑: Fail-to-Pass,测试agent修复bug的能力。 Pass-to-Pass,测试agent的稳定性,看是否修改代码时产生新的回归bug。 3 静态分析代码。保障代码既可以跑,又符合安全规范 4 结果(outcome)验证。直接验证真实结果 5 工具调用(Tool calls)验证。检查agent是否拿对工具,参数是否传对 6 轨迹(Transcript)分析。这是从效率维度看 agent多少步能完成任务。我们会设置一个最大轮次或Token上限,超标即判负。 代码评分的优点很多,但也有缺点,比如:看不懂语义,没法变通,用于客户沟通等场景容易让人啼笑皆非。因此我们要引入能听懂阴阳怪气的裁判。 模型评分器 Model-based Grader 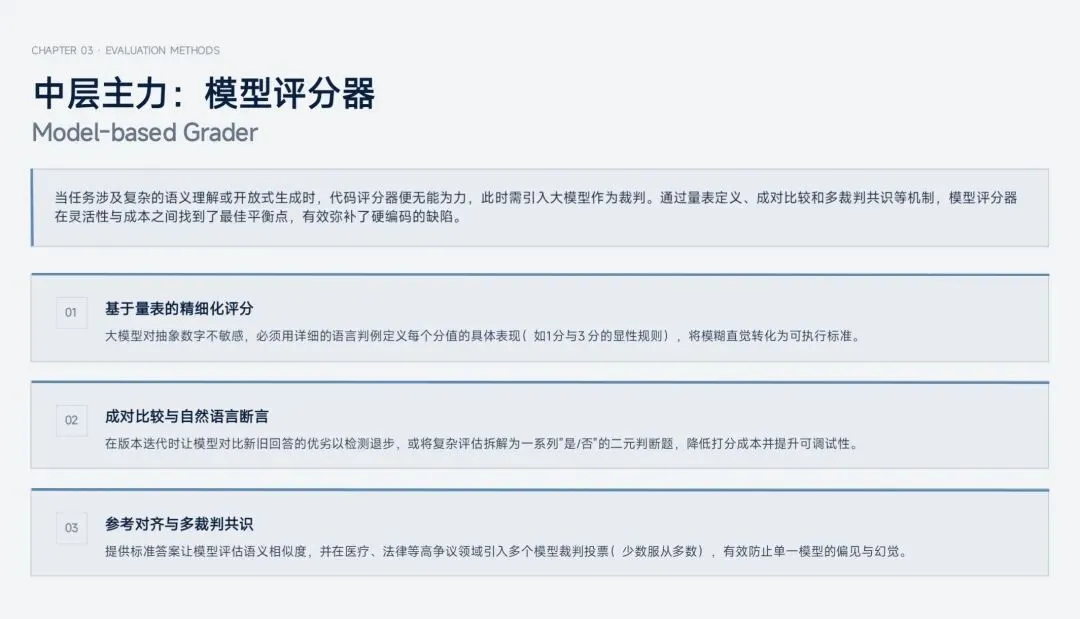
下面是五种让LLM来当裁判的方法 1 基于量表的评分。这种评分经常容易被错用,大模型对数字不敏感,无法区分具体差别。 好的量表需要用详细的语言判例,定义每个维度的值,如:agent在什么表现下能得到1分,什么表现下得到3分,把模糊直觉翻译成显性规则。 2 自然语言断言。把一个评估拆解一组二元判断题,用“是”或者“否”回答,这种打分更便宜也更容易调试。 3 成对比较。这在版本迭代时很好用,把 agent昨天的回答和今天的回答让另一个大模型来对比好坏,看是否退步。 4 参考对齐。先给大模型裁判一个标准答案,评估语义相似即算通过。 5 多裁判共识。这样可以防止单个大模型裁判的偏见,最终看平均分,或者少数服从多数。这在医疗、法律等高争议领域是必须的。 模型评分器能解决语义问题,适合开放式任务,但也有缺点:成本高,而且需要人类进行校准。 人类评分器-Human Grader 很多人本能地认为,人类评分器应该是评测的初级阶段,等自动化成熟后就可以抛弃了。 但AI大厂并不这样认为,在一套成熟的评测体系中,人类并不会消失,但职责可能发生变化:人类不再为每一项结果打分,而是负责定义什么是对的,判断整个系统是否偏离方向。 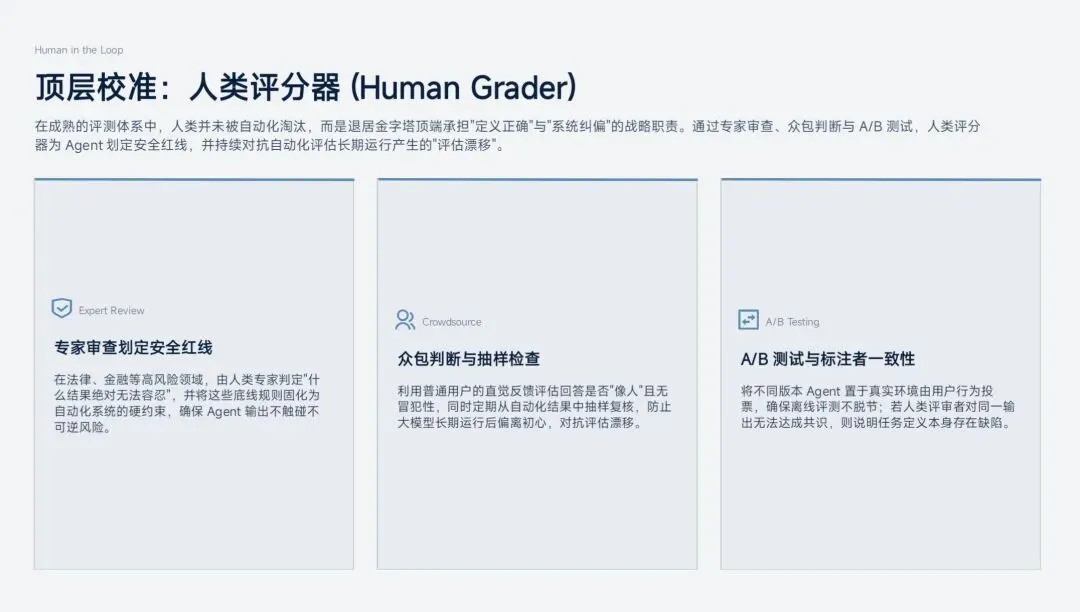
下面有五种人类介入评估的方式,它们不是并列关系,而是承担了不同层次的职责。 1 专家审查。 这是风险最高,成本也是最高的方式。在法律,金融,安全等领域,最终评估标准必须由人类领域专家判定,务必回答红线问题:什么结果是无法容忍的。专家的这些判定会最终固化为规则、量表、示例,回流到自动化评分系统中。 2 众包判断。这类评分不是关注对错,而是关注“像不像人”,结果是否通顺自然,是否让用户觉得有被冒犯。众包不需要专家,但需要大量普通用户的直觉反馈。 这是一种成本可控的人类信号来源,可以补足大模型在人类感受上的盲区。 3 抽样检查。从大量自动化评测系统中,定期抽取一小段数据,让人类进行复核,避免大模型长期运行后,偏离了原本初心而不自知,以对抗“评估漂移”。 4 A/B测试。把评测放进真实环境,让不同版本的agent同时上线,由真实用户用行为数据投票,确保离线评测和真实世界没有脱节。 5 标注者一致性。如果多个训练有素的人类评审者,对同一个输出无法达成一致意见,那问题往往不在大模型,而且任务定义本身,这时微调模型几乎就是无效的。 人类评分器的优势就是更贴近真实用户的专家判断,且它主要用于校准模型评分器。它的缺点也很明显,成本高,速度慢,对于规模化业务需要大量人类专家。 因此,人类评分器不适合高频使用,而应该放在三类评分器的顶层,用来长期校准整个自动化系统。 简单总结 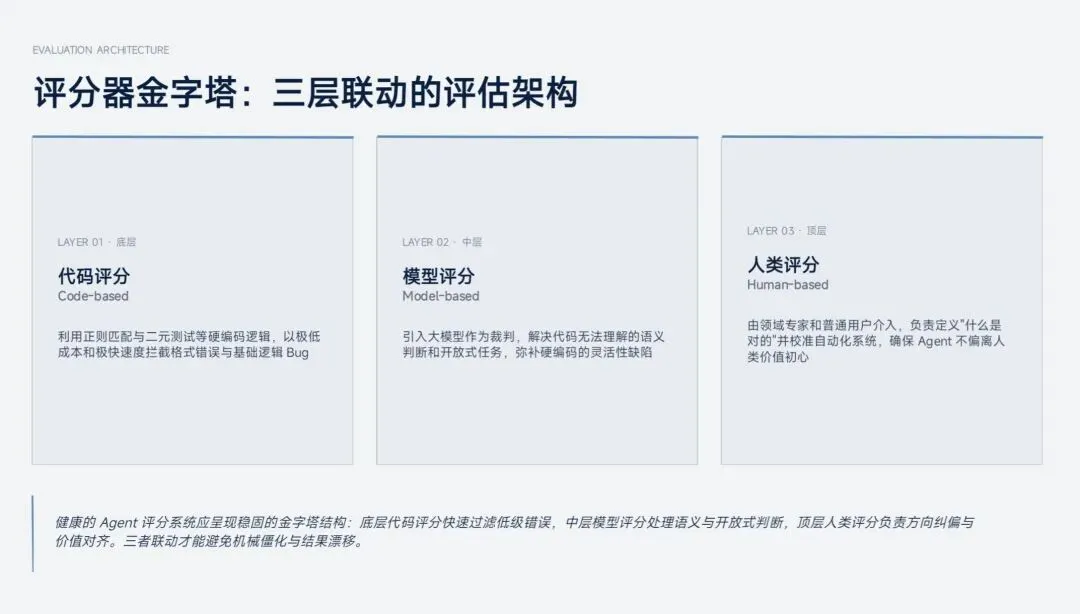
健康的agent评分系统应该是个金字塔,底层是代码评分,用正则与二元测试,快速过滤大部分低级错误,速度最快最便宜。中层是模型评分,搞定语义或开放式判断,这些没法硬编码。塔尖是人类评分,解决方向纠偏问题。 三者联动,避免机械僵化和结果漂移,重回人类关注的价值初心。 驯服随机性 经过上述评分器判断后,并不意味着我们的agent就敢进入生产系统。agent作为概率模型,评估跑分结果就存在随机性。 对于结果容易抖动的对象,我们需要引入两个概率统计指标:Pass@K和Pass^K。 Pass@K:K是尝试次数,这个指标指连续K次尝试中至少有一次能成功解决问题,那就算通过。 读者可能认为这个指标对生产管理太不靠谱了,没错!这个指标是用于实验室摸底的,衡量agent的潜力,适合校验创造力和可能性的场景。如生成视频,或解决难题的代码。 我们通过工程手段,如重试和补充prompt,提高成功概率,最终就能进入到Pass^K统计-看看结果稳不稳。 Pass^K:连续K次尝试都能解决问题。有一次失败就算fail。这个严苛指标衡量的是系统可靠性,适合面向客户容错率低的场景,如金融产品和客服产品。 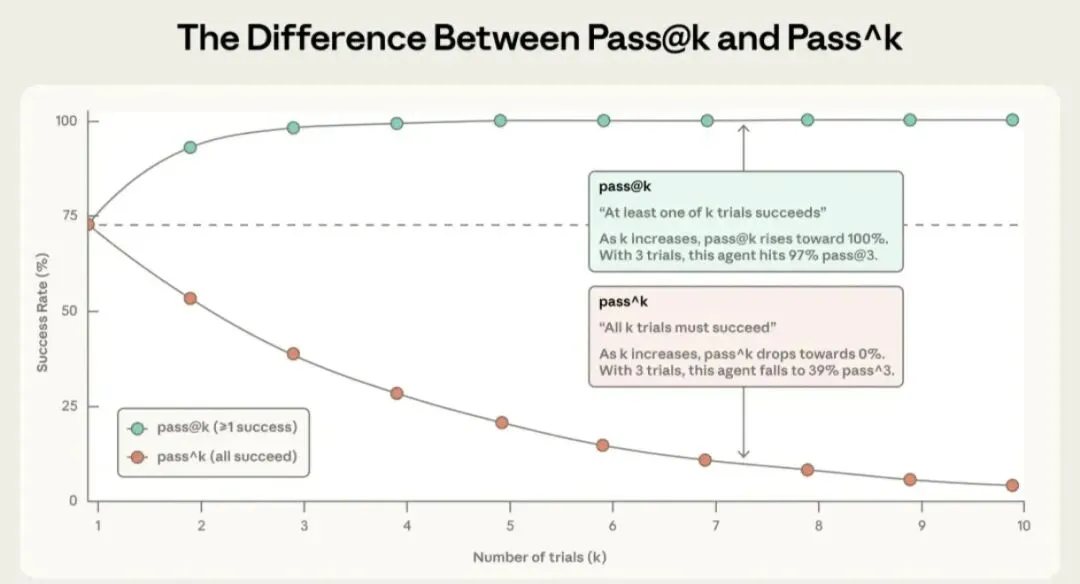
评测的生命周期 评测集不是一成不变的, 它会经历从能力评估-Capability Evals,到回归评估-Regression Evals的演变。 前面的阶段会统计Pass@K,驱动能力爬坡,要挑战难题,不怕犯错,提高上限。“毕业”后就移入回归评估的题库,这时agent进入了成熟期,回归的目标是Pass^K,防止劣化,题库里都是以前曾经做对的题,我们通常制定100%通过的严苛标准。一旦分数下降,往往说明出BUG了,新加的代码破坏了原有能力。 这两个阶段就是从“能不能做到”过渡到“能不能稳定做到”的评测生命周期,从提高上限的乐观主义者,成长为提高下限的现实主义者。 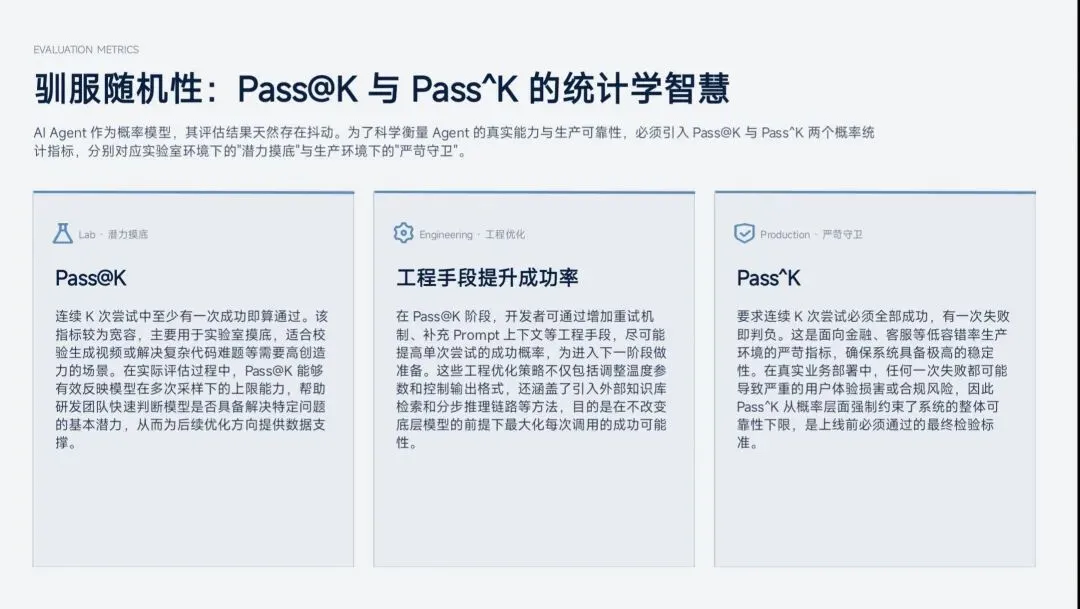
下篇,我们聚焦实战经验:分析不同类型的评测差异,构建体系的路线图,综合运用各种评估手段。
本文来自网友投稿或网络内容,
如有侵犯您的权益请联系我们删除,
联系邮箱:wyl860211@qq.com 。
