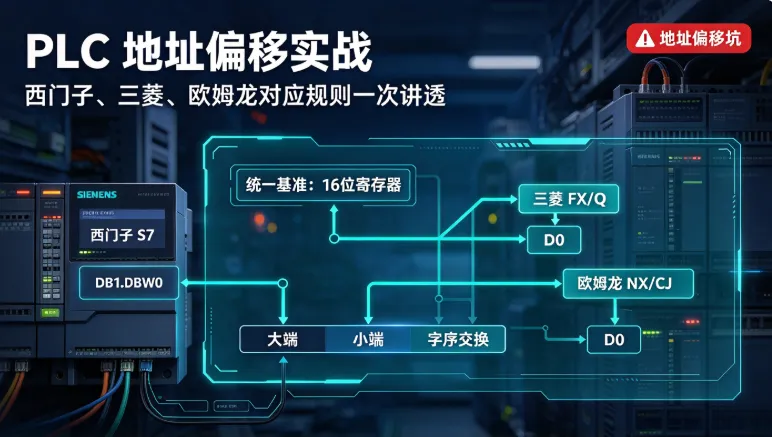
做工业设备集成和上位机开发的,几乎都踩过地址偏移的坑: 西门子DB块的地址直接套到三菱PLC上,数据全乱; 同样是读第10个寄存器,欧姆龙和西门子差了整整一个字节; 16位整数传过去都对,32位浮点数一跨品牌就完全离谱。
很多新人遇到这种问题,就对着地址表一个一个试,试半天碰对了,下次换个品牌又踩坑。其实不同品牌PLC的寄存器地址,底层逻辑是完全通的。所谓的偏移坑,本质就是存储单位、编号规则、字节序这几个核心点没搞懂。
今天就把西门子、三菱、欧姆龙三大主流品牌的地址体系、对应方法、偏移坑排查全讲透,都是现场踩出来的实战经验,看完再也不用盲目试地址。
一、先搞懂:地址偏移的本质是「规则不统一」
很多人以为“寄存器地址”是行业统一的,数字一样就代表同一个位置,这是最大的误区。
不同品牌PLC的地址体系,在四个维度上都可能有差异:
- 起始编号:有的从0开始,有的从1开始;文档写的是1起始,协议层面是0起始
- 存储单位:有的按字节编址,有的按字(16位)编址,还有的按位编址
- 字节/字序:单字内的字节顺序、双字内的字顺序,大端小端规则不同
- 存储区划分:有的是全局寄存器,有的是分块自定义,映射关系完全不同
跨品牌地址对应,从来不是“数字对数字”,而是“规则对规则”。先把底层规则对齐,地址自然就对上了。
二、三大主流PLC地址体系:逐个拆解底层规则
2.1 西门子S7系列:以DB块为核心的字节编址
西门子的地址体系是最规整的,但也是新人最容易懵的,因为它的粒度最细,按字节为基础编址。
- 核心存储区:DB块(数据块)是最常用的用户数据区,此外还有I、Q、M等过程映像区
- 地址层级:从大到小是 块 → 字节 → 位,所有地址都从0开始编号
- 位:
DB1.DBX0.0 → DB1块,第0字节,第0位 - 字节:
DB1.DBB0 → DB1块,第0字节(8位) - 字:
DB1.DBW0 → DB1块,第0字节开始的2字节(高字节在前) - 双字:
DB1.DBD0 → DB1块,第0字节开始的4字节(高字在前)
- 关键规则:字和双字都是从偶字节开始,高字节在前(大端字节序);双字内低地址存高字(大端字序)
⚠️ 最高频踩坑点:博途里创建的DB块默认开启「优化的块访问」,此时变量没有固定的绝对地址,按上面的地址读出来的数据全是错位的。必须关闭优化选项,才能用绝对地址访问。
2.2 三菱FX/Q系列:软元件体系的字编址
三菱是典型的软元件架构,数据寄存器按字(16位)为单位编址,是新人最容易上手的体系。
- 核心数据区:D区(保持寄存器),全局统一编号,每个D寄存器固定16位
- 地址格式:
D0、D1、Dn,编号从0开始,每个单元对应一个16位字 - 32位数据:由两个连续D寄存器组成,低编号存低16位,高编号存高16位(小端字序)
- 位元件:X、Y、M等按位编号,M0-M7对应第0字节,M8-M15对应第1字节,以此类推
⚠️ 注意:走标准Modbus协议时,D区映射为保持寄存器,D0对应地址0,字节序遵循Modbus大端标准;但原生32位数据的字序是小端,和西门子刚好相反,这是跨品牌传浮点数最容易踩的坑。
2.3 欧姆龙CJ/NX系列:通道式字编址
欧姆龙的地址体系和三菱类似,也是按字(通道)编址,但命名和细节规则有差异。
- 核心数据区
- 地址格式:位地址是「通道号.位号」,比如
D0.00代表D0通道的第0位;字地址直接D0 - 32位数据:低通道存高字,高通道存低字(大端字序),和西门子一致,和三菱相反
- 扩展区:还有CIO区、WR区等,寻址规则和DM区一致,只是功能不同
三、跨品牌快速对应:统一基准映射法
不用死记每个品牌的地址规则,只要建立一个统一基准,所有品牌都先映射到基准上,再转换到目标品牌,永远不会错。
核心思路:以16位寄存器为统一单位,以0起始为统一编号,先对齐基准,再映射到具体品牌。
3.1 16位寄存器统一映射表
这是最常用的对应关系,覆盖90%的整数采集场景:
记忆要点:西门子是字节编址,所以字地址要乘2;三菱和欧姆龙是字编址,编号直接对应。
3.2 位地址的统一对应
位地址统一按「字节号.位号」的0起始规则对齐:
3.3 32位数据与浮点数的对齐
32位数据(DINT、REAL)跨品牌出问题,99%都是字序不匹配。记住这个对应规则:
比如要把西门子的REAL(浮点数)传到三菱:
- 从西门子DB1.DBD0读出4字节,顺序为「高字节1、高字节2、低字节1、低字节2」
- 三菱D0D1默认小端字序,需要把两个16位字交换顺序
如果走标准Modbus协议,建议统一按大端字序传输,两端都遵循协议标准,从根源上避免字序坑。
四、最容易踩的6个偏移坑与排查方法
坑1:地址刚好差1 → 0起始vs1起始
现象:所有数据都错位一个寄存器,第0个地址的值,对应对方第1个地址的值。原因:一方用0起始(协议标准),一方用1起始(文档/配置习惯)。比如很多上位机配置里写的“地址1”,实际对应PLC的D0。排查:把地址±1试一下,立刻就能验证。
坑2:16位正常、32位全错 → 字序相反
现象:16位整数完全正确,32位整数、浮点数数值完全离谱。原因:双字内的两个16位字顺序相反,也就是大端字序和小端字序不匹配。排查:抓包读出4字节原始数据,交换前两个字节和后两个字节的位置,再换算数值,对得上就是字序问题。
坑3:每隔一个对一个 → 字/字节单位混淆
现象:第0个对,第1个不对,第2个对,第3个不对,间隔错位。原因:把字节地址当成字地址用了。比如把西门子的DBB1当成第一个寄存器,实际DBW0才是第一个字。排查:算一下步长,步长是1就是字节单位,步长是2就是字单位,对比两边的步长是否一致。
坑4:数值高低字节颠倒 → 字节序反了
现象:数值不大的时候对,数值大了就错,换算成十六进制看,两个字节是反的。原因:大端字节序和小端字节序搞反。不过标准工业协议基本都是大端,这个坑大多出现在自定义协议里。排查:把单字的两个字节交换顺序,数值正确就是字节序问题。
坑5:西门子数据全乱 → DB块优化模式
现象:地址明明按文档写的,但读出来全是乱码,或者全是0。原因:DB块开启了「优化的块访问」,PLC自动优化变量存储位置,没有固定的绝对地址。排查:去博途里看DB块属性,取消“优化的块访问”勾选,重新下载程序。
坑6:整体偏移固定字节数 → 起始地址算错位
现象:所有数据都往后错了固定的字节数,比如都差4个字节。原因:计算起始地址时搞错了单位。最典型的是S7协议里的起始地址是位地址,很多人直接填字节数,比如要读第10字节,填了10,实际应该填80(10×8)。
五、实战案例:跨品牌浮点数错位排查
去年一个汽配厂项目,要把西门子S7-1200的焊接温度数据同步到三菱FX5U的触摸屏,16位的产量计数都正常,就是温度浮点数全不对,差得毫无规律。
当时的排查步骤:
- 先确认16位整数全部正确,说明寄存器的基础映射、字节序都没问题
- 单独读一个温度值,西门子那边是25.5,三菱这边显示-1.2e+8,明显是存储顺序问题
- 抓包读出西门子的4字节原始数据:
41 CC 00 00(对应25.5的IEEE754大端格式) - 再看三菱收到的4字节,也是一样的顺序,但三菱32位默认小端字序,相当于把
00 00 41 CC当成了浮点数,数值当然不对 - 解决方法:在中转程序里把4字节的前后两个字交换,变成
00 00 41 CC→41 CC 00 00再写入三菱,数值立刻正确
前后排查不到10分钟,根本不用改PLC程序,就是字序规则不统一导致的。
六、最后:地址对应的核心心法
做了这么多年工业通信,见过太多人在地址上反复踩坑,其实根本原因就是“想当然”:想当然地以为地址号一样就是同一个位置,想当然地以为所有品牌规则都一样。
跨品牌地址对应,永远记住三个步骤:
- 先统一单位
- 再统一序
- 最后对应编号
不用死记每个品牌的细节,遇到不确定的,就写一个已知值进去,两边监控对比,比查半小时文档快得多。地址对应从来不是技术难题,就是个细心活,搞懂底层规则,再怎么跨品牌都不会踩偏移的坑。