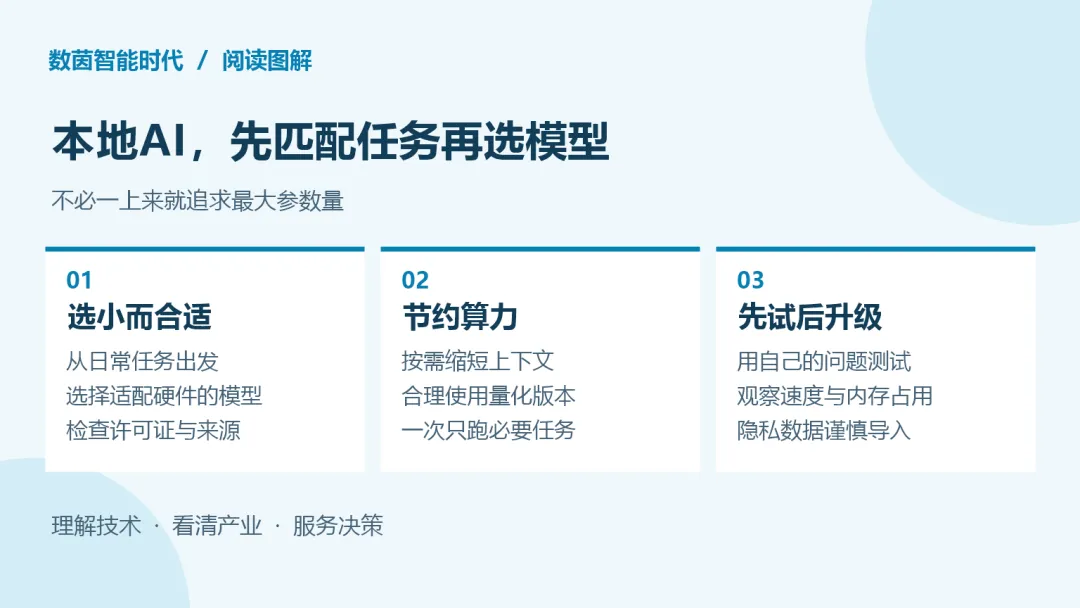
想在个人电脑上运行AI,先别急着换显卡。第一件事是确定任务:你要整理私人文档、做摘要、写代码、翻译,还是生成图片?模型大小和硬件需求只是开始,能不能稳定完成你真正的任务才是选型标准。
第一步看设备现状。记录电脑的内存、显存、芯片平台和可用存储,再选择明显能装得下的模型。模型权重之外,还要为上下文缓存和程序留空间;上下文越长、并发越高,资源占用通常也会增加。仅有办公笔记本时,先从小模型开始测试,不要因为排行榜里最大模型表现好,就认定必须购买昂贵设备。
第二步按任务挑模型。通用问答、中文写作、代码补全和长文档总结并非同一能力。先选可信来源、许可允许本地使用的模型,在自己的资料上做20至50个代表性问题,记录答对率、耗时和失败类型。模型名字和参数量不能替代你的实际测试。
第三步用简单办法降低算力消耗:容易的问题交给小模型,复杂问题再升级;长资料先检索相关段落,而不是整本塞进上下文;缩短无关历史和输出长度;重复请求缓存答案;控制并发。低比特量化可以降低权重内存占用,但可能改变输出质量,应以本地样例验证。llama.cpp的量化工具文档也提醒,不同量化方法的取舍需要根据应用评估。
第四步比较本地、云端和混合方案。本地部署可减少部分资料外传并支持离线使用,却要自己承担更新、兼容、备份、散热和电费;云端更省维护,但须核实隐私条款、费用和数据处理范围。包含身份证件、客户资料、源代码密钥的内容,不要随手交给不明服务;“本地运行”也不自动等于安全,要检查插件、日志和联网组件。
可以这样起步:用现有设备装好可信运行环境,选小型模型和少量资料,做一周试用,记录任务质量、响应时间、内存和耗电;如果常见任务达标,就先用起来;若不达标,再比较更大模型、量化方案、检索增强或云服务的增量收益。
本地AI不是越大越好,而是以最低的可接受成本完成足够可靠的工作。把算力花在模型确实需要推理的地方,往往比盲目升级硬件更划算。
资料来源:llama.cpp官方量化文档及相关模型运行工具文档。模型许可、量化效果与硬件兼容性因版本而异,部署前请核验。