最近我在电脑前越来越多地用语音输入,主力工具也从微信语音输入法换成了开源的 OpenLess。用了一段时间后,我想更严谨地回答一个问题:面对本地、系统和云端这么多种语音识别方案,哪一种更适合我?能不能本地直接跑模型免费畅用?本文我将回答这个问题,针对我的应用场景找个最合适的方案,顺带了解下行业当前各模型的实力。
背景
不知道这算哪种性格,我用一个东西时,不把它研究清楚就不安心。用 OpenLess 时,我发现它提供了很多 ASR 选择。这可难住了我这个选择困难症人士,我非得给它们分个强弱。
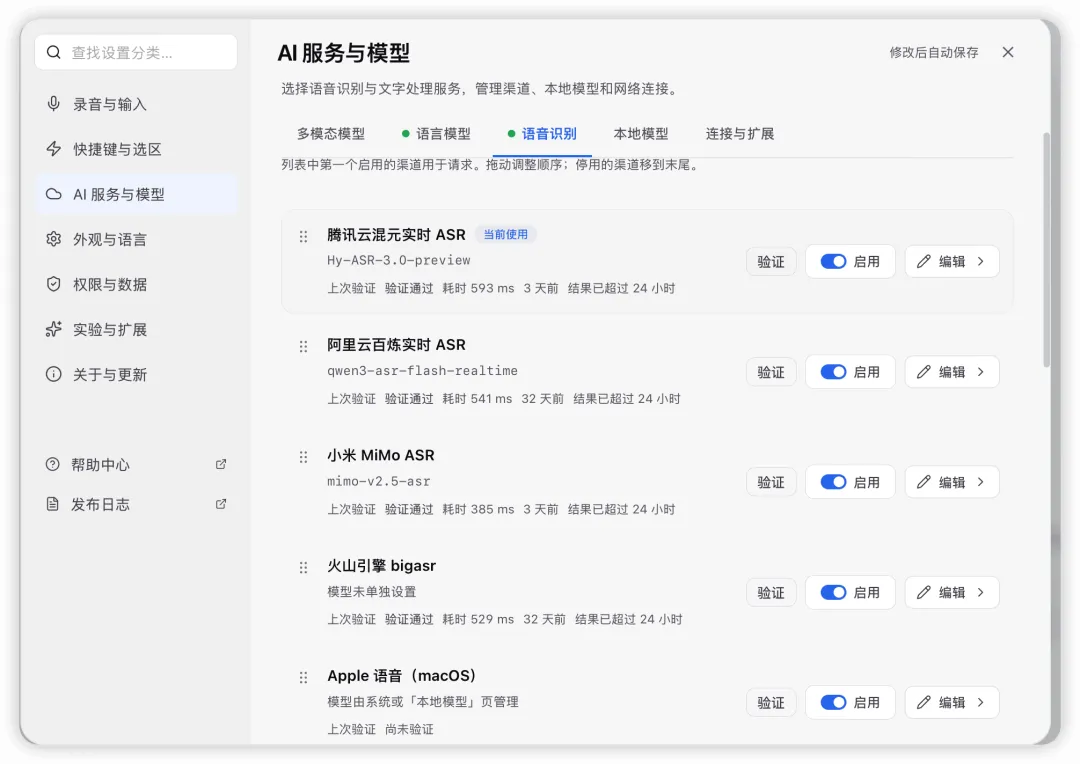 OpenLess 中 ASR 模型的选择
可是,该从哪些角度判断一个模型是否适合我呢?用了一段时间的语音输入后,我大概知道自己更关注哪些场景。比如在工位上,周围有各种杂音,模型还能不能准确识别?又比如晚上在家,孩子已经睡了,我只能轻声说话,甚至接近耳语,模型还能不能识别到位?
我本来想写一篇文章,系统地聊聊 OpenLess:比如如何选择语音识别模型(ASR),它的润色模型以及润色方案等,还有 OpenLess 的使用。但这个语音识别的评测比较独立,而且也算是很重要的一个模块,我们就先单独聊一下。
这次只比较 ASR 原生 API 直接返回的识别结果,不经过润色模型。OpenLess 是我日常使用这些模型的入口,正式评测则把同一批录音交给各个 ASR 接口,方便比较和直接。
评测目标:测哪些模型?
我根据 OpenLess 所支持的模型,选了一些比较容易获取的,加入到测试目标里。目前已经囊括了几个大厂的模型,另外补充了本地模型。如果你像我一样用 macOS,可能也想知道 macOS 设备端语音识别效果怎么样,那就把它也加进来评一评。虽然免费,但要是效果不好,咱也不会用。毕竟咱也不是完全没要求的人,对吧?
| | |
|---|
| | Qwen3-ASR-0.6B |
| | SFSpeechRecognizer |
| | Hy-ASR-3.0-preview |
| | volc.seedasr.sauc.duration |
| | fun-asr-realtime |
| | qwen3-asr-flash-realtime |
| | stepaudio-2.5-asr |
| | openai/whisper-large-v3-turbo |
| | spark_asr_v2 |
| | mimo-v2.5-asr |
下文统一使用第一列的名称,实际调用的模型或接口标识列在最后一栏。其中,豆包流式 ASR 对应 OpenLess 中的 Big ASR;腾讯混元 ASR 3.0 本次使用的是 preview 版本。
评测建模:什么叫“适合我的 ASR”
有了上面这份模型列表,那接下来怎么测试它们呢?作为一个程序员,我日常对语音的使用应该和一般人有些不一样,比如会穿插一些专业术语,有时难免中英混杂。一般和同事沟通时,微信或豆包语音输入法的识别效果其实也勉强够用,那是因为众所周知,人的纠错能力是超强的。但在编程或与 AI 交互时,虽然 AI 有一定的纠错能力,识别错误仍可能误导它。我也了解了一些 ASR 的评测体系和指标,比如 CER 等错误率指标,确实有一定参考价值。但我觉得,按自己的使用场景设计评估维度,更适合这次评测,所以没有直接照搬现成的评测方案。以下是我的评估维度:
| | |
|---|
| | |
| | 避免把金额、编号、项目名或“不要”等否定词写错,这类错误有时比较要命 |
| 轻声耳语;噪声、远距离和停顿;静音误输出;约 90 秒单段完整性 | 检查轻声是否被拒绝、静音是否凭空出字,以及长录音是否真的处理到末尾 |
| | |
| | 额外加分项,热词可能救回专有名词,也可能把普通词误写成专名;不同模型对它的支持程度也不一样 |
这些维度覆盖了我过去个把月使用语音输入时遇到的主要场景,也包括一些特殊问题:比如模型出现幻觉(没说却出现)、漏掉部分内容(掉句),或者不支持长语音(说了一大段却没转成功的悲伤)。还有,有些模型在正常音量下表现不错,但一旦轻声细语,识别准确度就会大打折扣。
评测用例:具体用哪些内容来验证?
最开始,我用 OpenLess 日常使用中留下的一些历史记录来跑评测。这种方式很容易上手,录音也都保存着,内容比较贴近日常。但等我想清楚该从哪些维度评估模型后,就发现仅靠这些历史记录还不够。主要有两个问题:
- 用例完全取决于我的使用场景,不够通用,各类场景的比例也不好控制,难以全面展示模型的表现。
- 每段已有录音仍需要重新听一遍,整理并校对准确的参考文本,工作量也不小。
所以我和 AI 一起重新设计了评测方案。我们基于测试目标,创建了一个网页,展现各个场景的用例,并由我来一一录音。我尽量按提示文字来读,再回听确认参考文本。这样就不用从零整理每段录音的文字了,能省不少事。
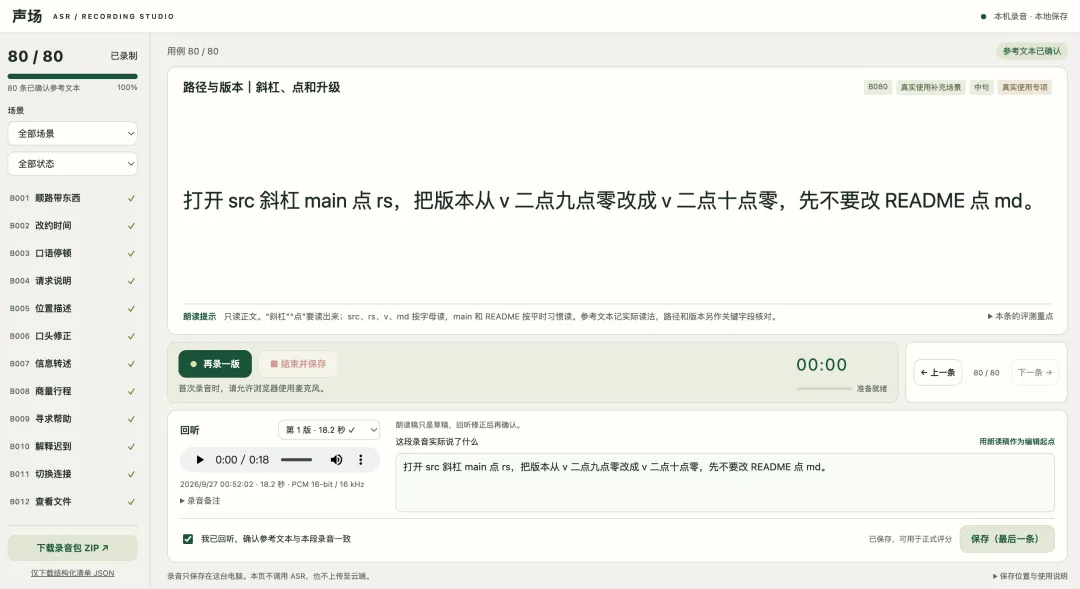 ASR 录音页面
用例覆盖以下八类场景,每类十条,共八十条:
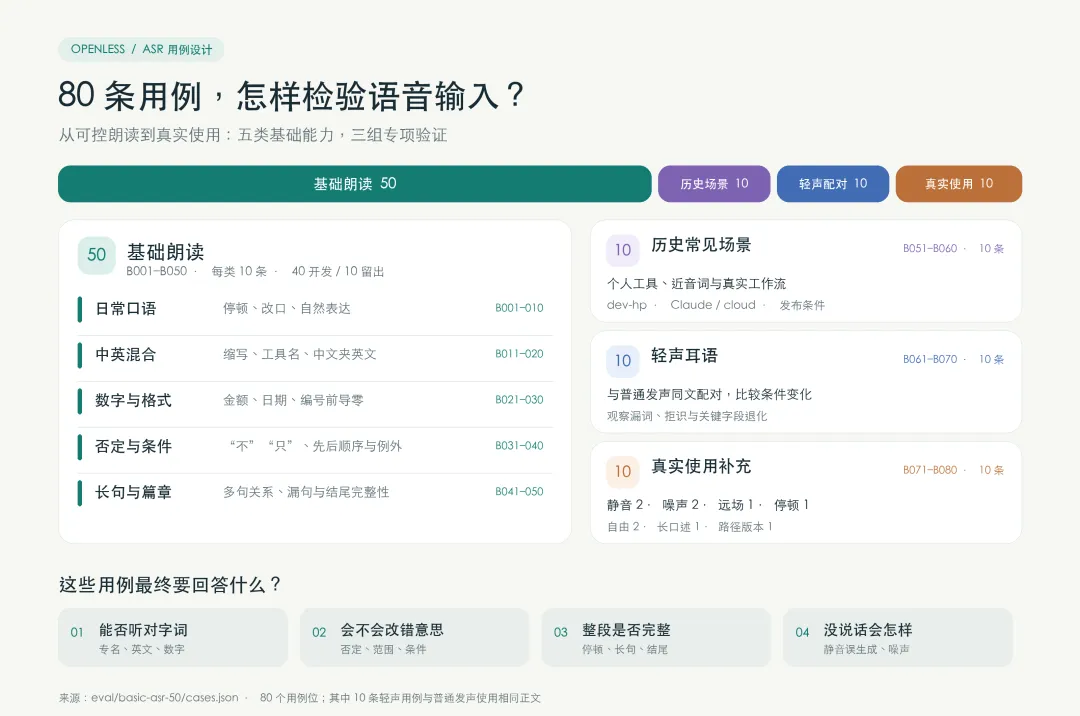 80 条 ASR 用例设计
评测结果:是时候见证各位的实力了
❯ 第一轮:原生基本功比拼
我把测试分成了不加热词和加入热词两轮,因为有些 ASR 不支持热词,或者有些软件本身不支持上传热词。我们先看不加热词时,各个模型的原生识别能力如何。
注:表格中通过上下箭头表示是越高越好还是越低越好,帮助理解。
本地 Qwen3-ASR 0.6B
| |
|---|
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| 普通口语和数字稳,完整处理长录音;轻声较弱,文件处理等待较长。 |
macOS 设备端语音识别
| |
|---|
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| 设备端处理快、静音干净;中英混合、技术词和轻声较弱。 |
腾讯混元 ASR 3.0
| |
|---|
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| 轻声、技术词和实时首字较好;约 90 秒录音超限,曾有一次连接超时。 |
豆包流式 ASR
| |
|---|
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| 实时收尾快、普通长句可用;轻声退化,曾把 8℃ 写成 80℃。 |
百炼 Fun-ASR
| |
|---|
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| 中英混合、轻声和实时反馈较均衡,长录音完整;专名仍需校对。 |
百炼 Qwen3-ASR Flash
| |
|---|
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| 普通长句和补充场景不错;轻声和实时首字较弱,曾误写 GB 单位。 |
阶跃 StepAudio 2.5
| |
|---|
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| 普通长句和数字好;两条轻声录音被拒绝,其余轻声录音的识别结果也错得较多。 |
OpenRouter Whisper Turbo
讯飞语音听写 V2.0
| |
|---|
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| 轻声与历史场景较好;约 90 秒录音提前结束,首字反馈较晚。 |
小米 MiMo 2.5 ASR
| |
|---|
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| |
| 有声整体与轻声字面误差最低,长录音完整;两条静音都误输出“嗯”。 |
备注:总体 CER 使用 74 条共同可比较的录音,静音误输出和约 90 秒录音的完整性另列。
为了更直观地看出各模型的长处和短板,我把上面的结果整理成五星评级。★★★★★ 表现好,★★★★☆ 整体可用、有少量不足,★★★☆☆ 需要明显修正或取舍,★★☆☆☆ 有较大短板,★☆☆☆☆ 本场景不宜优先。星级越多越好,允许并列,五星也不代表零错误。
本地 Qwen3-ASR 0.6B
macOS 设备端语音识别
腾讯混元 ASR 3.0
豆包流式 ASR
百炼 Fun-ASR
百炼 Qwen3-ASR Flash
阶跃 StepAudio 2.5
OpenRouter Whisper Turbo
讯飞语音听写 V2.0
小米 MiMo 2.5 ASR
表中的“—”表示本次没有可评分的实时逐字反馈数据,不等于模型一定不支持实时识别。“结果等待速度”分别按整文件处理或流式音频发完后的等待评分,两种计时起点不同。静音只有 2 条、约 90 秒录音只有 1 条,相关星级只描述本批表现。
我让 AI 根据各模型的表现,结合我正常说话和轻声低语的使用场景,排出了下面的前三名。不知道这是否符合你的预期?
其实最开始我忽略了小米 MiMo 2.5 ASR,根本没打算把它加进来。这是因为最开始我收集了一下这些模型每秒钟的费用,这个模型定价还挺高的,我想你何德何能呢?但加进来以后还是让我挺惊喜的,确实有两把刷子。
以下排名和总结部分由 AI 完成,未加修改。
第一名:小米 MiMo 2.5 ASR——优先作为内容识别基线
- 推荐理由: 共同集 CER 最低(4.01%);轻声 9.59%,数字关键字段 10/10,普通长句 0.81%,B079(超长语音) 完整完成。多个有声场景同时较好,整段上传后的等待时间也短。
- 主要短板: 两条静音均输出“嗯。”;中英混合和个人技术词并非本批最强。此次验证的是整段上传后的识别,不把它当作已经验证的实时逐字方案。
- 适合怎样用: 优先用于明确有语音的整段口述。如果应用会经常提交静音,必须把这项误输出看作未解决问题,不能假定加一个未经测试的过滤器就能消除。
第二名:腾讯混元 ASR 3.0——优先作为实时交互候选
- 推荐理由: 共同集 CER 5.76%,个人历史场景 3.20%;轻声 10.10%,与普通发声相比退化较小;首字约 1.38 秒,静音不生成多余文字。数字关键字段核验也为 10/10,不应因数字转写格式吃亏。
- 主要短板: 一次连接超时;B079 超限未完成;Claude/cloud 的区分仍有误改。不能把它直接作为本次约 90 秒不切段输入的唯一通道。
- 适合怎样用: 更重视边说边看到文字、轻声输入和技术口述时,它比只看总体 CER 更有吸引力;若静音克制与实时反馈比整段准确率更重要,我会把腾讯混元 ASR 3.0 放到小米 MiMo 2.5 ASR 前面。
第三名:百炼 Fun-ASR——覆盖较均衡的实时候选
- 推荐理由: 中英混合 CER 6.03%,轻声 15.03%;数字关键字段 10/10,静音无多余输出,B079 完整完成;首字约 1.49 秒、音频发完后等待约 0.21 秒。它并不是每项都拿第一,但对本轮多种输入的覆盖更均衡。
- 主要短板: 共同集 CER 7.60%,在有声录音的整体识别和轻声识别上,表现都不及小米 MiMo 2.5 ASR 和腾讯混元 ASR 3.0;专名仍会误认,不能以“总体均衡”替代后续热词验证。
- 为什么第三名不是讯飞语音听写 V2.0 或本地 Qwen3-ASR 0.6B: 讯飞语音听写 V2.0 轻声更好,但本配置首段文字较晚且 B079 提前结束;本地 Qwen3-ASR 0.6B 共同集表现好、设备端运行,但轻声为 22.54%,处理等待也更长。在我已经明确关注轻声的前提下,百炼 Fun-ASR 更适合作为第三个综合候选。
AI 还找补了一下,但我觉得它说得对。实际选择按自己的需求调整:
- 如果离线是硬要求: 将本地 Qwen3-ASR 0.6B 放进前三,作为本批设备端首选;这来自其已验证的本地运行与更好的文本质量,不依赖云端价格假设。
- 如果基本不用轻声、主要是普通长句: 阶跃 StepAudio 2.5 值得重新优先考虑,普通长句和数字表现好、整段上传后的等待时间短;本轮没进前三,主要是轻声错识与误拒绝。
- 如果想保留一个百炼方案: 本轮更倾向百炼 Fun-ASR。百炼 Qwen3-ASR Flash 在普通长句和补充场景很好,但轻声明显更弱,实时首段反馈也更晚。
❯ 第二轮:支持热词模型比拼
在 OpenLess 里,热词是一个可能比较有用的、用来减少语音识别错误的机制。简单说,就是提前告诉 ASR 我可能会说到哪些专有名词,比如 Claude,让它更有机会听对名字;但也可能矫枉过正,把普通的 cloud 认成 Claude。
不过,这次参测的模型中只有部分支持热词,那就让它们再跑一轮。还是之前的八十条录音,加上热词以后,识别准确率会有多大变化?腾讯混元 ASR 3.0、豆包流式 ASR、百炼 Fun-ASR 和阶跃 StepAudio 2.5 都宣称支持原生热词,申请出战;AI 说 macOS 设备端语音识别也支持自定义词汇提示,那就让它一起参战吧。因为参加的选手比较少,我们很快就有了结果。
热词本身的收益与副作用
| | | |
|---|
| | | |
| | | 专名改善明显,整句 CER 小幅变差;B053 的 cloud 普通词依然被写作 Claude。 |
| | | |
| | | 专名和整句 CER 同向改善;B053 从两个 Cloud 变成两个 Claude,普通词仍错。 |
| | | |
备注:以“16/26 → 24/26”为例,表示同一批可比较的目标词出现机会中,不加热词命中 16 次,加热词后命中 24 次,共 26 次;这里统计的是目标词有没有按期望拼写出现,不代表整句话都正确。“整句配对 CER”则比较同一个模型对同一批录音加热词前后的结果,统计范围与第一轮共同 74 条不同,不能直接相减当作热词收益。
这一轮我们也评个前三名吧。腾讯混元 ASR 3.0 的热词收益看起来比较明显。豆包流式 ASR 的结果则让我有点疑惑,一度怀疑是不是测试出了问题。我让 AI 再检查了一遍测试参数和配置,看起来没有问题,但结果仍出乎意料:我最期待它救回来的那些目标词,一个都没多认对。
以下排名及点评由 AI 完成,未加修改。
第一名:腾讯混元 ASR 3.0
- 26 次目标词出现机会中命中 24 次,比不加热词时的 16 次明显增加;共同集 CER 约 6.08%,轻声 CER 8.55%,首字约 1.40 秒。
- 代价是本批整句配对 CER 由 6.07% 微升至 6.34%;B053 的 Claude/cloud 歧义未解决,B079 约 90 秒录音在原生配置下已知超限。适合较短的实时技术口述。
第二名:百炼 Fun-ASR
- 目标词命中由 12/27 提升至 19/27,配对 CER 7.80%→7.17%,轻声 CER 12.95%;B079 完整,静音两条无多余输出。首字约 1.64 秒。
- 专名仍未全部识别,且 B053 的普通 cloud 被热词拉向 Claude。若要在长音频和词表收益之间取得平衡,它是这一轮较稳妥的候选。
第三名:阶跃 StepAudio 2.5,仅限轻声很少的整段输入
- 普通长句、数字字段和 90 秒整段处理较好;目标词有 1 个新增命中,配对 CER 7.60%→7.35%。
- 10 条轻声中仅 8 条被接受,接受的 8 条 CER 仍达 51.79%;不应把它作为轻声输入的主方案。若轻声是刚需,本轮只支持优先比较腾讯混元 ASR 3.0 与百炼 Fun-ASR,第三名并无同级替代。
❯ 总结陈词
把第一轮和第二轮的结果汇总后,就得到下面这张表。可以看到,没有哪个模型在所有方面都遥遥领先,几个头部模型各有优劣。具体使用哪一款,要看你自己诉求啦,它们的能力水平我已经给你提供参考了。
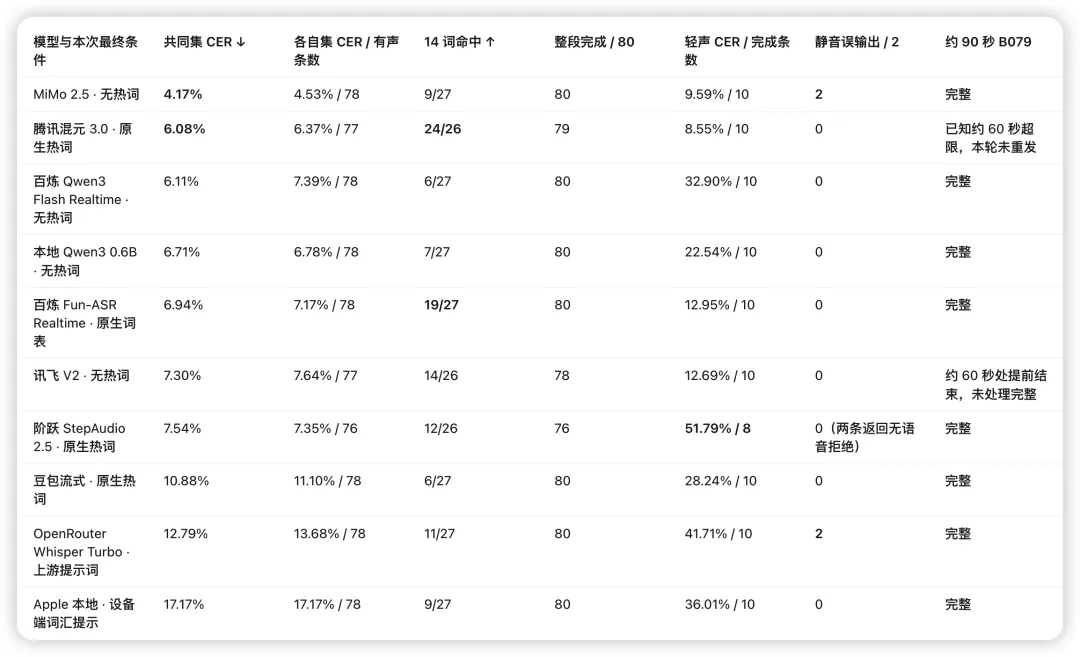 ASR 最终汇总
后记
到这里,我们的评测也结束啦。现在大概能看清各个 ASR 的表现了。不知道你看完以后会选择哪个呢?这期间我这里没有考虑价格因素。因为我们的输入量级并不多,成本很低,所以核心还是尽量减少返工和人工干预,能一次搞对最好。
至于开头那个“能不能本地跑模型”的问题,答案是能。本地 Qwen3-ASR 0.6B 在普通口语上已经够我用了,也不用支付云端 API 的调用费用。不过,本地运行要给模型留出足够的内存,实际占用和响应速度还取决于机器与运行配置。这一轮里,它的轻声识别较弱,等结果的时间也更长,所以暂时没有被我选成主力。想本地畅用,还是得接受一些硬件和等待时间上的取舍。
我自己的话,测完以后会优选腾讯混元 ASR 3.0,其次把小米 MiMo 2.5 ASR 和百炼 Fun-ASR 这两个作为备选。腾讯混元 ASR 3.0 是实时接口,配合 OpenLess 的实时文字展示,体感上会好一些。但它不支持超过六十秒的长录音。这块倒不是难点,之后的文章我会解决这个问题。
接下来,我打算聊一下如何用 OpenLess 做好语音输入。除了选对模型以外,还有一些小技巧,后面有机会和大家分享一下。欢迎点赞、关注、收藏哦~
我是个爱折腾技术的工程师,也乐于分享。欢迎点赞、关注、分享,更欢迎一起探讨技术问题,共同学习,共同进步。为了获得更及时的文章推送,欢迎关注我的公众号:爱折腾的风
