AGENT 评测避坑 · 方法论连载 02
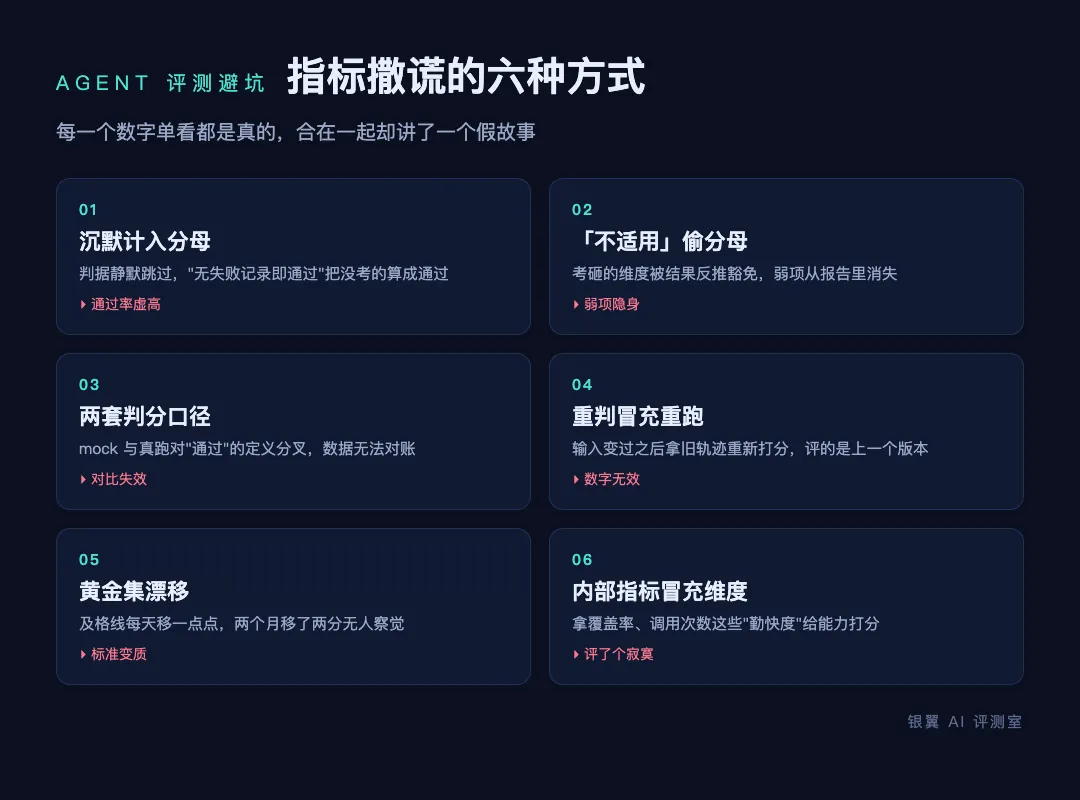
评测报告全绿,产品还是翻车?指标撒谎的六种方式
先讲一个场景。
有位团队负责人拿着一份评测报告来问我:通过率 98%,各项指标全绿,这产品能上生产吗?
我说:先别看绿灯,先问一个更基本的问题——这份报告的分母里,少了谁?
他愣住了。回去一查,问题就出来了:有整整一批用例根本没真正测到,但它们既不在"通过"里,也不在"失败"里——它们从分母里消失了。
上一期我们讲了五种「假通过」,那是结果层的造假。这一期往下挖一层——指标层的撒谎:每一个数字单看都是真的,合在一起却讲了一个假故事。
下面六种方式,每一种都对应我们真实踩过的坑。
评测框架有个默认逻辑:没有失败记录,就算通过。
这在传统软件测试里大体安全——断言挂了会炸异常。但 AI 评测里,判据会因为维度不适用、前置数据缺失、能力未配置而静默跳过。这些沉默的用例没有失败记录,就被白白计成了"通过"。
我们有一次框架升级后,通过率不降反升,对账才发现一批用例的判据一条都没执行过。
修法:零判据,不许通过。一条用例要么有实测依据支撑"通过",要么标记"不可判定"退出统计。宁可承认没测到,不能假装考过了。
「不适用」本来是个诚实的设计:能力确实没配,就别硬考。但一旦"不适用"可以由结果反推——考砸的维度事后找个理由标成不适用——它就变成了免死金牌。
更麻烦的是统计上完全看不出来:报告只会说"该维度不适用",不会说"它其实考了,考砸了"。
修法:豁免必须由客观前置条件触发,不能由结果反推。而且分母的每一次变化都要显式可见——通过率分母从 100 变成 80,那 20 条用例去了哪,必须能对账。
03两套判分口径:mock 的数据和真跑的数据没法对账
评测系统内部会有模拟运行和真实运行两条链路。踩过的坑是:两条链路的判分逻辑各自演化,同一份用例,mock 跑出来是绿的,真跑出来是红的——不是产品不稳定,是两套口径对"通过"的定义就不一样。
这时候报告里的数字怎么合?合不了。所有跨口径的对比、趋势、回归全部失效。
修法:判分口径单一来源。无论 mock 还是真跑,判定逻辑必须出自同一份实现,输出的结果结构必须完全同形。
发现判分规则有 bug,修复之后怎么办?正确的做法是重跑——重新执行评测,生成新证据。但重跑很贵,于是有个诱人的捷径:拿旧轨迹重新判一遍。
坑在哪?如果两次判分之间,被测对象的输入变过——换了系统提示词、换了工具配置——那落库的旧轨迹根本不是新输入下产生的行为。重判出来的数字再漂亮,评的也是"上一个版本"。
修法:改了被测对象的输入,必须重跑,重判无效。跑之前还要冻结环境:数据快照、配置哈希、源码哈希,保证跑出来的东西可复现。
黄金集是你锚定的"标准答案集":每次评测先跑它,分数稳定说明评测系统本身没坏。但黄金集自己也会坏——模型升级、提示词调整、依赖服务更新,都会让同一份黄金集跑出不同的分数。
危险的是这个过程是渐变的:今天 99.2,明天 98.8,后天 98.1——每一天的变化都"可以接受",两个月后你的及格线已经不知不觉移了两分。
修法:给黄金集设漂移阈值(我们定为 0.1),超了就告警,人工确认是"标准该更新了"还是"系统坏了"。漂移本身不是错误,无人察觉的漂移才是。
最后一种最隐蔽。评测报告里的维度,本该回答"产品能力强不强";但有种诱惑是把平台自己的内部指标包装成维度——覆盖率、调用次数、字段完整度。
这些数字很好看,也很容易全绿,因为它们衡量的是"评测系统干活勤不勤快",不是"被测对象行不行"。用勤快度给能力打分,评了个寂寞。
修法:每一个维度必须能回答"它测量的是被测对象的什么能力",回答不了的,不许进报告。
六种方式摆在一起,规律和上次一样扎心:
它们都不是算错了数,而是数字在讲一个对系统有利的故事。
绿灯本身没有意义,绿灯相对于一个诚实的分母才有意义。看评测报告,先别看通过率,先问三句:分母里少了谁?口径是几套?及格线什么时候动的?
如果你只记住一句话,记住这句:指标不会说谎,但报指标的系统会挑着说。
银翼 AI 评测室 · 评测方法论连载 02
愿所有 Agent 都经得起 Voight-Kampff 测试。