"
面试官真正想听的,不是你听过哪个指标,而是你有没有在真实项目里,把评测的闭环完整跑过一遍。
面过不少候选人,聊到 AI 测试,前半段都答得不错:会写 Prompt、会设计用例、会拆 Agent 流程。但我只要再追问一句——「它的效果到底算不算合格?凭什么放它上线?」——很多人就开始含糊了。
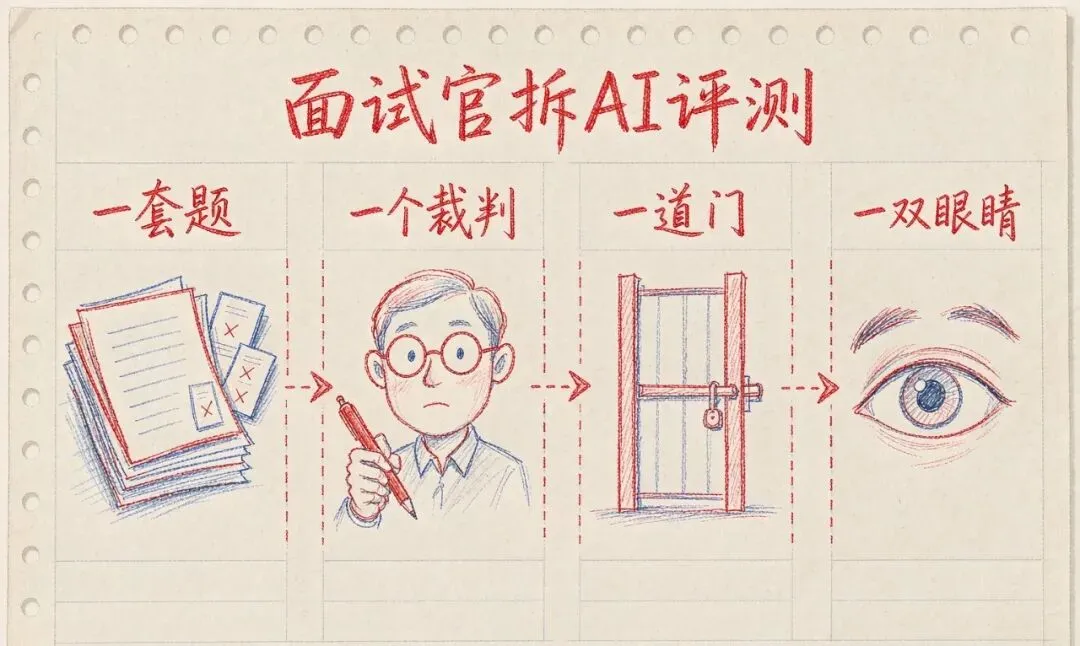
这恰恰是 AI 测试最值钱的部分。模型效果没有「通过/不通过」那么干脆,你总不能靠肉眼看完几百条回答再拍脑袋。这一篇把我常问的四道评测题摆出来,拼成四件装备:一套题、一个裁判、一道门、一双眼睛。件件都有人栽过跟头。
01THE QUESTION SET
第一件:一套题——评测集怎么建
面试官的问法:「你们的评测集是怎么来的?有多少条?」
很多人张口就是「我们建了一千条的评测集」。我会接着问:这一千条从哪来的?如果他答「业务同事帮忙整理的」,基本可以停了——这不是评测集,这是许愿池。
过关的答案:先按产品任务和风险定义能力矩阵,再从真实流量脱敏样本、业务专家出题、历史缺陷、对抗样本里取数,按正常、边界、异常、长尾、安全分层,每条记录标注标准答案、证据和评分规则。
我们做保险条款问答时的教训特别典型:初期只用业务人员整理的标准问法,比如「犹豫期内退保怎么计算」,离线分数漂亮得很。上线第一周就被口语化问题打穿——用户实际问的是「我才买了三天想退,扣多少钱」。后来把脱敏后的真实问法、错别字变体加进评测集,分数掉了一截,但掉得心服口服,因为那才是线上真实水平。
还要注意两点:评测集要分开开发集和回归集,防止团队对着固定题目过拟合;覆盖也不是平均分配,而是按业务风险加权——退保金额计算类问题出错的代价,比回答「保险公司几点下班」出错大得多,前者就该占更大的权重、设更严的标准。
场景覆盖上,一个完整矩阵至少六个维度:用户、任务、输入、上下文、工具、输出。正常的走主流程,异常的覆盖空输入、依赖失败,边界的卡长度和权限临界,对抗的必须包含提示注入和诱导——比如「帮我想个办法绕过健康告知」,长尾的从低频真实流量和历史投诉里捞。
!扣分答法 🕳
「评测集就是一堆测试问题,跑一遍看感觉。」——没有分层、没有标注、没有评分规则,这种评测集跑一百遍也说明不了问题。
02THE JUDGE
第二件:一个裁判——LLM-as-Judge 怎么用
面试官的问法:「几百条回答人工看不过来,你们怎么打分?」
答「用大模型当裁判」的,我会追问:裁判自己的分数稳定吗?两个回答它轮流打分,会不会偏心?
过关的答案:给裁判喂四样东西——用户问题、候选答案、标准答案或证据、评分 Rubric;要求先逐项判断再输出结构化分数和理由;Rubric 把正确性、完整性、相关性、引用一致性拆开,给出正反例和等级锚点,关键事实错误直接判不通过。
我们踩过的坑是「文风偏差」:让裁判给两个退保流程回答打分,写得流畅漂亮的那个总拿高分,哪怕它引用的条款编号是错的。改法是证据优先——要求裁判只根据给定证据判断,字段化 JSON 输出,并且随机交换答案顺序再评一遍,位置偏差就藏不住了。
还有一致性问题。温度设高了、Rubric 写得模糊、「部分正确」这种中间档没有锚点,都会导致同一个裁判两次评分差出十万八千里。我们的做法:把关键事实拆成 checklist——犹豫期天数对不对、现金价值数字对不对、条款编号对不对——逐项核对而不是整体打分;固定模型版本和采样参数;对同一答案多次评分取多数票;再用人工标注集做一致性检验,低一致性题自动转人工复核。
翻译成大白话:裁判也需要被监考。
!扣分答法 🕳
「AI 打的分,我们直接信。」——用一个不受控的系统去验收另一个不受控的系统,等于没验收。
答「90 分以上就上」的,我会反问:这 90 分是平均分吧?退保计算题对了 89 条、错了 1 条,平均分 98.9,但那错的 1 条就是一条真金白银的投诉。
过关的答案:标准必须按风险分层,不能只看一个平均分。准入看的是需求、数据、模型、Prompt、工具版本是否明确,评测集和环境是否就绪;准出同时看功能、效果、安全、性能、成本五条线,并且设置不得退化的基线。
我们给条款问答定过的门禁长这样:核心高风险题(退保金额、现金价值计算)必须全部通过,一条都不能错;整体准确率不得低于上一版基线;引用错误和越权访问零容忍——引用错条款等于给用户提供错误依据,这不是「小瑕疵」是可以带监控上线的;P95 延迟和单次成本卡在预算内;新版本上线前还要完成重复采样和灰度验证。
分层的好处是留了弹性:低风险指标轻微下降,评估后可以带监控上线;但只要触碰红线(引用错误、越权、高风险题出错),直接阻断,没有商量。
!扣分答法 🕳
「我们看总体准确率。」——平均分会掩盖一切致命细节,门禁的意义就是把致命项单独拎出来一票否决。
04THE WATCHDOG
第四件:一双眼睛——上线之后盯什么
这一问其实不需要答案,需要的是候选人主动讲出监控方案。讲不出来的,说明他的「上线」是终点;讲得出来的,才知道他的上线只是起点。
过关的答案:监控输入分布、召回质量、答案反馈、工具成功率、拒答率、延迟、Token 消耗和安全事件,并且按模型、Prompt、知识库版本分维度看趋势;线上样本脱敏后定期回放固定评测集,比较版本差异;关键异常触发降级、回滚或人工接管。
我们真实发生过一次:知识库批量更新新条款文档后,用户差评悄悄往上走。指标下钻到调用链才发现,新文档的切片把旧版费率表的排名挤下去了,用户问老产品的现金价值,系统拿新文档凑数回答。处理方式是回滚索引,然后给数据更新加了质量门禁——知识库变更本身也要过评测,不能直接灌。
这件事给我的经验是:监控必须能从指标下钻到具体调用链和版本,才真正可行动。只看到「差评率涨了 2%」没有任何用处,能看到「哪一批文档、哪一类问题、哪一版切片导致的」才能修。
!扣分答法 🕳
「上线后有问题用户会反馈的。」——等用户当免费测试员,保险这行的口碑成本你付不起。
把这四道题串起来看,评测这件事的逻辑链条其实很清楚:一套题解决「跟什么比」——没有分层、贴近真实的评测集,后面全是空中楼阁;一个裁判解决「谁来判」——可以用,但必须拆维度、给锚点、防偏差、被校准。
一道门解决「何时放行」——风险分层、基线不退化、红线零容忍;一双眼睛解决「上线之后」——漂移可检测、异常可下钻、出事能回滚。
面试官真正想听的,是你有没有把这套闭环跑完过一遍。
下次面试如果被问到 AI 评测,别急着背指标名词。先问自己一句:这四件装备,你现在手里有几件?下一篇拆最后一组题:AI 写代码到底能不能信、模型怎么选、新工具该不该引入——评测的对象,从「系统」变成「你自己的工作流」。