做生命科学 AI 的人,最近一定被一堆英文单词砸懵了。
LifeSciBench、MedChemBench、GeneBench、LabWorkBench、ProteinArena……每个名字都像,每个又都不像,根本分不清谁测什么、该信哪个。
而且还有个更大的坑:分数看着都很低(20%–60% 不等),很多人一看就懵了——是模型不行,还是题太难?
今天我把这套「评测全家桶」一次性讲清楚:5 大基准各测什么、核心数据是多少、该怎么看才不被数字忽悠。照着看,从此不再晕。
先给一张总览:5 大基准,各守生命科学一环
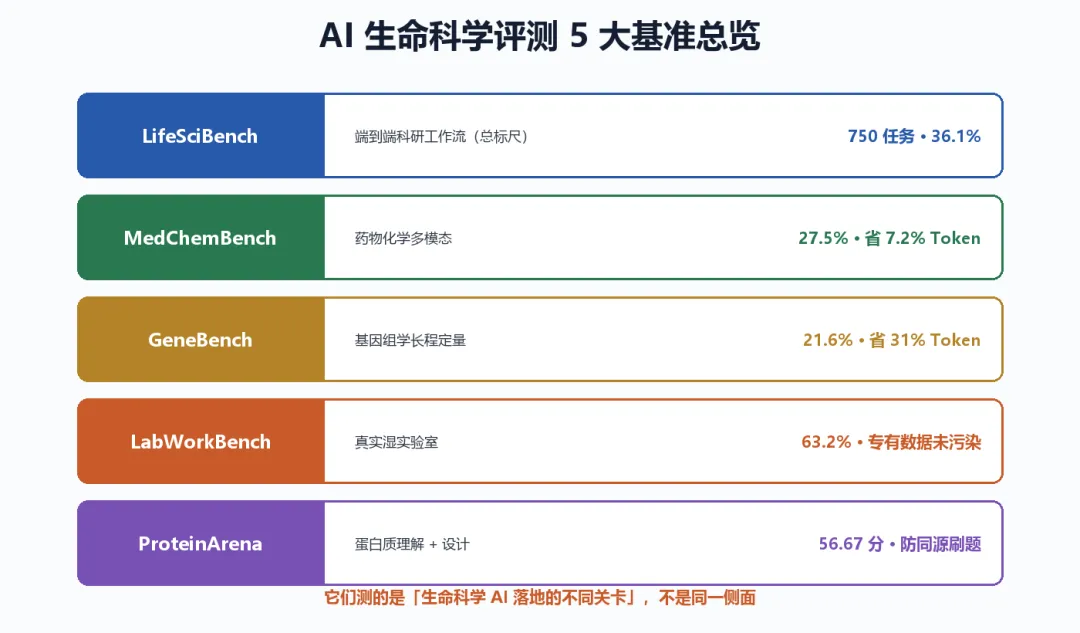
这 5 个基准不是随便凑的,它们覆盖的是生命科学从「研究」到「实验室」的不同环节:
| | |
|---|
| LifeSciBench | | |
| MedChemBench | | |
| GeneBench | | |
| LabWorkBench | | |
| ProteinArena | | |
记住一句话:它们测的不是「同一个 AI 的不同侧面」,而是「生命科学 AI 落地的不同关卡」。
 img
① LifeSciBench:最全面,也最该先看的「总标尺」
这是 OpenAI 刚发的「由专家撰写、专家评审」的基准,也是这 5 个里覆盖面最广的。
- •
规模:750 项任务,覆盖 7 类工作流 × 7 个生物学领域;
- •
硬核评审:453 位专家、19,020 条评分标准,评的是「对科研决策有没有用」,不是「答案对不对」;
- •
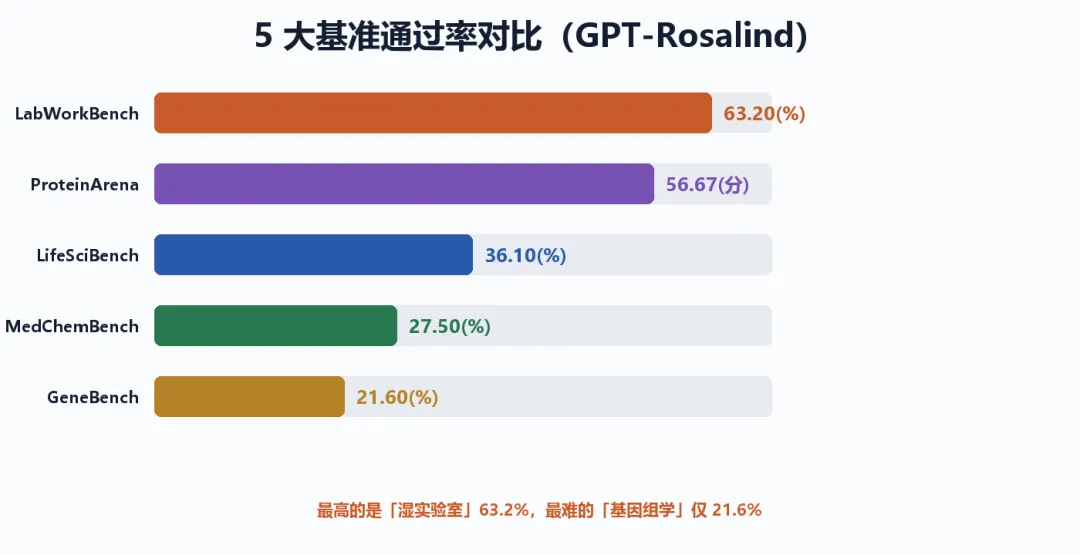
核心数据:GPT-Rosalind 整体精确通过率 36.1%(GPT-5.5 为 25.7%)。
怎么看:它是「总标尺」,看一个生命科学模型够不够格,先看它在这里的整体通过率。但注意——36.1% 已经是领先水平,说明整个领域离「能用」还很远。
② MedChemBench:药物化学的「多模态考场」
专攻「把分子变成有用药物」这件事。
怎么看:这是药物研发人最该盯的基准。它同时考「看懂分子结构」和「会逆合成」,多模态能力不够的模型,在这里会露馅。
③ GeneBench:基因组学的「长程定量」考核
测的是智能体在长程定量任务上的真本事——基于真实科学数据,能不能规划有效的分析、质控、建模、校正。
怎么看:这个分最低(20% 出头),因为它考的是最难的「长链条推理」。别被低分吓到,这恰恰是基因组学 AI 最真实的能力水位。
④ LabWorkBench:把 AI 请进「真实湿实验室」
这是 5 个里最特别的一个——它不考「纸面推理」,考的是模型在真实湿实验室方案里,能不能把「扰动」和「实验结果」联系起来,从故障排查到优化。
怎么看:这是 5 个里分数最高的,也是最贴近落地的。如果只看「AI 能不能真进实验室」,看它最靠谱。
⑤ ProteinArena:国产的「防作弊」蛋白质考场
上海 AI 实验室做的,专门破解蛋白质评测的「同源性信息泄露」顽疾——很多模型靠背同源数据刷分,这个基准用严格时间戳 + 同源性 <30% 划分,逼模型拿出真本事。
怎么看:这是**唯一强调「防同源刷题」**的基准。要判断一个蛋白质模型是「真懂」还是「背题」,看它。
 img
新手避坑:看这 5 个数字,最容易踩的 3 个坑
- 1.
别用一把尺子量所有模型——每个基准考的是不同关卡,MedChemBench 27.5% 和 LabWorkBench 63.2% 不能直接比大小;
- 2.
别被「领先」冲昏头——即使 GPT-Rosalind 在多个基准「领跑」,绝对通过率依然远未饱和(最低仅 20% 出头);
- 3.
注意「污染」陷阱——不是所有基准都像 LabWorkBench、ProteinArena 那样做了防污染/防同源处理,看第三方基准时先问一句「数据干净吗」。
总结:一套标准,看懂生命科学 AI 的真实水位
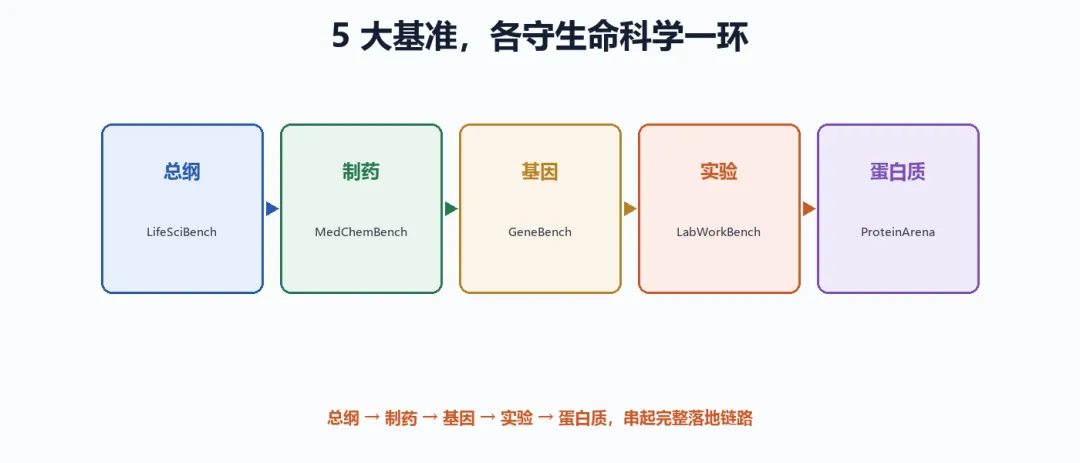
把 5 大基准记成一句话,就够用了:
LifeSciBench 看总纲,MedChemBench 看制药,GeneBench 看基因,LabWorkBench 看实验,ProteinArena 看蛋白质。
 img
它们共同拼出的,是生命科学 AI 当前的真实水位:领先模型在部分环节已能进实验室干活(63.2%),但在最难的端到端研究和长程定量推理上,仍只有 20%–36% 的水平。
看清这个水位,你才能既不盲目乐观,也不轻易否定——这才是看评测的正确姿势。
需要我把这 5 大基准整理成一张可收藏的对照表文档吗?评论区回复「清单」,一键领取。
本公众号聚焦AI for Science科学智能领域,持续追踪第五科研范式全球前沿动态。深度解读行业资讯、拆解落地案例,开展工具评测,输出可复用的工程实操指南。摒弃空洞概念,不堆砌虚浮理论,只分享一线硬核干货。欢迎关注+收藏,持续获取AI赋能科研的实践内容,做科研创新路上深耕技术的同行人。
