数据从一次性资源变为可持续产能
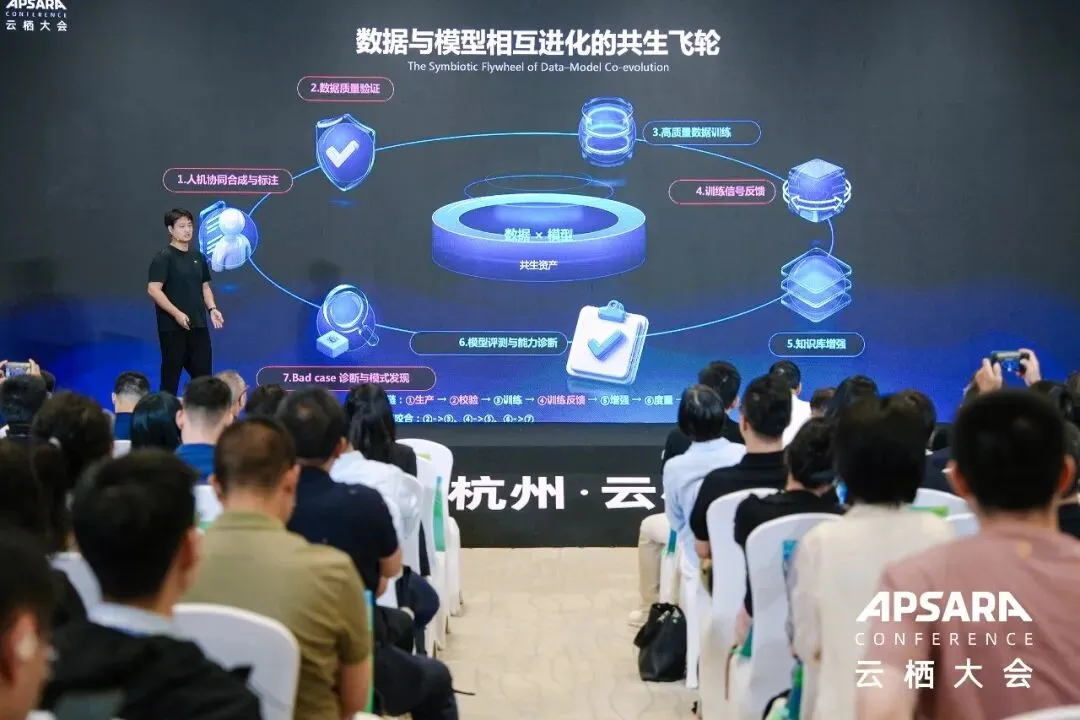
数据与评测如何协同驱动模型进化?阿里控股AI训练数据负责人吴鸣刚(小于号)指出,率先建立数据飞轮者,更有可能掌握下一阶段AI竞争主动权。
这一框架由 “模型→数据” 与 “数据→模型” 两个互相咬合半环构成:数据引擎持续供给,真实回流与评测信号锚定迭代,RL与推理进一步放大高质量数据需求,并以可验证奖励加速闭环,推动数据与模型螺旋上升,沉淀长期竞争壁垒。
启动「认知原点计划」,构建专家数据新生态
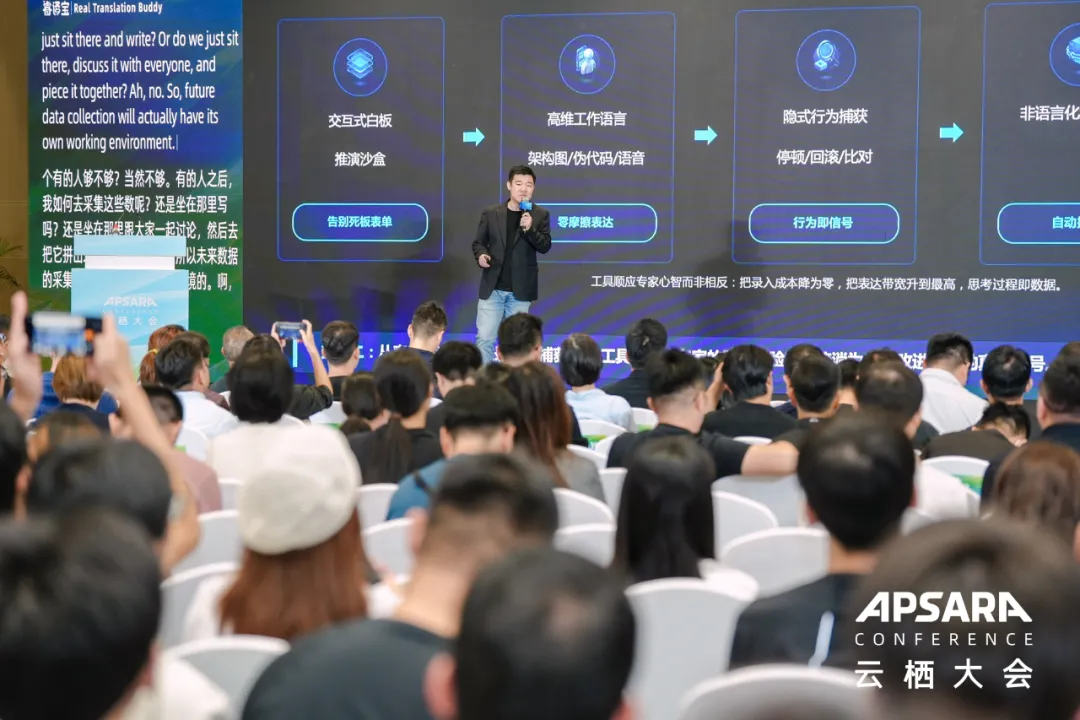
随着头部模型通用能力趋同,AI竞争正转向复杂专业场景。阿里控股AI数据生态与研究负责人羊志巍(羊巍)指出,私有、长尾和高价值数据难以通过公开爬取获得;模型自我改进越强,越需要外部可验证的真实信号,避免合成数据坍缩与奖励欺骗。
机器真正稀缺的不是更多“标准答案”,而是专家假设、证伪、纠偏和回溯的认知轨迹。这类数据应从会诊、架构设计、专业分析等真实工作流中沉淀。围绕这一命题,羊巍公布三项落地行动:面向全球医学、先进制造、金融合规三大深水区,开放晓天睿士专家社区1万个专家协同席位;加入开源生态共建数据集与评测集;联通线下、孤岛与碎片化数据。让更多稀缺的人类认知进入AI训练链路,以专业智慧拓展模型能力边界。
SKYEVAL面向海外上线,让评测成为可持续运营的公共能力
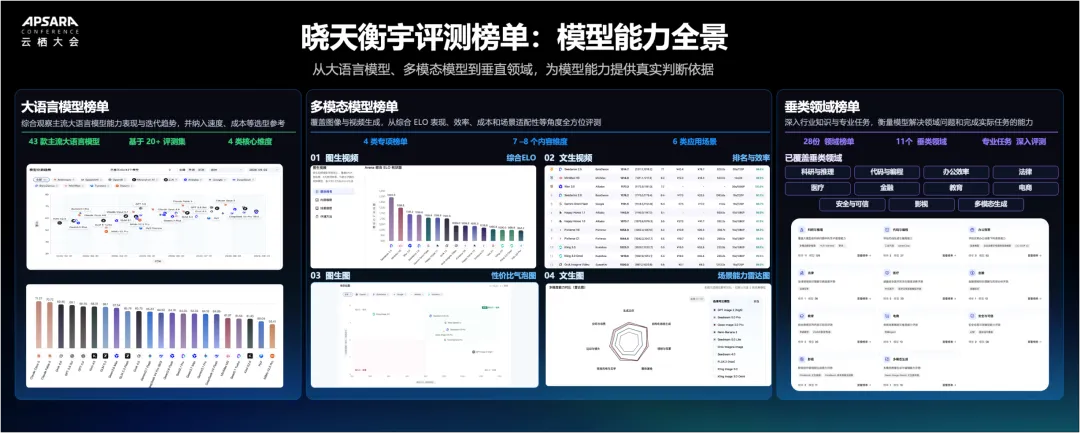
有了持续供给的数据,如何判断模型是否真正变强?阿里控股AI数据评测负责人许泽(雄道)指出Benchmark也可能出错、污染或饱和。好的评测基准应准确、稳定、诚实,评测需走向真实任务交付,综合考量模型表现、任务耗时、成本与用户体验;评分则应可验证、可复现,并结合自动验证、Agent裁判和人工复核。
基于此,SKYEVAL晓天衡宇评测社区已逐步形成覆盖评测集、裁判模型、榜单、竞技场与社区的生态,并面向海外上线,推动评测从静态榜单转向可持续运营的公共能力。
以具身数据桥梁,连接智能体与物理世界
当智能体进入物理世界,数据面对的是更复杂的真实环境。阿里控股AIData具身数据负责人孟泽楠(会天)提出,机器人走向真实生产,需要建立统一、可复用、可评测的数据基础设施。
围绕这一目标,Roboflywheel构建了仿真、评测、数据配方和数据集社区四层底座,并向高校、厂商与开发者发出生态共建邀请。通过连接分散的开放资源,推动标准、工具与验证体系协同完善,加速具身能力从局部突破走向稳定收敛。
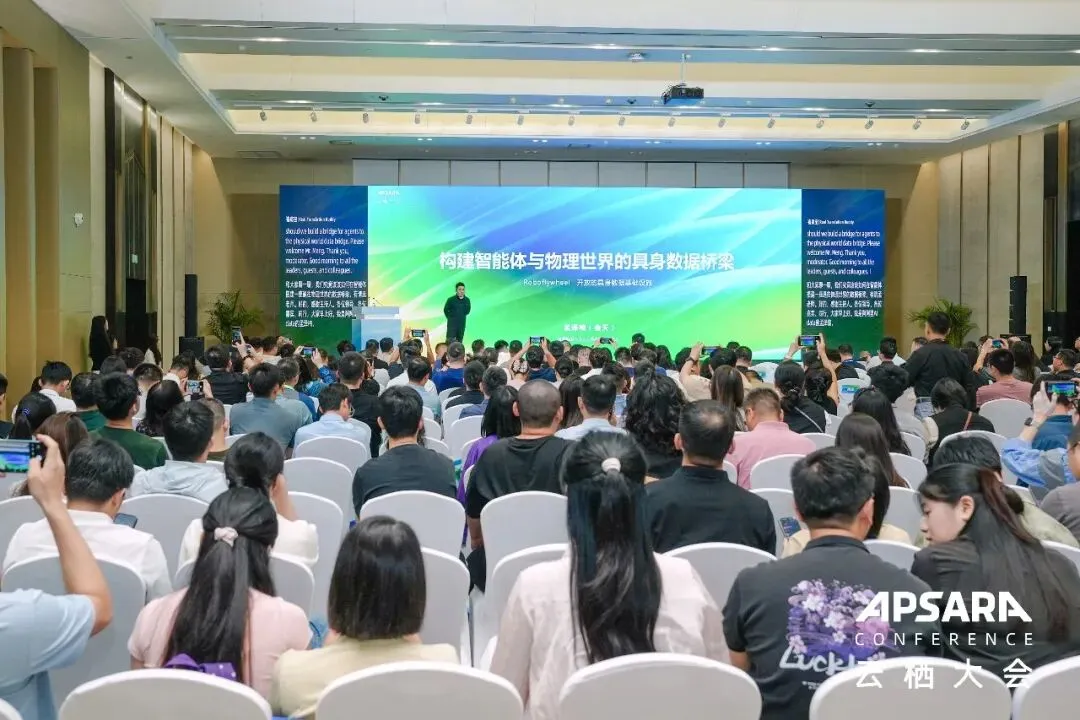
分论坛现场,多位海内外嘉宾从智能体评测、科学数据和人类经验出发,进一步讨论AI持续进化所需要的方法、基础设施与价值边界。
在均值之外,给多样性留参数,为独创力留可能
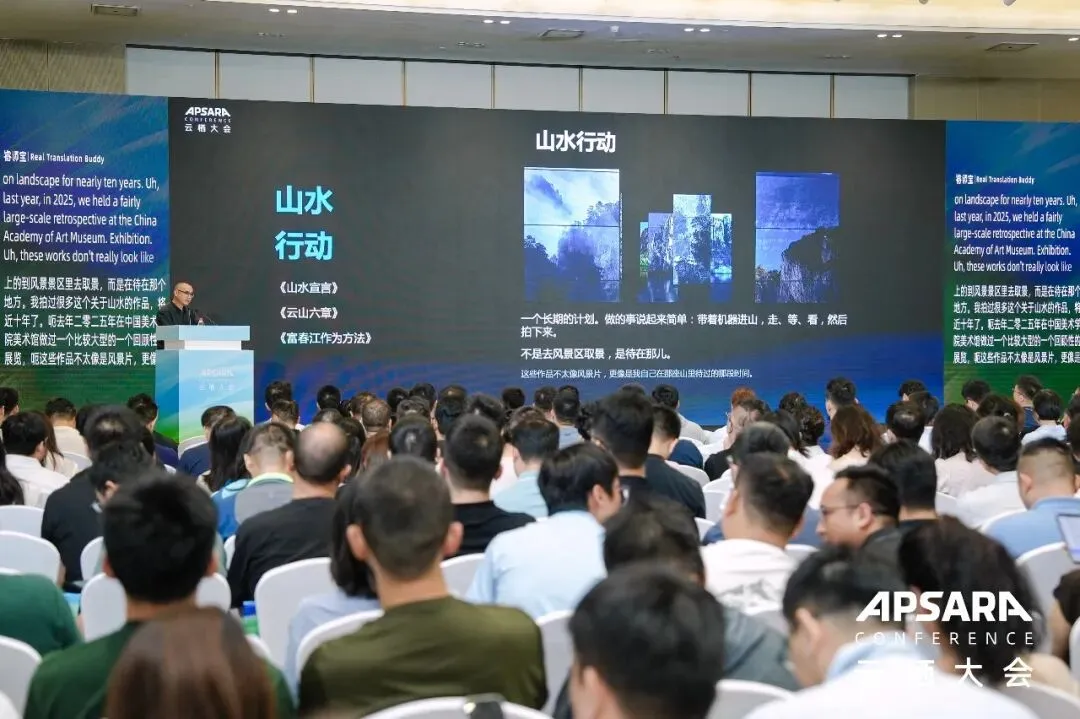
中国美术学院跨媒体艺术学院副院长高世强从审美与人的经验出发,为数据和评测划出另一条边界。
他提醒,当生成内容持续回流训练,分布的“尾部”可能被逐渐抹除,而突破往往来自偏离均值的经验。因此,数据与评测不能只奖励一致性和可预测性,更应为多样性和独创力保留空间。真正决定方向的,是人如何设定目标、参数、评价标准,并对结果负责。这为数据与评测补充了审美尺度。
让评测结果回到训练端
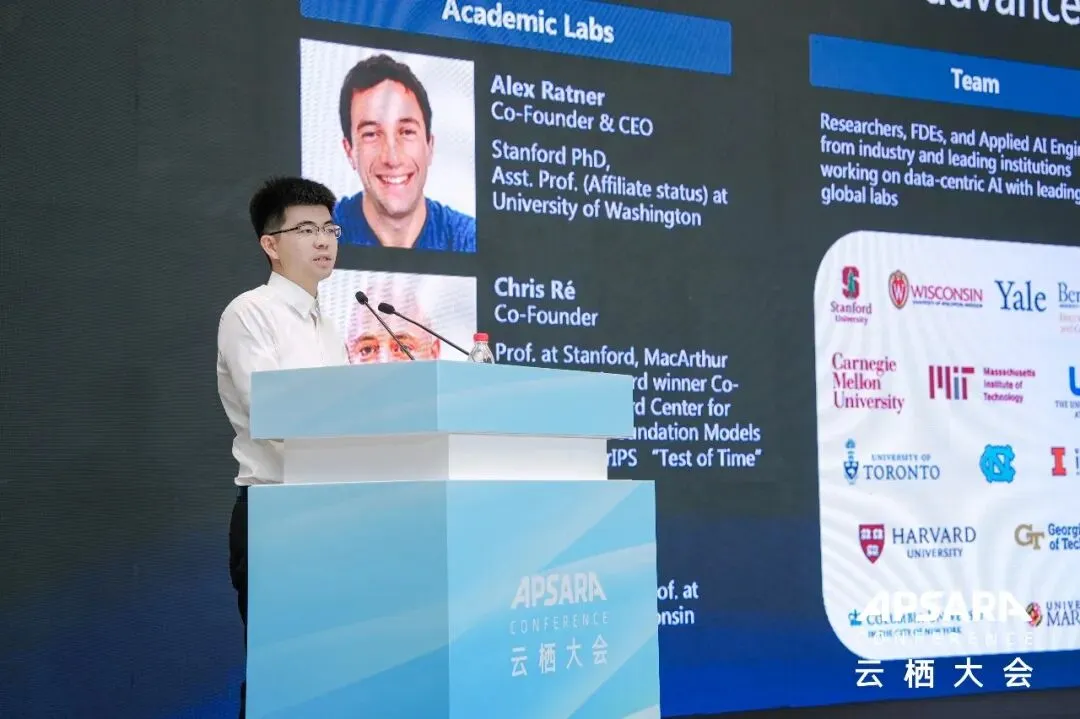
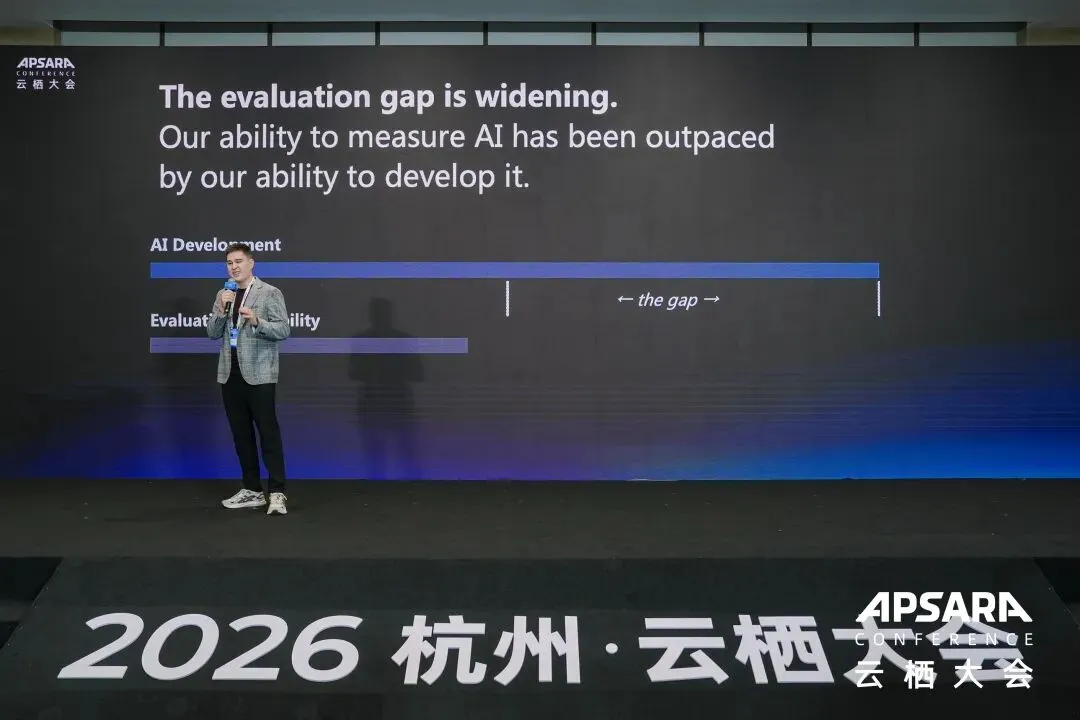
Snorkel AI负责人Patrick Tuffy和Nathan Xu认为,当前AI开发能力正在超过评测能力。一个好的基准,需要具备可信的测量仪器和研究议程双重身份。
进入智能体阶段,下一代基准需要沿环境复杂度、自主时程和输出复杂度三条轴展开。评测的终点不只是给出分数,更应把失败转化为训练任务与奖励信号,成为驱动智能体持续进化的数据引擎。
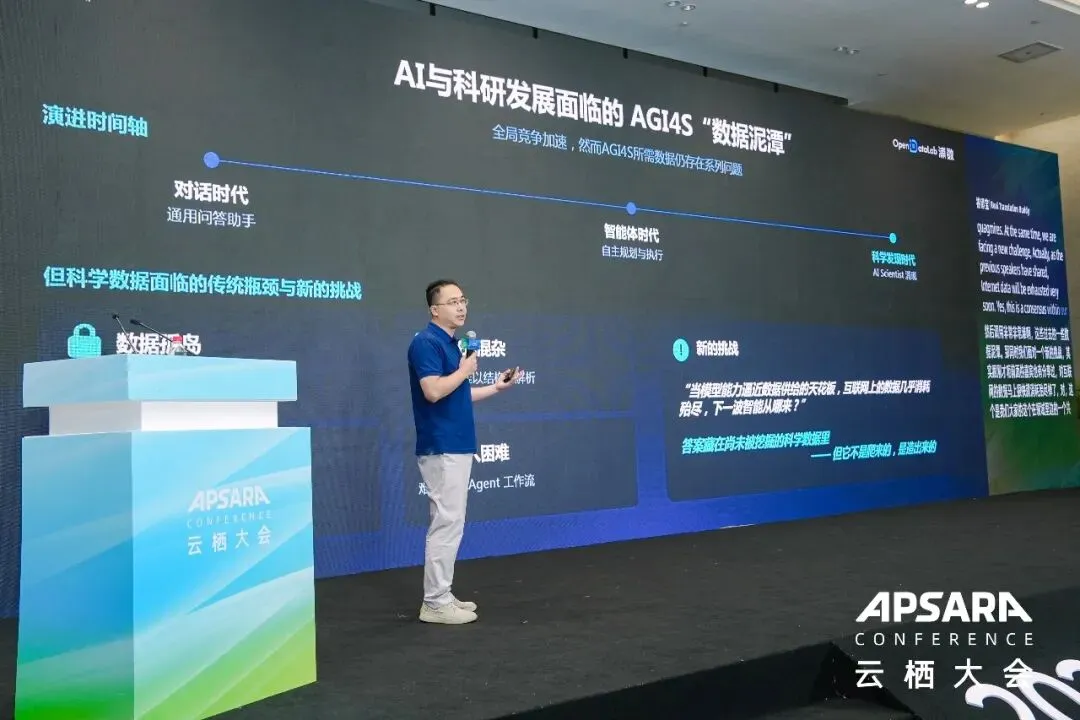
建设面向AGI4S的科学数据基座
针对科学数据孤岛、格式混杂、更新滞后与接入困难,上海人工智能实验室数据平台中心高级数据总监王广宇分享了团队正推动传统资源库升级为可解析、可调度、可验证的“数据工厂”。
实验室构建了科学数据基座Sciverse,涵盖Sci-Base、Sci-Align和Sci-Evo三层演进式体系。其中,Sci-Base已汇聚超4.7亿条元信息、3亿篇文献、7000万项专利和1亿册图书;基座依托MinerU将各类文献转化为结构化数据,通过化学专用管线加工垂域数据,为科学大模型与智能体提供有力数据支撑。
海量数据如同繁星,为模型提供广度与可能;科学严谨的评测则如灯塔,持续识别能力缺口、校准前进方向。二者还需要稳定运转的生产机制,让模型进步能够在真实场景中被验证。当高质量数据能够持续生长、可信评测能够不断校准、稀缺的专业智慧能够被理解和传递,AI才能从“拥有能力”进一步走向“可靠地创造价值”。