AI项目中,Eval(评测)的设计原则
- 更新时间 2026-09-28 23:24:35
AI项目中,Eval(评测)的设计原则Eval的设计原则是让 AI 项目从“能用”走向“好用”最关键的一环。没有 Eval,我们根本不知道 Agent 是变好了还是变坏了——尤其是当我们有多个 Agent 串联、Prompt 频繁迭代时。 AI 项目 Eval 的设计原则,聚焦在我们正在做的这类“多 Agent 串联 + 人机协同”的项目上。 一、先定义:AI 项目的 Eval 到底在评什么,不是评“模型好坏”(那是模型训练团队的活),而是评:在当前系统设计下,AI 交付物是否达到“可进入下一环节”的质量门槛。 对我们来说就是: 1)需求澄清 Agent 输出的澄清问题集 → 是否完整、是否精准 2)PRD 生成 Agent 输出的 PRD.md → 是否结构完整、无逻辑矛盾、无幻觉 3)原型生成 Agent 输出的 prototype.html → 是否与 PRD 一致、交互合理 4)质量门禁 Agent 的判断 → 是否正确拦截了不合格品 二、Eval 设计的六大原则 原则 1:分层评测(Layer Separation)不把“模型能力”和“系统效果”混在一起评。分三层: 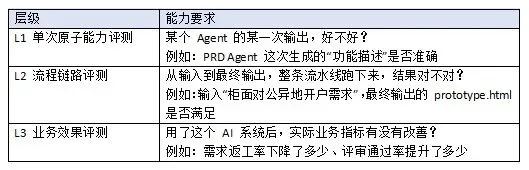
原则:先保 L1,再谈 L2,最后看 L3。L1 不稳,L2 和 L3 的数据毫无意义。 原则 2:多维打分(Multi-Dimension Scoring)不要只有一个“通过/不通过”。每个 Agent 的输出至少从以下维度打分: 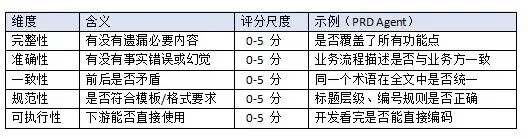
原则:每个维度独立打分,最后合成总分。不要用一个“总体印象分”掩盖具体问题。 原则 3:人机协同评测(Human-in-the-Loop Eval),AI 项目最大的陷阱是“用 AI 评 AI”——我们永远不知道它是不是在互相吹捧,处理方式: 1)自动评测:100% 覆盖,但只做粗筛(格式检查、关键词匹配、一致性校验) 2)人工抽检:只评自动评测标记为“可疑”的样本 + 随机抽 10% 3)人工反馈:人工的评分反过来校准自动评测的阈值 原则:自动评测求快,人工评测求准。不要试图让 AI 完全替代人的判断。 原则 4:对抗性评测(Adversarial Eval) 我们的 Agent 在“正常输入”下表现好,不代表在“边界情况”下也好。专门设计一批坏样本: 原则:Eval 数据集里至少 20% 是边界样本。如果只在 sunny day 上测,测出来的分数是假的。 原则 5:可复现与可追溯(Reproducibility & Traceability) 这是工程化 Eval 和非工程化 Eval 的分水岭。 每次 Eval 必须记录: 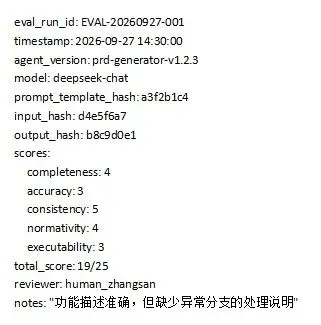
原则:每次 Eval 的结果必须能精确追溯到当时的 Agent 版本、Prompt 版本、输入、输出。否则我们无法判断“这次的改进到底有没有用”。 三、Eval 测评的设计(以需求分析的 5-Agent 流水线为例) 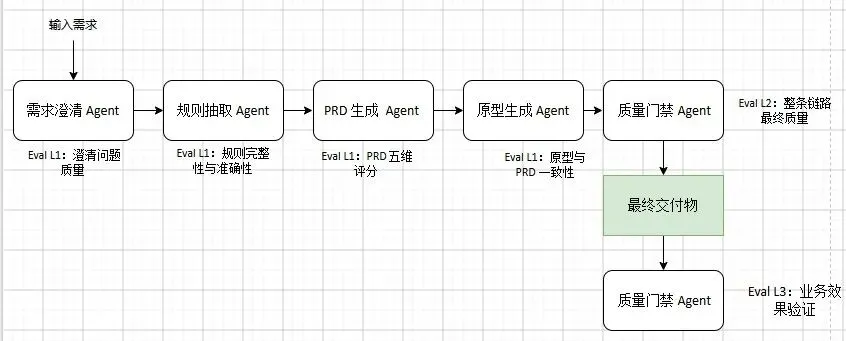
关键设计点: 1. 每个 Agent 输出后立即触发 L1 Eval,而不是等到整条链路跑完再评。这样能快速定位是哪个环节出了问题。 2. L1 Eval 的结果作为下一个 Agent 的输入上下文之一。例如 PRD Agent 知道自己的前序 Agent 的 Eval 分数,可以在生成时针对低分项做补偿。 3. 质量门禁 Agent 同时做两件事:判断当前批次是否合格 + 汇总整条链路的 Eval 分数形成报告。 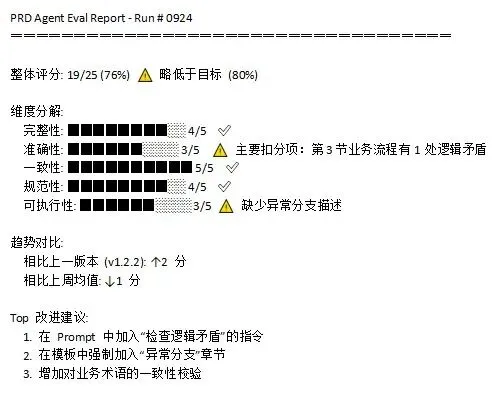
四、Eval 数据集的构建策略 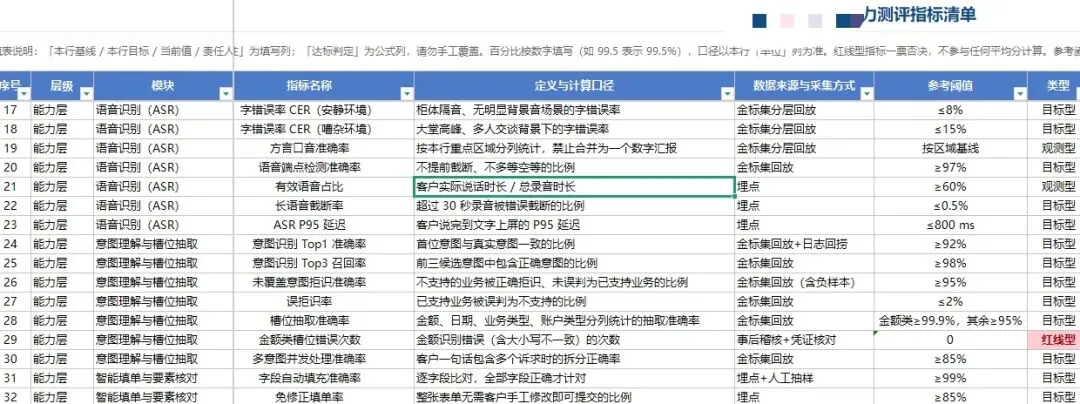
黄金数据集(Golden Dataset) 1)人工标注的 50-100 组“完美案例” 2)覆盖主流场景 + 边界场景 3)作为每次回归测试的基准 影子数据集(Shadow Dataset) 1)从线上真实使用中采样(脱敏后) 2)持续扩充,每月更新一次 3)用于发现“训练集没覆盖到的新问题” 对抗数据集(Adversarial Dataset) 1)专门构造的坏样本 2)用于测试 Agent 的鲁棒性 3)每次版本发布前必须跑一遍 五、Eval 结果的呈现方式,给一张诊断图,不单单只是数据: AI 项目的 Eval 不是“给 AI 打分”,而是“给系统装仪表盘”。没有 Eval,我们就像在黑夜开车没有仪表盘——你不知道速度、不知道油量、不知道发动机温度,只能凭感觉说“好像还行”。如上的原则可以使我们把 Eval 从“玄学”变成“工程”:分层、多维、人机协同、对抗、可追溯、渐进。同时永远保留人工抽检的权利——AI 可以帮我们评 100%,但我们至少要亲自看 10%。 那测试与测评的区别呢?下次在详细对比分析。 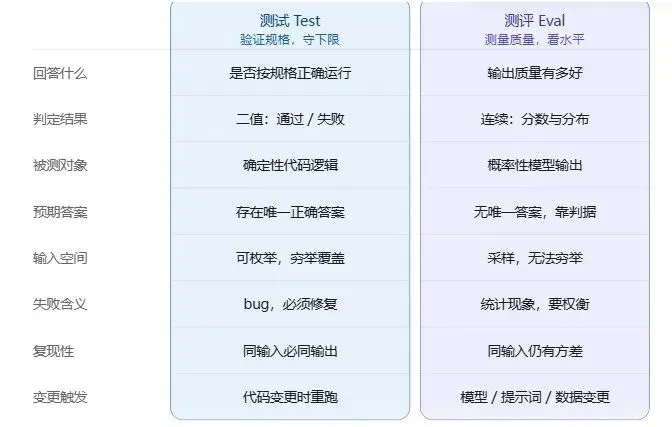
#AI项目中的Eval #AI应用
本文来自网友投稿或网络内容,
如有侵犯您的权益请联系我们删除,
联系邮箱:wyl860211@qq.com 。
