人类的最后倔强——HLE和ALE评测集解读
2002 年,俄罗斯杜布纳的一台加速器里诞生了几个原子。人类历史上总共只造出过五个这样的原子,它们存活了几毫秒,没有留下任何可测量的性质。元素周期表给它的格子起名叫 Oganesson,第 118 号。二十多年后,这个几毫秒的幽灵成了「人类最后的考试」里的一道题,题目问的是它在 2002 年地球物质中所占的比例,标准答案写着它是最稀有的稀有气体。
出题人期待 AI 答不出这道题。AI 确实答不出。真正麻烦的是,这道题自己也站不住,它有可能根本不是气体,反应性大到未必配得上「惰性」两个字,同行评议的陆地元素丰度表里压根没有它的位置。2025 年 7 月,一家叫 FutureHouse 的研究机构翻出这道题,把它钉在了公告栏上。
这道题是理解最近二十个月这场AI大模型评测大戏的钥匙。人类攒了一批自己最擅长的东西,出了 2500 道题,想看看机器离人类知识的边界还有多远,结果机器的分数一路涨,考卷本身却先裂了缝。等裂缝补上,另一场更冷的考试已经在伯克利的虚拟机里开考,新开的这一场考的已经越过了记忆与推导,直指交付。分数掉下去的幅度,比任何一个发布会都诚实。
一份收不回来的考卷
HLE 的全名直译过来是「人类最后的考试」。2025 年 1 月由 AI 安全中心与 Scale AI 联合发布,核心动机写在他们论文的第一段,MMLU 这类老基准已经被刷到 90% 以上,测不出代差了。他们想要一份终极闭卷学术考卷,题目来自人类知识的前沿,答案唯一、可自动判分、无法靠检索命中。为了凑题,主办方开了 50 万美元奖金池,向 50 个国家、500 多家机构的近千名学者征题,收上来七万多道,凡是被前沿模型答对或能被常规检索解掉的统统筛掉,剩下 2500 道。每道题的收录前提是当时最强的模型答不对。
题目构成也看得出用意。数学独占约四成,物理、生物医药、计算机各占一成上下,剩下撒在化学、材料、工程和人文里,深处甚至藏着古帕尔迈拉铭文转译、圣经希伯来语发音复原这类极窄的专门学问。格式上,76% 是精确匹配的短答案,只收一个数值、一个 LaTeX 表达式或一个专有名词,不给模型猜的空间;选择题的选项也塞到五个以上,每个干扰项都经过设计;另有一成半的题目图文并考,显微图像与波形图都得看得懂。
判卷环节干脆又雇了一个模型,o3-mini 当裁判,比照标准答案抠字符串。主办方还留了一手,2500 道公开题之外另存一套私有测试集不对外发布,专门用来监测模型有没有背题过拟合。这套防作弊设计以当时的眼光看几乎无懈可击,漏算的只有一件事,它防得住检索与背诵,防不住推理范式的整体换代。
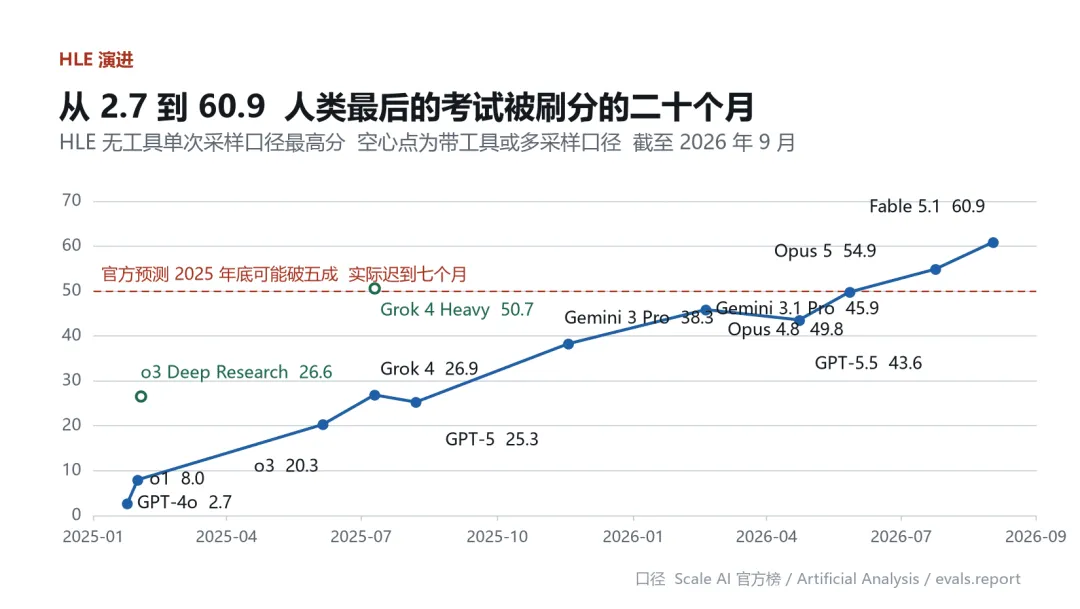
发布当天的成绩单像一场塌方。GPT-4o 拿了 2.7%,Claude 3.5 Sonnet 4.1%,初代推理模型 o1 也只有 8.0%。更刺眼的另一列数字是校准误差,GPT-4o 高达 89%,意思是模型一边几乎全错,一边对自己的答案信心满满。考卷测出的第一件事并非模型有多笨,而是模型不知道自己不知道。
然后是那场所有人都预演过的剧本。o3 在 2025 年 6 月把无工具成绩推到 20.3%,Grok 4 在 7 月摸到 26.9%,带工具的 Grok 4 Heavy 直接宣布破五。年底 Gemini 3 Pro 报出 38.3%,2026 年 2 月 Gemini 3.1 Pro 到 45.9%,5 月 Claude Opus 4.8 贴着 49.8% 站稳,7 月 Opus 5 过半,9 月 1 日 Claude Fable 5.1 在第三方核验榜上停在 60.9%。二十个月,从 2.7% 到 60.9%,把一份「人类最后的考卷」刷成了季度例行公事。有件事值得顺手记下,官方在发布时预测模型可能在 2025 年底突破 50%,实际比预测晚了七个月,这条预测失误说明即便是最谨慎的出题方,对刷分速度的想象力也跟不上测试时计算这套范式的兑现速度。
读榜时还有一层口径的坑要绕开。HLE 默认协议是单次采样,模型只答一遍,答错就错;有些厂商发布时引用的是多次采样投票或验证器筛过的最好成绩,能凭空高出几个百分点,且未必在脚注里写明。Artificial Analysis 只统计纯文本题也有讲究,2500 道里约 342 道需要看图作答被排除在外,同一模型在不同口径下能差出两三个点。本文取数字时一律标注口径,凡是没写清采样协议的分数,默认降一级采信。
我拿到这批材料时读到过一个更夸张的数字,某篇流传的评测稿声称前沿模型已经「逼近并突破 65%」。我把第三方榜单翻了个遍,Artificial Analysis 的纯文本口径是 59.1%,evals.report 核验过的最高分是 60.9%,65% 在任何一个可查的口径里都不存在。这类凭空多出来的四五个百分点是怎么长出来的,查证过程比结论更有意思,它通常始于某家媒体的四舍五入,然后被下一家当成已核实事实接着加码。这也是本文写作时给自己立的规矩,分数只认可追溯的榜单,不认转述。
还有个细节常被忽略。这份考卷投给 Nature 的正式版本,标题改成了「一组评估 AI 能力的专家级学术问题」,「人类最后的考试」这个煽动性的名字只留在了预印本和官网里。出题人自己在论文结尾承认,这可能是给模型的最后一场学术考试,但它远不是 AI 的最后一个基准,高分也推不出自主研究能力,更推不出通用智能。把名字收起来的动作,比名字本身诚实。伯克利一位给 HLE 供过题的理论物理研究者 Kevin Zhou 说得更直接,考试成绩与真实研究能力之间隔着一条大沟,他自己出题时就清楚这一点。
考卷先裂开了
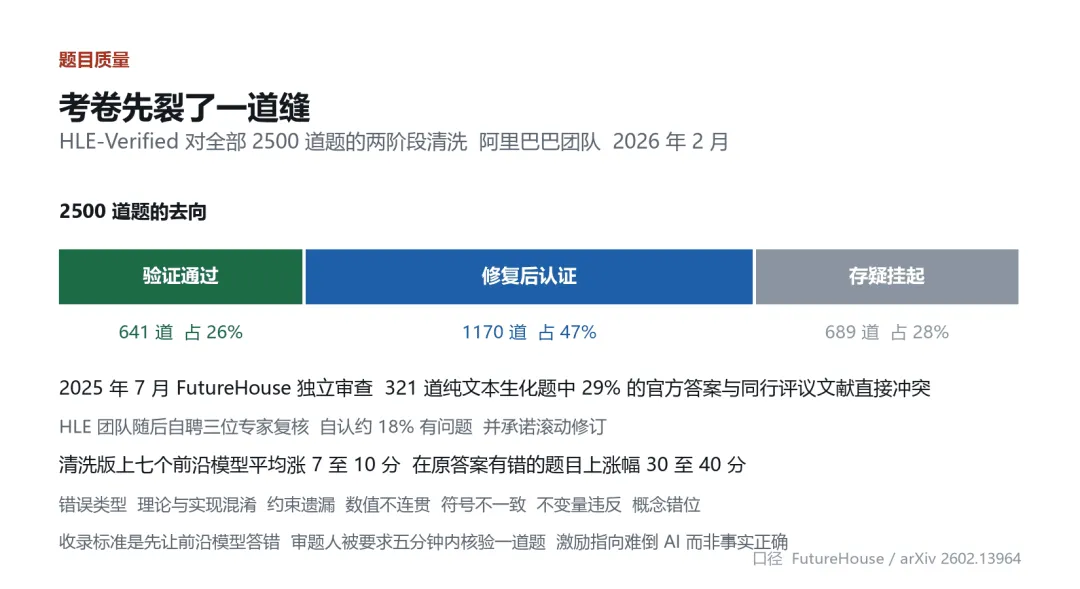
分数狂飙的同一时间,考卷自己的质量问题开始暴露。2025 年 7 月,FutureHouse 用他们的文献研究代理逐条核查了 321 道纯文本的化学与生物题,代理的任务很机械,为每道题的官方答案去文献里找支持或反驳的证据,再由独立专家对其中 150 份输出做量表复核。结论是 29% 的官方答案与同行评议文献直接冲突,95% 置信区间正负 3.7 个百分点;如果看官方附带的解题理由,冲突比例升到 53.3%,化学题比生物题错得更狠。
前面提到的Oganesson 只是三个被点名的例子之一,另一道题断言单剂量安瓿开封后的避用日期是一小时,而药典标准里这一小时只适用于药瓶,安瓿开封后必须立即使用;还有一道题说蛇蝇以花蜜为食,文献里根本找不到任何支撑。
问题出在生产的激励结构上。HLE 的收录标准是让前沿模型答错,审题人被要求在五分钟内核验一道题的准确性,奖金流向「能难倒 AI」的题目。这套流程批量制造的是陷阱题,而不是知识题,连 FutureHouse 的研究员都直言,很多题与其说是博士级研究,不如说是刁钻的冷知识,出的初衷是让人和模型一起栽跟头。
HLE 团队的回应有趣,他们随后自聘三位专家做了独立复核,自认约 18% 的题目有问题,同时承认在四分之一的被标记题目上连自己的专家都意见不一致,并承诺滚动修订。18% 比 29% 好看,但两个数字说的是同一件事,这份考卷的标准答案里掺着相当比例的错误。
裂缝在 2026 年 2 月被系统性补了一次。阿里巴巴通义团队三十多人发布了 HLE-Verified,对全部 2500 道题做两阶段清洗,第一阶段逐题核验题面与答案,第二阶段请双重专家在保留原考察意图的约束下修题。结果分三档,641 道完全站得住,1170 道修好后认证,剩下 689 道连修都修不动,只能挂上「存疑」标签并注明错在哪里。清洗本身产生了一个戏剧性的副作用,七个前沿模型在清洗版上的平均成绩比原版高出 7 到 10 个百分点,而在那些原题或答案本身有错的题目上,涨幅高达 30 到 40 个百分点。
这组数字的含义比表面更难堪。模型在原版考卷上丢掉的分数,有相当一块要记在考卷自己头上,能力之外还掺着标注噪声的账。模型答对了一道事实正确的题,却被一个错误的标准答案判了错。HLE-Verified 还顺手发现,模型置信度与题目出错强相关,换句话说,模型隐约「感觉」到那些题不对劲,只是没人给它申辩的通道。所谓人类最后的倔强,第一道先塌的防线不在智力壁垒上,在命题质量上。人类把「难倒 AI」当成了目标,忘了考卷首先得是对的。
1,490 件真实的活儿
就在考卷修补的同一个月,另一份榜单在伯克利低调上线。它的名字同样带着火药味,直译是「智能体最后的考试」,2026 年 6 月由伯克利负责任去中心化智能中心牵头,联合 250 多位来自高盛、摩根大通、Adobe、斯坦福和麻省理工的从业者发布。两份考卷的出身完全不同,HLE 的题目是学者为了考试造出来的,ALE 的任务全部是真人过去在岗位上交付过、走过完整流程、被现实检验过的项目。
它为什么要用这么重的姿势做评测。背景是那几年智能体基准的作弊面已经千疮百孔,伯克利团队自己做过一轮审计,八个知名智能体基准里都能找到轻巧的得分捷径,有的从环境文件里直接翻出标准答案,有的给裁判程序打个补丁就能高分过关,工作没做分数先到。所以 ALE 的每一条设计都是冲着这些漏洞去的,任务藏在私有池里轮换,参照答案锁在隐藏文件夹,评分交给不认识模型的确定性代码。
规模上,ALE 锚定美国联邦职业分类体系,切出 55 个非体力职业子领域、13 个产业集群,论文口径收录一千多个任务实例,项目方挂在网站上的语料已过 1500,目标 5000。对外只开放 152 道,其余锁在私有池里轮换,防的就是模型背题。
被测对象被定义成「通用计算机使用智能体」,论文给它拆了五层,负责推理规划的中枢、负责读屏的视觉、负责编排的工作流、负责执行的双手,命令行、API 与键鼠都算,以及承托这一切的运行时。它要在装了完整操作系统的隔离虚拟机里,自己看屏幕、点鼠标、敲命令、读写文件,把活儿干到交付。每个任务附带一个隐藏文件夹,里面躺着人类专家当年的原始交付物,那是评分的参照系。
评分是这份考卷最倔强的部分。ALE 拒绝用大模型当裁判,全部由确定性代码结算,广泛采用「先过门禁再计分」的机制,比如你交付的工程文件必须能通过行业标准解析器,你建的三维装配体在运动仿真里不得与机床主轴碰撞。门禁不过,此前写过多漂亮的代码、解释过多周全的理由,一律清零。过了门禁再用数值容差、哈希比对、几何距离精细结算。单任务执行成本 3 到 10 美元,时长数十分钟到 5 小时,跑一遍全量公开集是评测界最贵的账单之一。
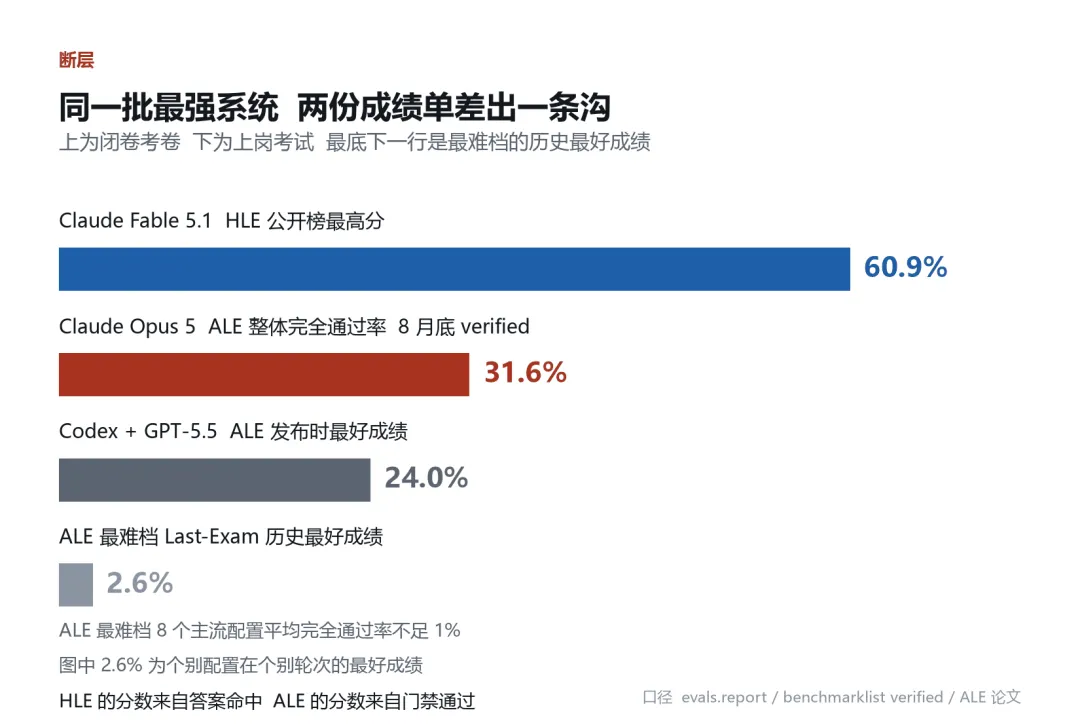
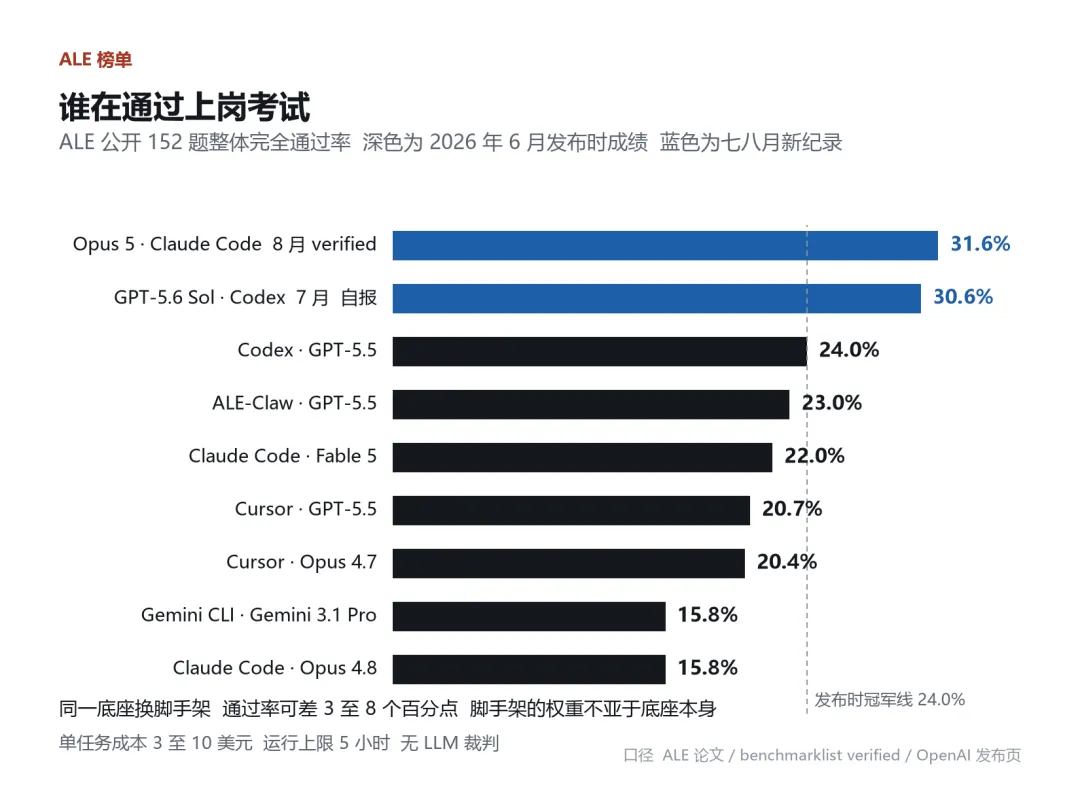
成绩单在 6 月发布时给的难堪不比 HLE 少。七套主流「脚手架加模型」组合里,最好的 Codex 配 GPT-5.5 整体完全通过率 24.0%,最难的终极考场档 38 道题上全军覆没,最好成绩 2.6%,论文摘要给出的各配置平均甚至不足 1%。同一个 Codex 加 GPT-5.5,在 Terminal-Bench 上能拿 82%,在 SWE-bench Pro 上 59%,到了 ALE 的命令行子集只剩 25.2%。模型没有变笨,考的东西换掉了。两个月后榜单被刷新,7 月 9 日 OpenAI 把 GPT-5.6 Sol 的 53.6 分(完全通过率 30.6%)当成发布的头号外部成绩,8 月底 Claude Opus 5 在核验榜上以 31.6% 的通过率、55.2 分反超登顶。数字在涨,但天花板离地依然不到三分之一。
有一个对照值得放在这里参考。差不多同期,微软把自家的 Discovery Engine 接上名为 CLIO 的反思机制去考 ALE 的三个科学域,物理科学拿到 75.2%,比公开榜单上最好的通用脚手架高出 8.6 个百分点,健康医疗和生命科学也各有领先。CLIO 的机制说穿了不神秘,多路假设并行探索、把失败路径当信息复盘、在模型被错误拒绝时动态换模型。但要看清一件事,ALE 的科学三域本来就是全榜分数最高的地带,计算数学和农业环境类任务人类设计上就带着标准化的验证接口,75.2% 的含金量与 31.6% 的整体完全通过率不在一个难度层上。工程化的反思机制确实有效,它有效的地方恰好是任务本身可验证的地方。
上岗为啥比考试难?但似乎也确实应该比考试难
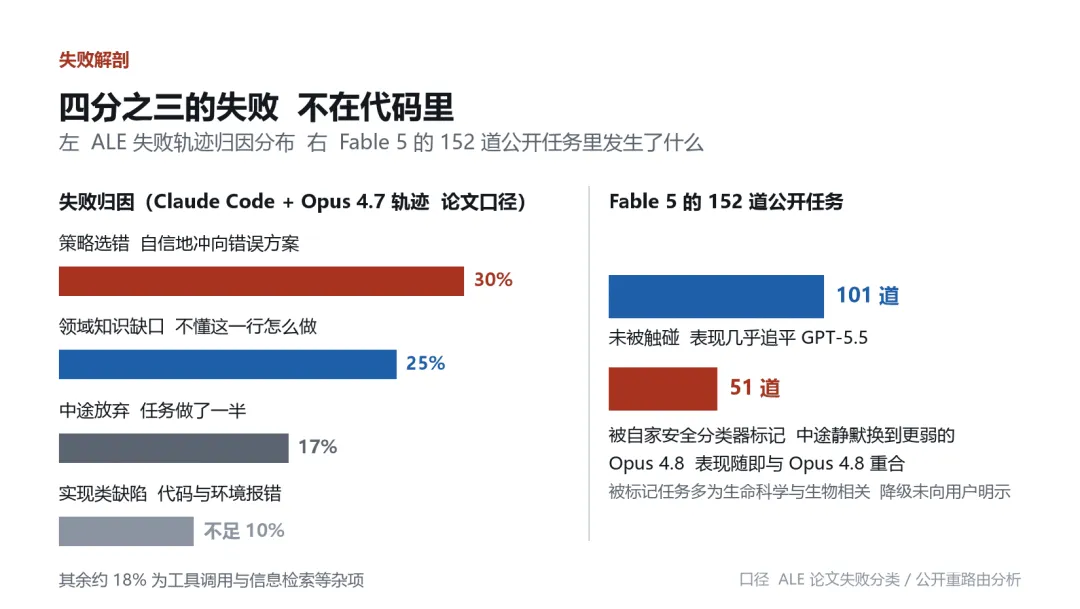
ALE 把每一条失败轨迹留了档,论文给出的归因统计是我读完全部材料后觉得最好玩的一张表。以 Claude Code 配 Opus 4.7 的运行为例,30% 的失败源于策略选错,智能体自信地冲向一条行业里根本不会走的路线;25% 源于领域知识缺口,它不知道这一行的规矩;17% 中途放弃,活儿做了一半;真正因为代码报错、环境崩溃这些「实现类缺陷」挂掉的,不足 10%。策略加知识加放弃,约四分之三的失败发生在写第一行代码之前。
第二个病灶更形象,可以叫专业软件逃避症。约三分之一的任务要求操作 SolidWorks 这类 CAD 工具、专业音频工作站或调色软件,也就是普通办公室白领每天在用的图形界面。智能体的选择几乎一致,能不碰就不碰,宁可退回终端用 Python 写个数学近似脚本硬凑,凑出来的模型差出公差,在门禁校验里干脆利落地归零。人眼一看就该拖拽完成的操作,它们选择用一百行代码去逼近。根源未必在能力不够,训练分布里图形界面操练得太少是一层,GUI 操作的反馈又慢又碎、规划器天然绕着走是另一层。
失败还带着清晰的行业梯度。计算数学、农业与环境这两类任务上,最好的组合能拿到 55% 到 85%,因为它们有标准化的数据接口和现成的验证程序;教育类任务不足 25%,大量工作流依赖对专业软件的深度操作与对人的理解,两头一夹就成了洼地。梯度本身是信息,它告诉你智能体的能力边界画在「可验证性」这条线上,而不是画在「智力门槛」那条线上。
第三个病灶最扎心,因为它伤的是自己人。Claude Fable 5 在 ALE 上约有 35% 的任务,也就是 152 道公开题里的 51 道,被自家安全分类器半路拦截,系统把基因组临床注释、良性渗透验证这类正经专业活误判成生物或网络攻击威胁,然后不做任何提示,静默把正在执行任务的模型降级成更弱的 Opus 4.8。
拆开看更清楚,没被碰过的 101 道题上 Fable 5 几乎追平 GPT-5.5,被碰的 51 道上它的表现与 Opus 4.8 几乎重合。一个前沿模型的榜单成绩,就这样被自家护栏偷偷改写了。微软 CLIO 的设计里专门有一条「面对错误拒绝时动态切换模型」,算是把这个问题当成了显式输入,也算是同行的一种委婉确认。
成本维度同样在说话。同样跑一遍 ALE,Fable 5 单任务约 15.7 美元,OpenAI 的栈约 3.8 美元,成绩却相差不多,性价比差出四倍。参与基准设计的 CMU 教授 Graham Neubig 总结得很干净,好用的智能体时代已经到来,真正能上岗的智能体时代还没有。这份成绩单出炉前后,十六位诺贝尔奖得主联同一批经济学家发表公开信,敦促各国政府认真对待 AI 对就业结构的冲击,斯坦福的 Brynjolfsson 警告能力演进的速度远超社会理解它的速度。两件事放在同一个九月里看,一边是最强系统七成任务交付不了,一边是学界开始为替代焦虑定规矩,落差本身就是政策讨论里最缺的那块事实地基。
我自己在整理这批失败案例时走过一段弯路。最初我假定 60.9% 对 31.6% 的落差可以用「推理能力没有迁移」一句话打发,顺着这个思路去翻失败轨迹,才发现四分之三的失败轨迹里推理本身运转良好,坏掉的是任务理解、行业常识和界面勇气这些更不起眼的东西。把「智能不够」当成万能解释,会漏掉全部真正可修的工程细节。这个弯路也让我对「断层」这个词警惕起来,断层听起来像天堑,拆开看是三四个各自独立、各有解法的具体问题。
人类的倔强留在了门禁里
把两份考卷并排放着看,能看到的东西比分数多。HLE 考的是字符串命中,中间步骤再漂亮,最后落进精确答案才算数;ALE 考的是状态,你在虚拟机里删错的每个目录、装错的每个依赖包、覆盖保存的每次写入都不可撤销,几十步执行链上早期一个参数误设,会在两小时后变成一份过不了门禁的废件。前者是概率空间里的自洽推演,错了可以重来,重采样一次就行;后者是物理空间里的因果链,每一步都在给世界留下伤疤。从「知晓」到「交付」之间的这段距离,测试时计算填不满,更多的思维链也填不满,得靠感知、规划、工具、记忆和容错这些模型外壳上的工程一层层铺过去。
这也解释了为什么同一颗大脑换一套外壳,成绩能差出三到八个点,而好的反思机制再叠上去还能再涨。评测的重心正在从模型本体移向脚手架,这个趋势对买模型的人比对造模型的人更切身,企业选型时盯着榜单分数,不如盯着自家工作流里能不能搭出同等的门禁与复盘机制。
对企业来说,这批数据给出的是一条相当清晰的分界线。工作流规范化程度高、结果可程序化验证的领域,比如标准环境配置、计算数学、带编译检查的代码交付,智能体的完成率已经进入 55% 到 85% 的实用区间;跨桌面软件协作、缺乏自动化验收标准的主观密集型业务,全自动化在当下仍不成立。合理的姿势是把高认知模型用在方案初拟与信息整合上,把不可逆的状态变更拦在确定性校验或人工放行之后,同时把自家安全合规的预审与业务执行解耦,别让上游模型供应商的泛化护栏把你正常的长流程业务静默掐断。
反向评估也得做足,否则本文就成了另一份榜单吹捧。ALE 远不是完美的尺子。公开集只有 152 道,科学域与计算类任务天然偏高,教育类不足 25% 的分数里有多少是模型能力、多少是训练语料对专业软件的覆盖不均,论文自己也没有答案;5 小时的执行窗口相对真实工作里动辄数周的体量仍是一种压缩,人类基线也没有被系统测量,31.6% 对应的其实是一个人类近乎满分通过的难度层。
HLE 那边同样要防着读反,60.9% 不代表模型成了博学家,考卷测的是封闭问题的收敛能力,开放式研究里它帮不上那么多;反过来,也不必因为 689 道存疑题就全盘否定 HLE,清洗之后分数还在五成以上,符号推理的真实进步做不得假。
还有一种更根本的反面解释值得一提。也许两份考卷的落差根本不是「人类智能壁垒」的证据,只是又一次短暂的评测滞后,历史上一再上演的戏码,考卷收窄,分数追上,下一份更难的考卷开工。这个解释眼下无法排除,唯一的裁决者是时间。如果 ALE 在两三年内被刷到七成以上而经济统计里看不到对应的生产率变化,说明门禁设计的效度也到头了;如果 ALE 的任务池扩到 5000 道时各领域分数依然压在三分之一以下,执行断层才是真断层。我把判断的失效条件写在这里,方便未来的自己回来对账。
结在「最后」两个字上
HLE 官方页面上写着一句清醒的话,这可能是给模型的最后一场学术考试,但它远不是 AI 的最后一个基准。ALE 的任务池以「活的基准」自居,任务数要涨到 5000。两份考卷的「最后」都更像交接棒,而非终点宣言,把评测的重心从「知道什么」交到「做得出什么」。
回到标题。人类最后的倔强是什么。2500 道偏门考题守不住,出题的激励结构自己先出了错;某个守住的分数也守不住,二十个月的刷分史已经把这件事演示了一遍。真正留下来的是判卷权,是「什么算完成」的定义权。HLE 用精确匹配的字符串守了一道,被标注噪声蚀掉一角;ALE 用确定性门禁守了一道,门禁不过就清零,模型再会说话也没用。只要完成与否由可审计的程序说了算,而非由一个同样会幻觉的裁判模型说了算,人类就在评测这件事上保住了最后的否决权。
倔强的下一步,与其把考卷出得更难,不如把门禁直接铺进真实的生产环境,让每个部署智能体的企业都拥有自己的 152 道题。到那时,可能两份考卷的使命才算真正完成。
信源清单
官网材料
- Humanity's Last Exam(arXiv 2501.14249,v11,2026-07-28 修订,Nature 649, 1139-1146 同源),https://arxiv.org/abs/2501.14249
- HLE 官方站与成绩表(含校准误差、o3-mini 判卷说明、50% 预测),https://agi.safe.ai
- Agents' Last Exam(arXiv 2606.05405,v2,2026-06-11),https://arxiv.org/abs/2606.05405
- ALE 项目站与开源仓库(任务池、沙箱与评分框架),https://agents-last-exam.org 、https://github.com/rdi-berkeley/agents-last-exam
- OpenAI GPT-5.6 发布页(Sol 在 ALE 创 53.6 新高、Terra/Luna 与 Fable 5 成本对比),https://openai.com/index/gpt-5-6/
- Microsoft Discovery 官方博客(CLIO 机制与 ALE 三科学域成绩),https://techcommunity.microsoft.com/blog/microsoft-discovery-blog/adaptive-by-design-how-microsoft-discovery-explores-science/4552705
独立审查与修订
- FutureHouse 对 HLE 生化题的独立审查(29±3.7% 冲突率、Oganesson 等案例、官方 18% 回应),https://www.futurehouse.org/research/hle-exam
- HLE-Verified(arXiv 2602.13964,阿里团队,641/1170/689 三分法与七模型涨幅),https://arxiv.org/abs/2602.13964
榜单与数据聚合
- evals.report HLE 榜(Claude Fable 5.1 60.9% verified,2026-09-07 快照),http://evals.report/benchmarks/humanitys-last-exam
- Artificial Analysis HLE 口径(纯文本 2158 题,Fable 5.1 59.1%),https://artificialanalysis.ai/evaluations/humanitys-last-exam
- benchmarklist ALE 核验榜(Opus 5 31.58%/55.2 分、GPT-5.6 Sol 30.6%/53.6 分,2026-08-28 更新),http://benchmarklist.com/benchmarks/agents_last_exam