Agent 多层评测体系
- 更新时间 2026-09-28 08:16:22
LLM与Agent评测区别
维度 | LLM 评测 | Agent 评测 |
评测对象 | 模型本身 | Agent 系统(模型 + 工具 + 环境) |
输入 | 单个 Prompt | 初始任务描述 + 环境状态 |
输出 | 单次文本回复 | 多步轨迹(Trajectory)+ 最终结果 |
成功标准 | 单次回答质量 | N 步后的正确终态 |
错误类型 | 单步错误 | 复合错误(早期错误逐级放大) |
评测单位 | 单条打分 | 整条轨迹 + 每一步的质量 |
环境 | 无状态(Stateless) | 有状态(Stateful),需要沙箱重置 |
方差 | 低(单次调用) | 高(长链、分支路径) |
为什么普通 LLM 测试在 Agent 上会失效?
Agent 的决策是时序的,错误会指数级放大
一个 LLM 调用产生一次输出。评估它很简单:给一个输入,检查输出质量。
但一个 Agent 系统产生的是一条决策链。每一步的输入取决于上一步的输出。
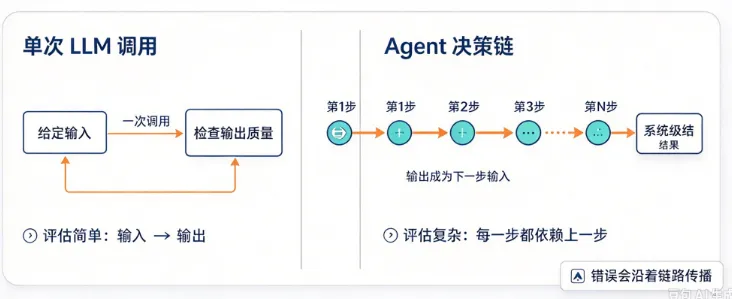
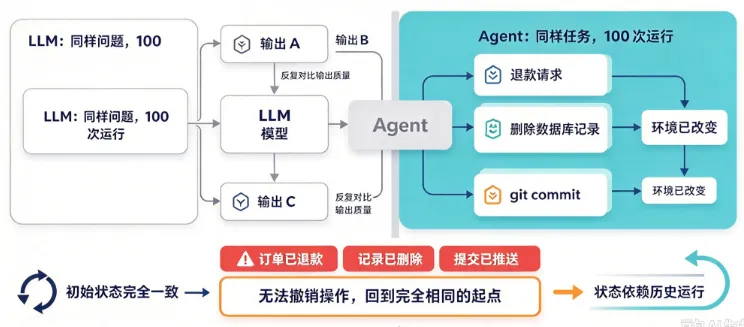
Agent 会改变外部世界状态,无法"撤销重测"
给一个 LLM 模型输入同样的问题 100 次,你可以反复对比输出结果,每次的初始状态完全一致。
给一个 Agent 同样的任务 100 次呢?
第一次运行,Agent 发出了一个退款请求、删除了一条数据库记录、推送了一行 git commit。第二次运行,环境状态已经变了——那个订单已经退过款了。你无法"撤销"这些操作,回到完全相同的起点。
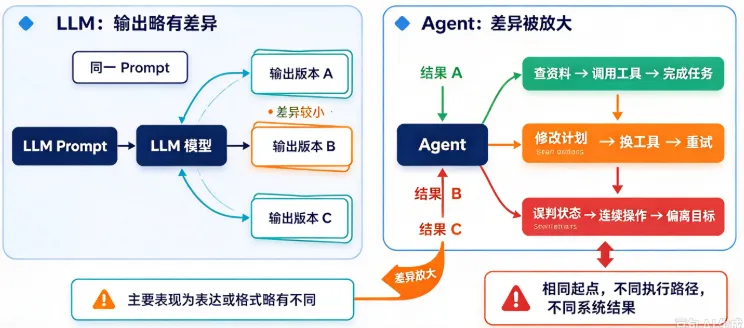
非确定性(Non-determinism)是 Agent 的默认行为
同一个 LLM 模型,同一个 Prompt,输出可能略有差异。但在 Agent 系统中,这种差异会被放大为完全不同的执行路径。
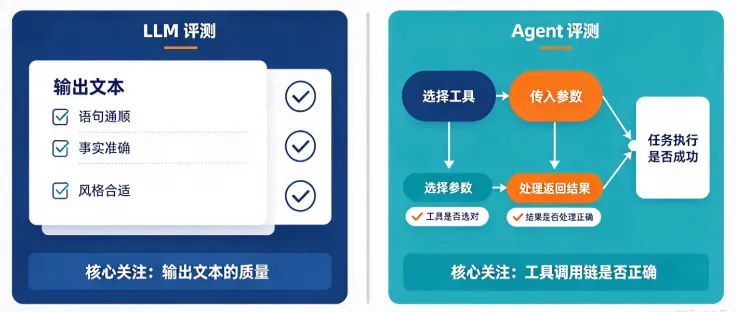
工具调用是 Agent 的优先选择,但 LLM 评测不考核工具
LLM 评测关心的是一件事:输出文本的质量——语句是否通顺、事实是否准确、风格是否合适。
Agent 评测关心的则是:Agent 是否选对了工具、传入了正确的参数、正确处理了工具返回的结果。
2026 年的行业共识:Agent 评测需要全新的评估框架
静态评测集与线上表现的相关系数已降至 0.3 以下——离线刷榜高分与用户体验几乎没有关系。
主流评测集的数据污染问题已不可忽视——MMLU、HumanEval 等数据已被大量纳入训练语料。模型在上面得 90%,不代表它能正确处理你们公司特有的审批流程。
Agent 评测必须从"刷榜驱动"转向"体验驱动"——评测体系需要覆盖全生命周期:从开发调试到生产监控。
我梳理出的多层评测体系
第一层:单步质量评测(复用 LLM 方法)
每一步输出的忠实度、相关性、安全性
用 LLM-as-Judge 进行自动打分
这一步是基础,但不是全部
第二层:轨迹质量评测(Agent 特有)
工具调用准确率:是否选对了工具?参数是否正确?
冗余调用率:是不是重复调用了同一个 API?
推理步骤合规性:Agent 的规划路径是否合理?
上下文忠实度:是否保持了多轮对话中的上下文一致性?
第三层:任务级评测(Agent 特有)
端到端任务完成率:最终目标达成了吗?
N 次运行一致性:同一个任务跑 N 次,成功的比例是多少?
完成效率:花了多少步?用了多少 Token?耗时多久?
第四层:生产级评测(Agent 特有)
线上退化检测:新版本是否比旧版本表现更差?
Trace 链路回放:线上失败的请求能否回放定位根因?
成本治理:Token 消耗、API 调用量的持续优化
