九月里新模型一款接着一款发,参数、榜单、演示视频轮番登场。想弄清哪款更适合自己,只看厂商自己的说法不够。这里介绍一个开源评测平台 OpenCompass,它用同一套题、同一套标准去跑不同模型,把「谁强在哪」落到一张可复现的表上。1它要解决的,是「没法公平比」
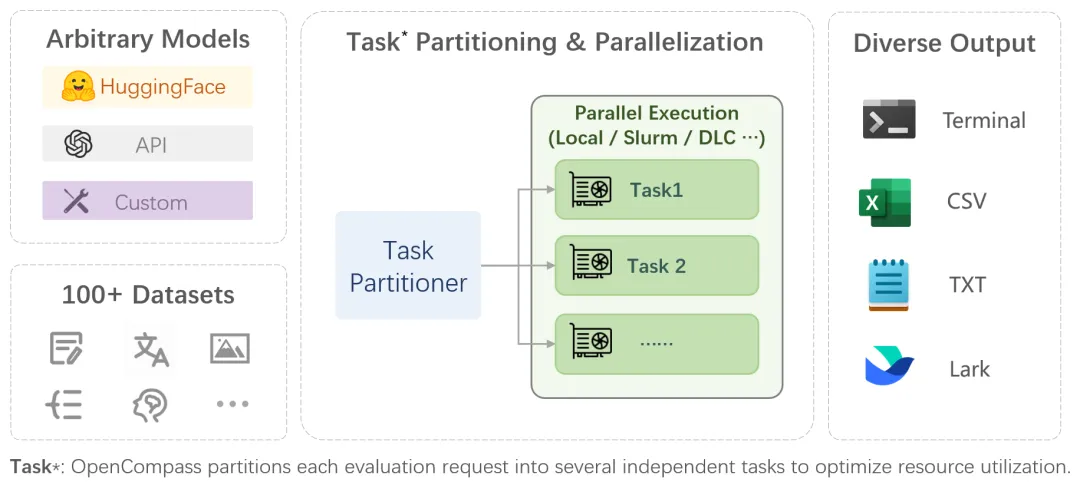
各家发布模型时,展示的基准、提示词、评测方式常常不一致,横向比较很难公平。OpenCompass 由国内研究机构联合维护,定位是一站式大模型评测平台,目标是让评测公平、开放、可复现。它预置了二十多款 HuggingFace 与接口模型、七十多套预设评测方案、约四十万道题,从知识、推理、代码、数学、中文几个维度给模型打分。
图:OpenCompass 官方架构图,把任意模型接入、数据集与任务切分、多种格式输出串成一条评测流水线。
2它在评测圈的分量
它推出的 CompassRank 榜单,把开源基准与闭源基准放进同一套框架排名,还被 Meta 在 Llama 的使用说明里列为验证工具。对想横向比较模型的人,这类榜单比单场发布会更接近「同一把尺子」。
| |
|---|
| 二十多款 HuggingFace 与接口模型,也支持自定义模型 |
| |
| zero-shot、few-shot、思维链,规则打分与模型打分两种 |
| |
| |
它还在往多模态延伸。近期它接入了视觉语言评测工具,能加载图文数据集,用统一的指标去跑多模态模型。也就是说,除了纯文本对话,图表理解、图文推理这类能力,也能放进同一套流程里比较。
对做产品的人,它的另一层价值是可复现。官方给了复现综合榜单的步骤,你可以用相同配置在自己的机器上重跑一遍,核对结论。多数时候,能复现比谁排前面更重要。
它的思路可以说得很直白:把评测的题目、流程、结果都摊开,别人能照着复现,结论才有讨论的基础。
3上手实操:跑通一轮评测
步骤一:建环境并安装conda create --name opencompass python=3.12 -yconda activate opencompasspip install -U opencompass步骤二:跑一轮评测opencompass --models hf_internlm2_5_1_8b_chat \ --datasets demo_gsm8k_chat_gen步骤三:评一个接口模型export OPENAI_API_KEY="你的密钥"opencompass --models gpt_4o_2024_05_13 \ --datasets demo_gsm8k_chat_gen步骤四:查配置与多卡并行python tools/list_configs.py llama mmluCUDA_VISIBLE_DEVICES=0,1 opencompass \ --datasets demo_gsm8k_chat_gen --hf-type chat \ --hf-path internlm/internlm2_5-1_8b-chat --max-num-worker 24一句提醒
榜单能帮你缩小范围,但替代不了自己试。你的任务未必是榜单里的题,模型在你数据上的表现,和它在通用基准上的分数经常是两回事。把评测当筛选工具,再拿小样本回测自己的真实场景,比盯着分数更有用。看榜单时有两个坑要避开。一是别只看总分,同一个模型在不同维度上各有长短,数学强的未必代码就强;二是留意题目版本,题集更新后,旧分数和新闻里的新分数未必能直接比。把这两点记住,榜单才真的帮得上忙。
小结OpenCompass 的价值不在给出一个定论,而在把公平比较这件事做成开源、可复现的工具。新模型越出越快,能自己动手跑一遍,比被动接受结论要稳。#大模型评测#开源工具#OpenCompass